2026 AI基建困局:路、油与交规如何重塑算力经济格局?
周期错配下的结构性矛盾
2026年7月,中国AI基础设施建设呈现出一种鲜明的“冰火两重天”景象。一方面,中央网信办印发深化IPv6技术创新实施方案,工信部加速推进《算力标准体系建设指南》,政策层面致力于构建长期稳固的网络底座与交易规则;另一方面,国内首座十万卡全链路国产AI超集群在郑州落成,而内蒙古部分已投产智算园区的综合利用率却不足五成。这种看似矛盾的现象,实则揭示了当前行业深层的结构性痛点。
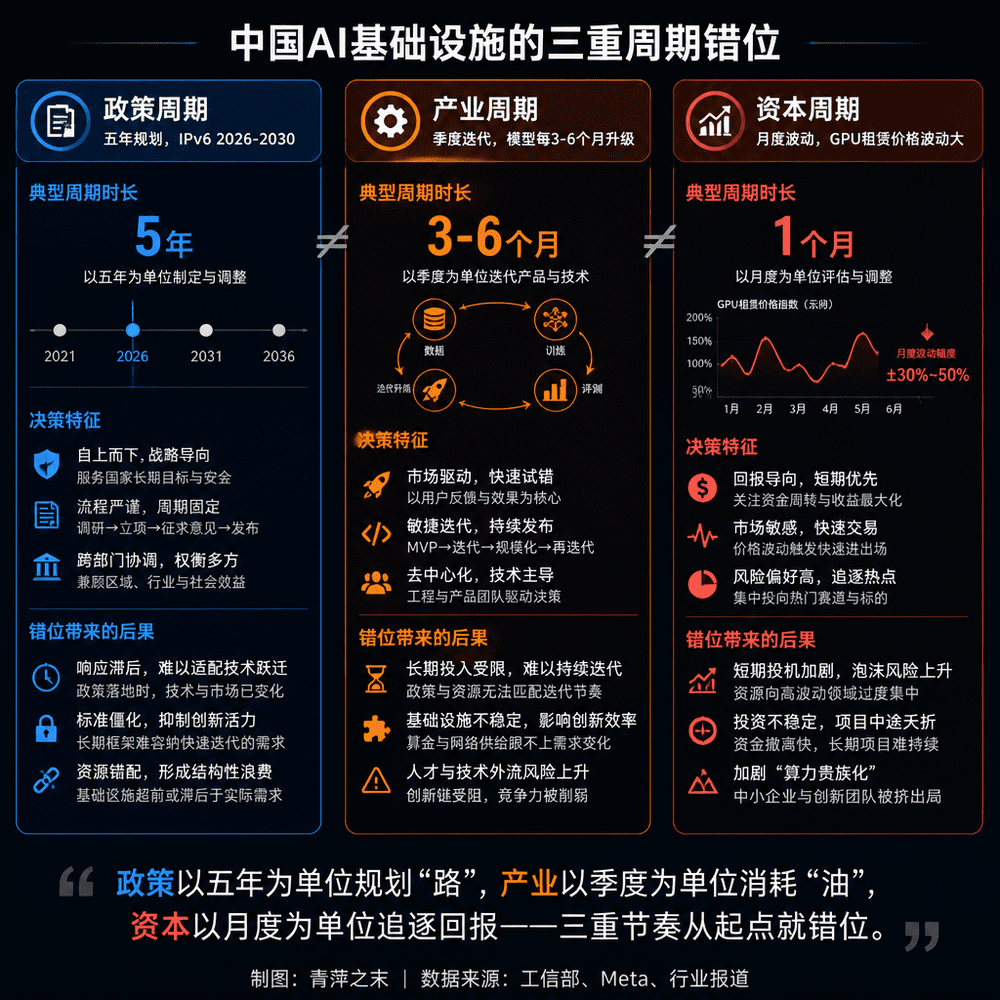
贯穿这一矛盾的核心线索,是时间尺度的严重错配。政策规划以五年为单位铺设“路”,而产业迭代以月为单位消耗“油”。当五年建成的智能高速网络,遇上季度更迭的大模型训练需求,以及按年计算的跨省调度机制协调周期,这种节奏的不兼容导致了资源的高效闲置与局部紧缺并存。IPv6解决的是技术上的连通性,即“能不能通”,但真正的挑战在于成本控制与制度流通,即“跑不跑得起”与“通不通顺”。
算力之“油”:从单卡性能到系统瓶颈
在探讨算力供给时,市场往往聚焦于芯片的总算力峰值,却忽视了更隐蔽的系统性瓶颈。在十万卡级集群中,制约大模型训练效率的关键并非单纯计算能力,而是由显存带宽(HBM)引发的“内存墙”效应。GPU大量时间处于等待数据状态,而非进行计算。
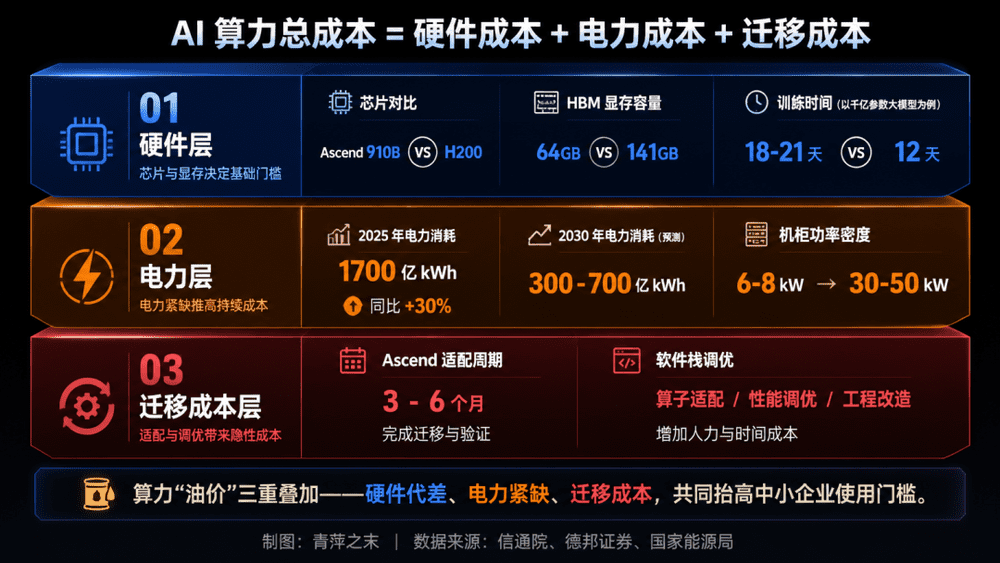
以昇腾910B与英伟达H200对比为例,两者在显存容量与带宽上存在约2倍的差距。这种代差导致国产芯片集群在训练时间上显著拉长。科大讯飞的管理层曾透露,在昇腾910B上训练大模型,通过深度调优可将效率从初始的30%提升至93%,但在复杂领域微调任务中,其性能可能仅为A800的50%-60%。这一数据不仅受测试框架影响,更折射出多机高速互联带宽、光模块、高速交换机及液冷配套等整条供应链的约束。
此外,能耗指标已成为比网络时延更前置的硬约束。随着数据中心用电量预计从2024年的1660亿千瓦时激增至2030年的数千亿千瓦时,传统风冷方案难以满足单机柜30kW至50kW甚至更高的功率密度,液冷技术正从可选项变为新建智算中心的隐性准入门槛。这种硬件层面的微观标准迭代,正在加速淘汰一批能耗偏高、密度不足的老旧算力集群。
制度之“交规”:跨省调度的隐形壁垒
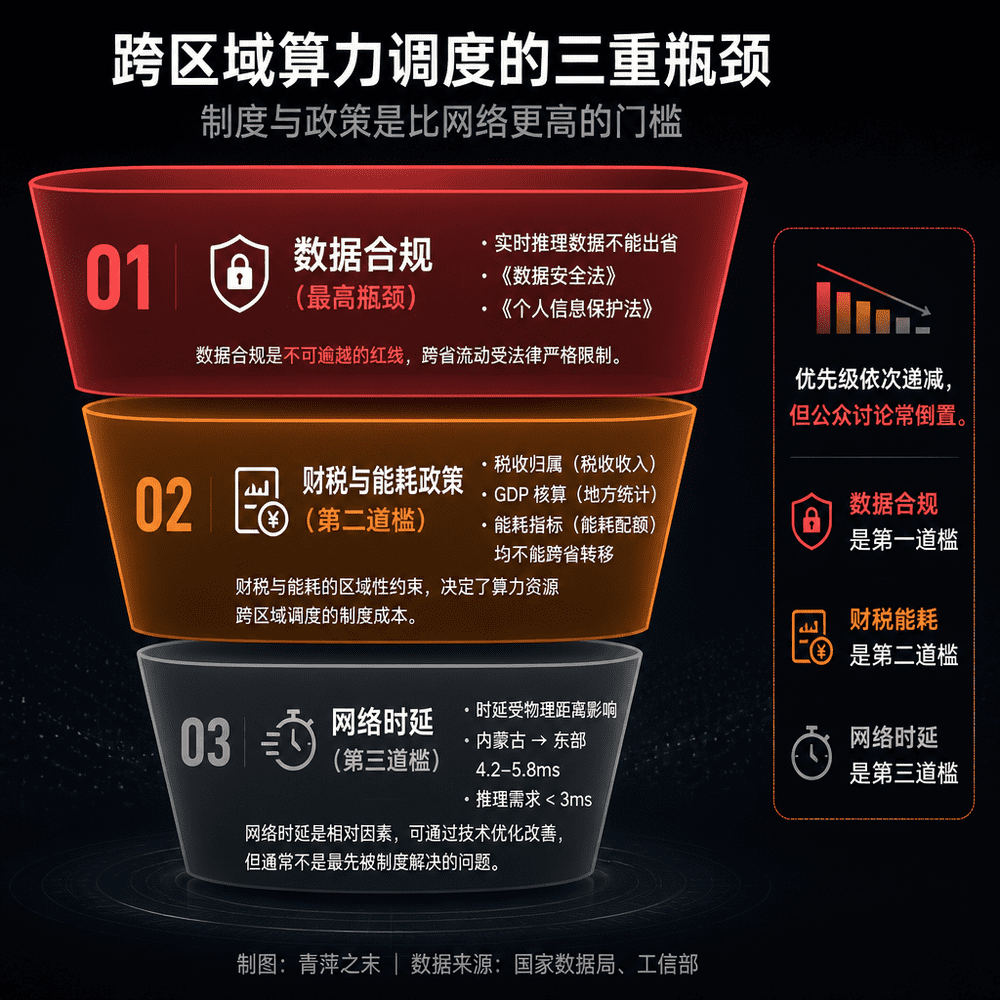
如果说网络底座是路,芯片是油,那么当前缺失的是一套让车辆在跨省道路上顺畅行驶的“交规”。IPv6和SRv6技术解决了协议层的连通性,但跨省税收留存、GDP核算、能耗指标分摊以及数据跨域流通规则,构成了算力调度的制度性障碍。
“东数西算”的理想模型是东部推理、西部训练,但现实面临多重阻碍。首先,西部绿电交易机制不健全,碳排放指标未单列,导致西部绿电难以高效输向东部数据中心。其次,数据属地监管要求成为更前置的门槛,许多东部实时推理业务的数据严禁出省,使得西部算力在根源上无法承接东部需求。
这种制度性割裂还体现在考核机制的偏差上。地方同质化建设智算园区的冲动,源于能耗指标属地化管理以及数字经济考核偏重机柜建设规模,缺乏对算力利用率、产业落地成效等后置指标的硬性约束。这种政策信号与执行层面的错位,导致了“西部晒太阳、东部买不到”的结构性资源浪费。
算力通胀与垄断分化的必然性
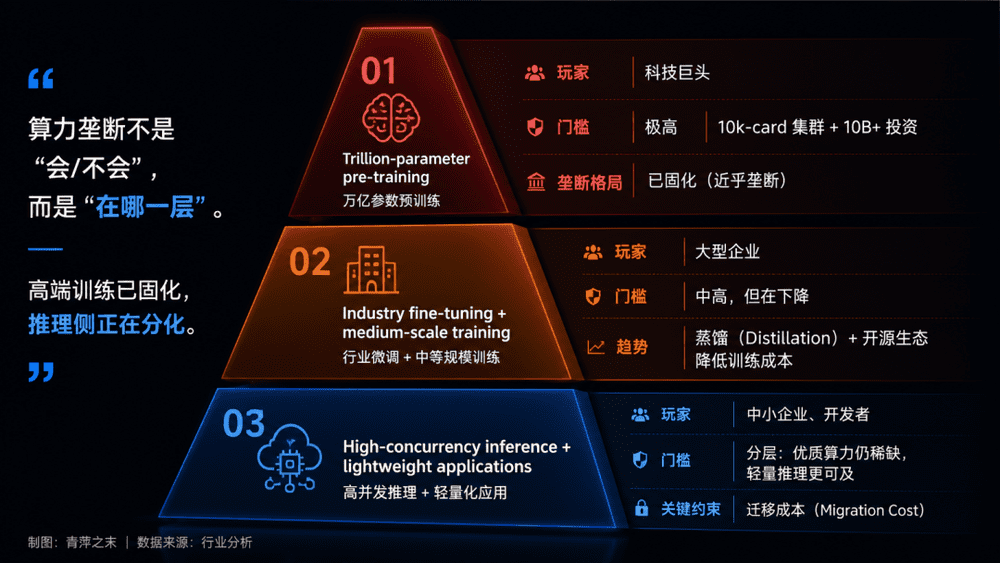
算力供给的扩张并未带来价格的全面下降,反而催生了结构性的市场分层。高端万亿参数级大模型的预训练,已成为巨头的游戏。中国最强模型参数规模与海外前沿模型相比仍有差距,且这一层级的竞争具有极高的规模效应壁垒。万卡级集群的边际成本远低于千卡级,巨头在单位算力成本上具备持续扩大的优势,数据规模与模型迭代速度形成正反馈闭环。
与此同时,异构算力交易平台宣称的“降本30%”往往伴随着高昂的适配成本。中小企业在昇腾等国产芯片上适配一套模型,可能需要额外的3至6个月工程时间。如果节省的租赁租金抵不上工程师的薪资成本,所谓的“普惠算力”便成为伪命题。
算力垄断的格局正在固化:高端训练算力呈现寡头垄断,短期内不可逆转;推理侧虽在分化,但优质实时推理算力依然稀缺。中小企业从推理侧向训练侧渗透的可能性极低。这种分层格局并非短期市场波动所致,而是由硬件物理极限、软件生态壁垒及资本开支规模共同决定的长期结构性特征。
生态突围:从硬件囤积到算法协同
面对算力紧缺,市场主体的理性选择往往是囤积硬件以获取短期租赁溢价,而非投入长期的算力调度优化。这种激励扭曲需要通过政策工具的强制纠偏来改变。算力券补贴、标准化交易结算、能耗指标倾斜等措施,旨在将市场的短期套利冲动引导至长期的生态建设。
《算力标准体系建设指南》的推进,试图解决异构芯片间的计量与定价难题。然而,强制推行统一的算力度量衡将触及各厂商的商业护城河,短期内容易沦为服务评估层面的博弈。真正的互操作性依赖类似CUDA的中间件生态,而这正是国产芯片最缺的软实力。百万级习惯了海外生态的AI工程师群体的转向,以及开发者习惯的重塑,需要漫长的周期。
中国AI基建的终局,表面上是路、油、交规的赛跑,本质上是一场生态突围战。无论是IPv6的演进、国产芯片的迭代,还是算力标准的统一,最终都要回答一个问题:我们能否在脱离海外单一生态依赖的前提下,建立起一套自洽、高效、具备商业闭环的中国AI底座?
结语与展望
真正拉开差距的,不是谁先建起更多集群,而是谁能在路升级、油补齐、交规理顺的三重节奏中,率先跑通从拼卡数量到拼Token产出成本的转型。在算力紧缺的上行周期,唯有通过政策引导与市场机制的有机结合,推动算力精细化调度,才能打破硬件囤积的惯性。
这场转型注定不会靠市场自发完成,它需要国资算力平台与大型科技企业在公共性与市场化之间找到平衡。答案将决定中国AI产业能否在2026年的关键节点,实现从被动跟跑到自主引领的对齐之日。路已铺就,油需补足,交规待立,最终的胜利属于那些能够率先构建起全栈自洽生态体系的先行者。