谷歌连发三款Lite模型,Pro缺席背后:AI算力效率与成本博弈新变局
效率至上:谷歌AI战略的务实转向
美国当地时间7月21日,谷歌DeepMind团队在人工智能领域投下了一枚重磅炸弹,一口气发布了三款全新的Gemini系列模型:Gemini 3.6 Flash、Gemini 3.5 Flash-Lite以及Gemini 3.5 Flash Cyber。这一动作不仅展示了谷歌在模型迭代上的高频节奏,更折射出当前大模型市场竞争焦点的深刻转移——从单纯追求参数规模与绝对性能,转向对算力效率、成本控制及垂直场景适配性的极致追求。
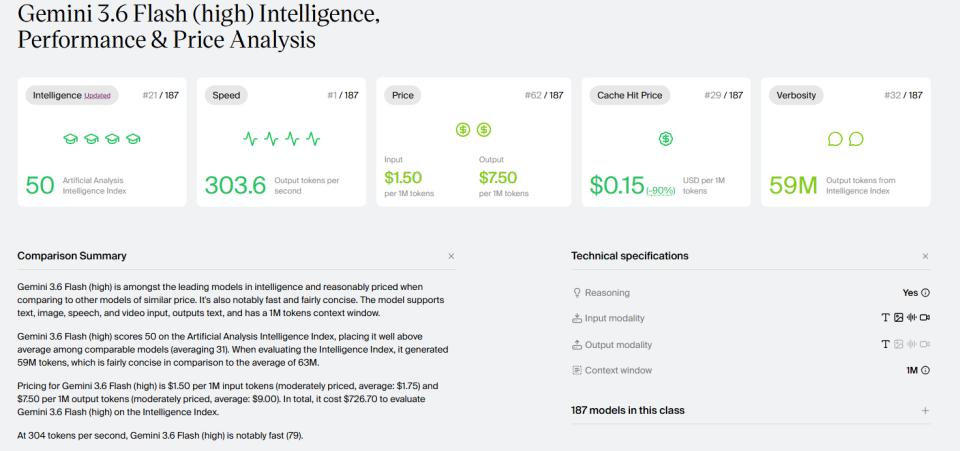
在这三款新模型中,主力军Gemini 3.6 Flash在编码和多模态任务上展现了显著增强,但更引人注目的是其效率指标。数据显示,该模型在处理相同工作量时,输出Token消耗较前代大幅减少了17%至65%。与此同时,主打极致速度与性价比的Gemini 3.5 Flash-Lite实现了每秒350个输出Token的生成速度,而Gemini 3.5 Flash Cyber则作为专用模型,聚焦于网络安全漏洞的检测与修复,目前仅对政府和特定合作伙伴开放。
值得注意的是,外界期待已久的旗舰级模型Gemini 3.5 Pro并未在此次发布中露面。谷歌方面表示,该模型正在与合作伙伴进行内部测试,并首次透露了更庞大的Gemini 4预训练工作已经启动。这一“缺席”与“前瞻”并存的局面,引发了业界对于谷歌研发管线节奏及未来旗舰性能走向的广泛讨论。
告别冗余:Gemini 3.6 Flash的效率革命
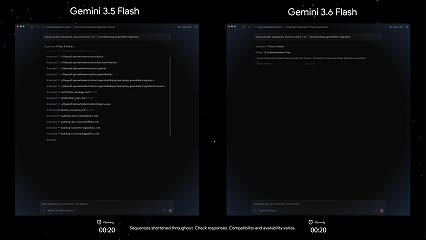
在大语言模型的商业化落地过程中,输出Token的数量直接决定了应用的费用与延迟。Gemini 3.6 Flash的核心设计目标之一,便是通过优化推理路径,降低不必要的Token消耗,同时保持甚至提升任务完成的质量。
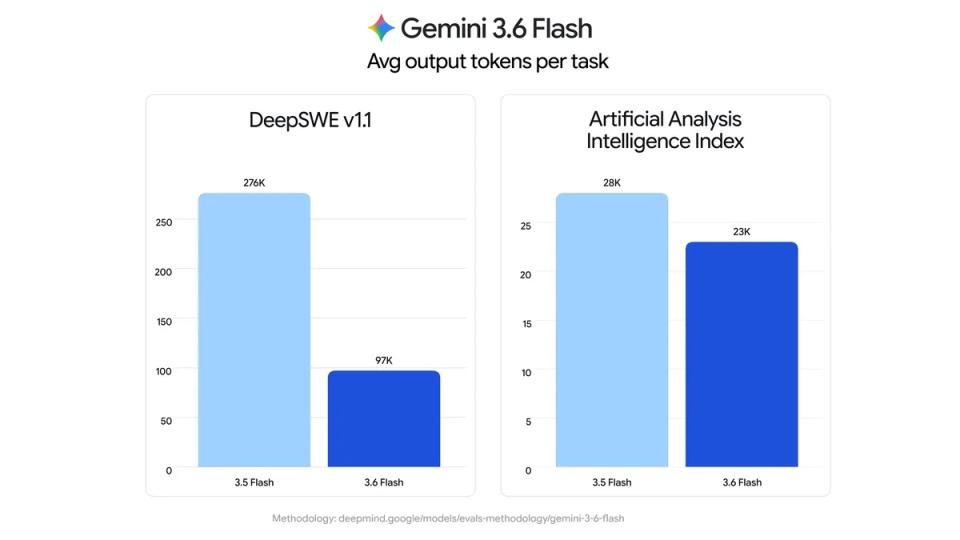
第三方基准测试机构Artificial Analysis Index的实测数据提供了有力佐证。Gemini 3.6 Flash的输出Token使用量较前代降低了17%。在涉及多步骤推理和工具调用的复杂工程任务中,这种节省效果更为惊人。例如,在Datacurve的DeepSWE基准测试中,Token消耗减少了65%。这意味着该模型在执行任务时,能够更精准地定位问题,执行更少的冗余代码编辑和循环操作,从而大幅提升了工程效率。
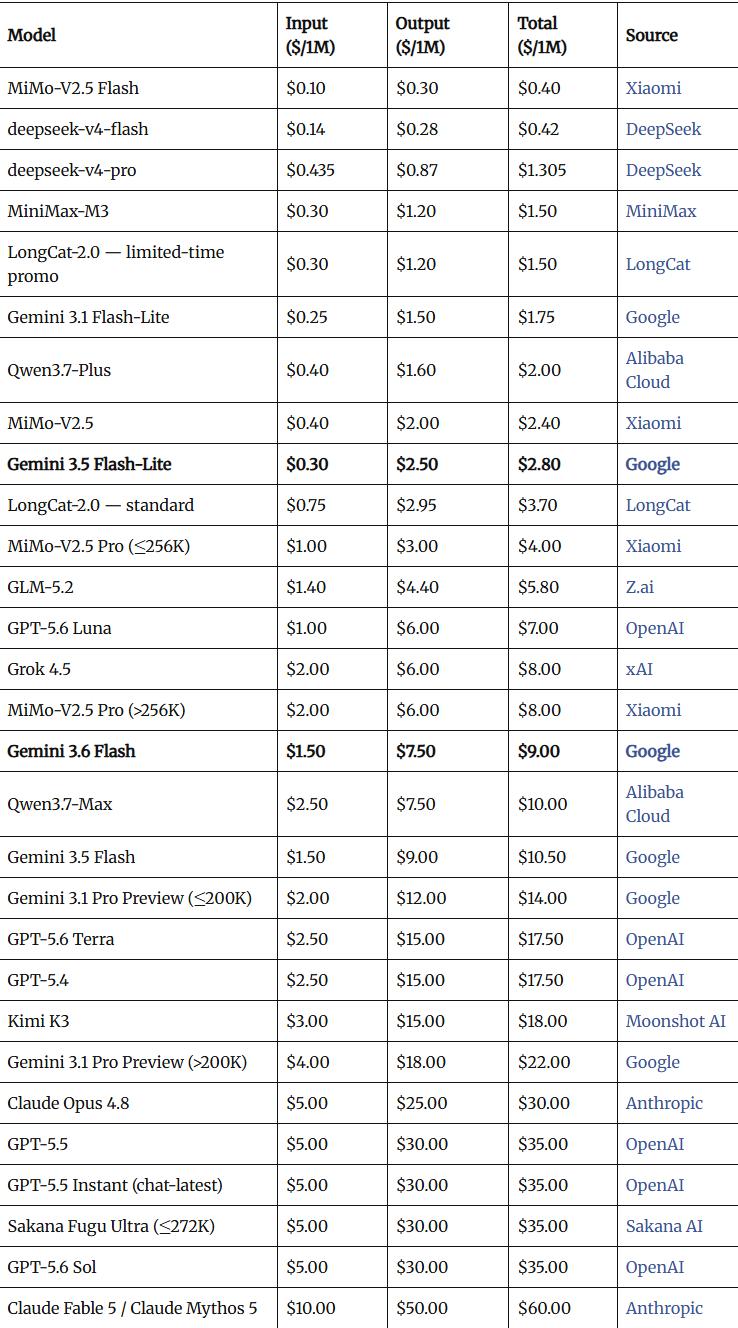
这种效率的提升直接转化为价格优势。Gemini 3.6 Flash的定价为每百万输入Token 1.50美元,每百万输出Token 7.50美元。相较于Gemini 3.5 Flash每百万输出Token 9美元的价格,单次智能体任务的总成本显著降低。对于大规模部署AI应用的企业而言,这种成本结构的优化具有极高的商业价值。
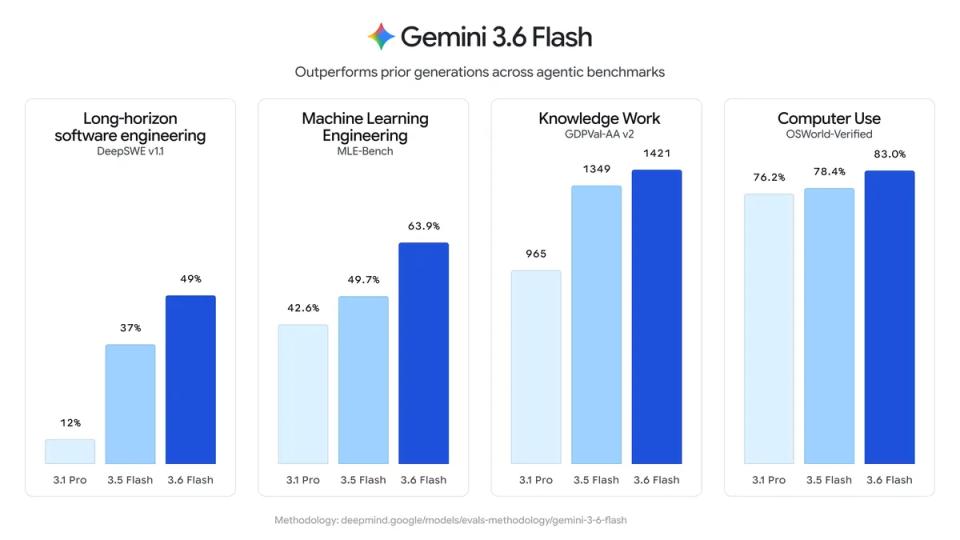
在性能层面,Gemini 3.6 Flash同样取得了可量化的突破。在DeepSWE测试中,其得分达到49%,高于3.5 Flash的37%;在MLE-Bench机器学习工程基准测试中,得分从49.7%提升至63.9%。此外,其计算机使用能力在OSWorld-Verified测试中得分83%,此前为78.4%,该功能现已成为Gemini API和Gemini Enterprise的内置客户端工具。在知识工作方面,GDPval-AA v2基准上的得分也从1349提升至1421。
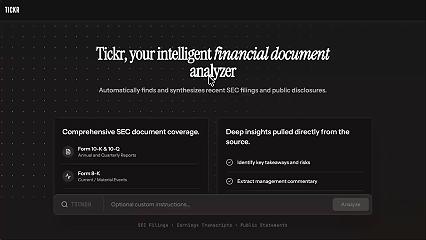
多家头部客户已给出积极反馈。Figma、Harvey、Hebbia和JetBrains均表示,Gemini 3.6 Flash在处理复杂工作流和知识型任务时,在Token效率、准确性和速度之间取得了良好的平衡。谷歌展示的实际场景也印证了这一点:在金融领域,该模型能更高效地解析和分析财务数据;在代码迁移任务中,借助多智能体编排,实现了更低的延迟和更高的质量;在创意工具方面,利用视觉理解能力构建了交互式主题工作室。
速度极限:Gemini 3.5 Flash-Lite的定位突破
如果说Gemini 3.6 Flash追求的是效率与性能的平衡,那么Gemini 3.5 Flash-Lite则致力于在速度上卷出新高度。谷歌将其定义为3.5系列中“最快、最具成本效益”的模型。
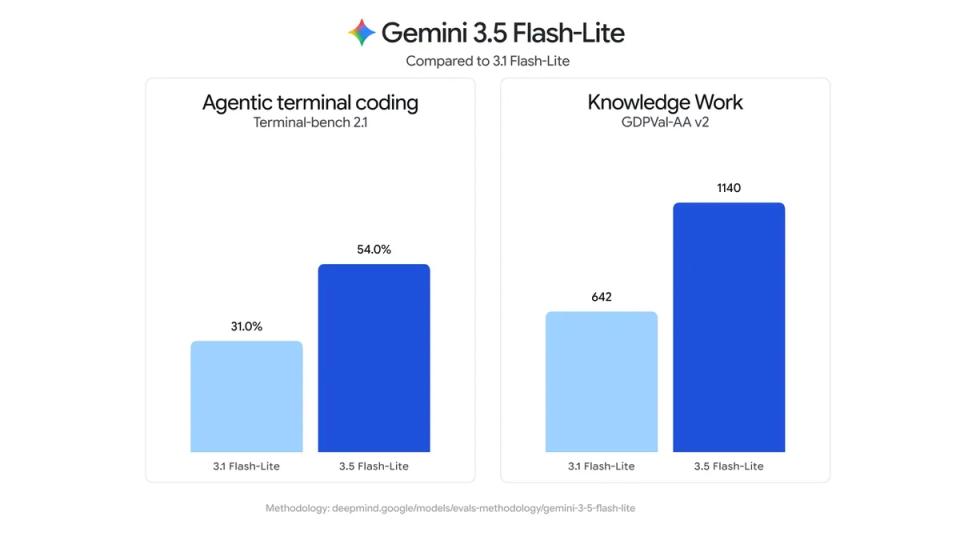
根据Artificial Analysis的实测,Gemini 3.5 Flash-Lite的生成速度达到每秒350个输出Token,这大约是上一代3.1 Flash-Lite速度的两倍。其定价极具竞争力,每百万输入Token仅0.30美元,输出Token为2.50美元。这种低成本和高速度的组合,精准瞄准了高吞吐量的业务场景,如智能体搜索、大规模文档处理等。
尽管名为“Lite”,但该模型在多项基准测试中表现优异。在SWE-Bench Pro测试中,其得分54.2%,超过了标准版Gemini 3 Flash的49.6%;在OSWorld-Verified测试中,它以74%的成绩优于Gemini 3 Flash的65.1%。这表明,轻量级模型在特定优化下,完全有能力胜任原本需要更大模型才能完成的任务。
开发者还可以根据工作负载灵活调整模型的“思考层级”。在处理简单的高容量任务时,可设为最低思考以换取低延迟和低成本;而在面对复杂的子智能体任务时,再提高思考层级以保证质量。这种灵活性使得该模型能够适应多样化的应用场景。
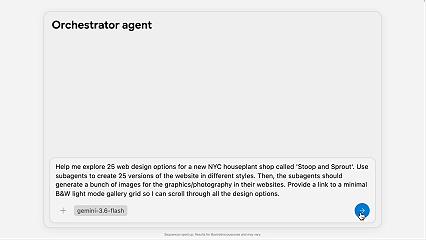
谷歌公布的四个演示案例进一步展示了其潜力:从海量电子商务数据集中提取产品特征、协同生成网页设计概念、大规模进行收据翻译和摘要,以及通过即时生成选项来构建游戏。早期客户Ashler、Paloalto和Ramp均强调了该模型在速度、智能和成本效益方面的独特组合,认为其适用于扩展智能体工作流和数据处理任务。
垂直深耕:Gemini 3.5 Flash Cyber的安全使命
第三款模型Gemini 3.5 Flash Cyber,是谷歌在垂直领域深耕的又一力作。该模型专门用于发现和修补网络安全漏洞,基于Gemini 3.5 Flash进行微调,旨在以更低的Token成本完成通常交给大模型的代码安全任务。
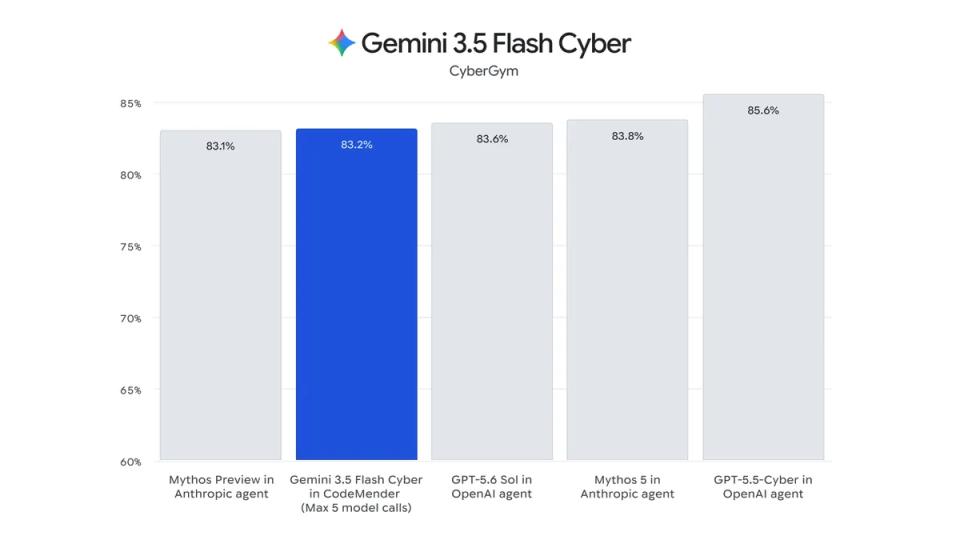
在名为CyberGym的基准测试中,Gemini 3.5 Flash Cyber的表现已达到前沿水平。然而,鉴于网络攻防的双刃剑性质,谷歌采取了审慎的交付策略。该模型不会面向所有开发者开放,而是集成到谷歌的代码安全智能体CodeMender中,作为有限访问试点项目,仅独家提供给政府和受信任的合作伙伴。
谷歌Gemini团队产品管理高级总监图尔西·多希表示,这一策略旨在让一线防御者能在关键漏洞被广泛利用前,抢先一步发现并修复它们,从而降低被滥用的风险。内部测试数据显示,该模型在开源代码库V8 JavaScript Engine中找出了55个问题,其中10个漏洞是其他模型未能发现的。
旗舰缺席与未来展望:Pro延期与Gemini 4启动
尽管Flash系列新模型陆续到位,但开发者社区更关心的问题始终是:Gemini 3.5 Pro何时发布?谷歌上一次更新Pro系列模型是在今年2月发布的Gemini 3.1 Pro。此后,竞争对手如OpenAI、Anthropic等纷纷推出新一代旗舰产品,竞争压力日益增大。
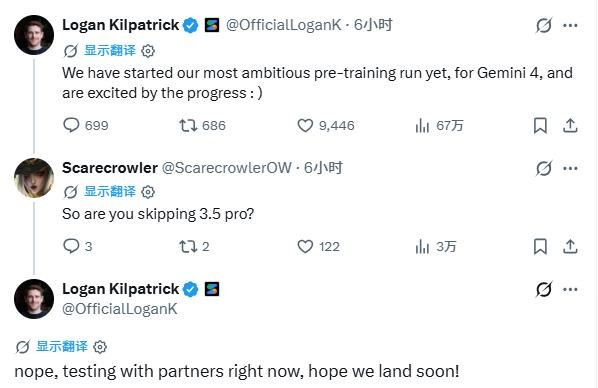
今年5月,谷歌曾预告Pro版本已在内部使用,预期一个月内推出。然而,截至7月末,该模型仍处于未公开状态。彭博社此前报道称,谷歌因难以达到内部性能目标,在推出3.5 Pro方面面临内部延迟。对此,谷歌DeepMind技术负责人洛根·基尔帕特里克回应称,Gemini 3.5 Pro正在与合作伙伴进行测试,计划在准备就绪后立即广泛提供,但未给出具体时间节点。
与此同时,谷歌首次正式提及了下一代旗舰模型Gemini 4的进展。团队表示,已经启动了Gemini 4的预训练工作,并称其为“迄今为止最雄心勃勃的预训练工作”。这在一定程度上表明,谷歌的模型研发管线仍在持续推进,而3.5 Pro的交付节奏可能受内部测试和性能目标的影响。
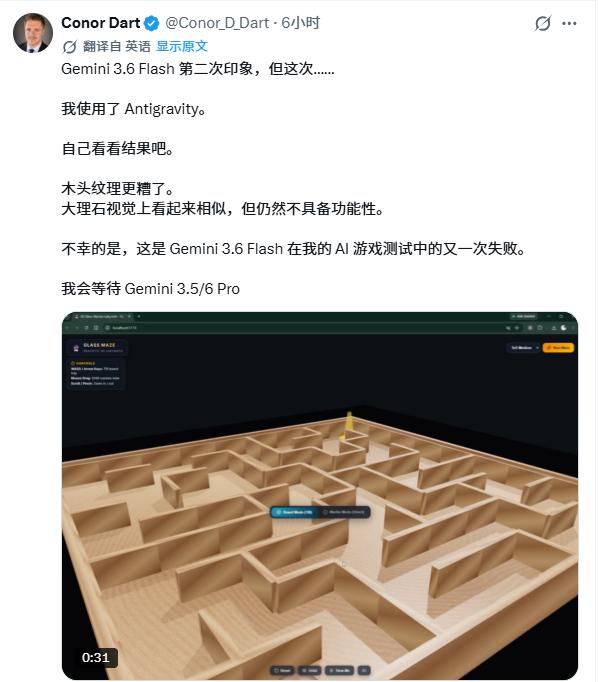
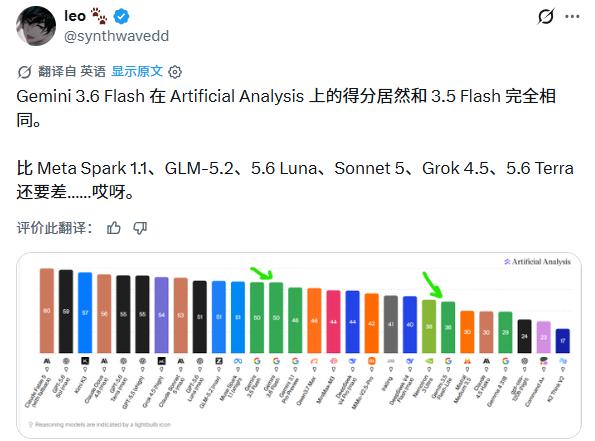
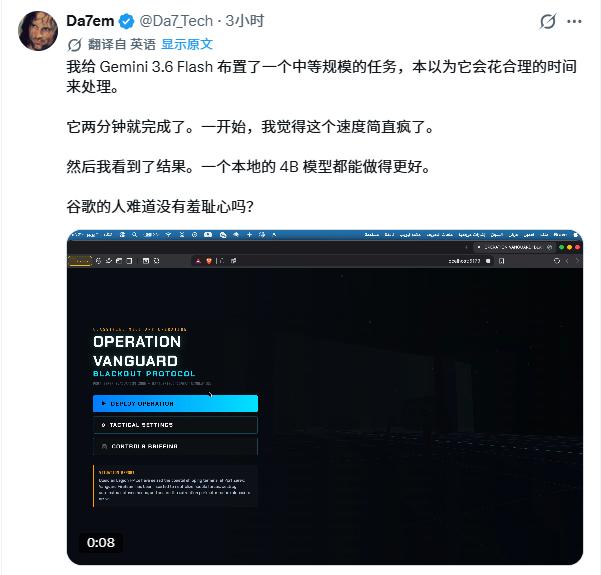
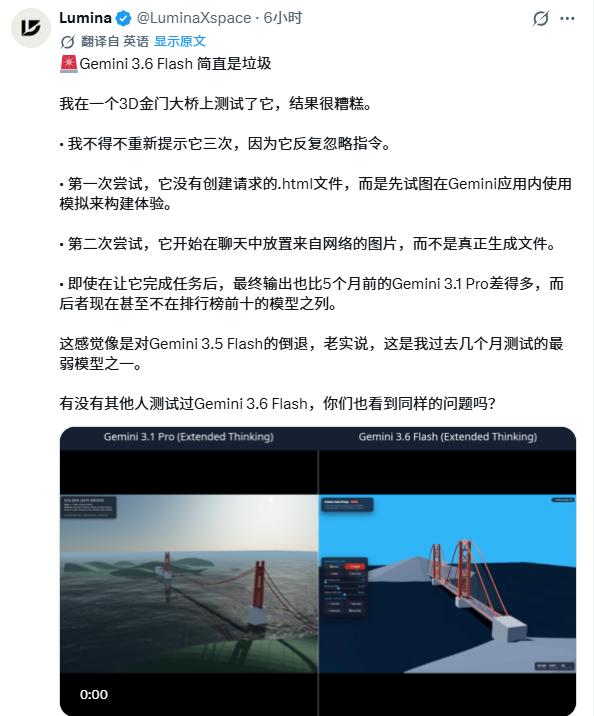
然而,新模型的开放也引发了一些负面反馈。有开发者指出,3.6 Flash在实际表现中仍存在不足,如在构建3D场景时忽略指令,输出质量甚至不如5个月前的3.1 Pro。还有用户认为,尽管3.6 Flash价格便宜,但在编码基准上表现不佳,相比之下,由资本规模远小于谷歌的实验室打造的Kimi K3和GLM 5.2等模型,却交出了更好的成绩。
行业启示:AI进入“精算”时代
从谷歌此次发布三款新模型的布局来看,其核心策略是在效率上建立优势。当下,越来越多的企业开始审视AI投入产出比,意识到大量消耗Token并不总能换来好结果。谷歌CEO桑达尔·皮查伊曾指出,有的公司5月份就花完了全年的Token预算,如果能混合使用Flash模型和其他前沿模型,能节省大量资金。
这种思路反映在产品上,就是不断压低成本、提高速度,同时增强模型处理具体任务的能力。伴随高性能指标,安全也是必须要做的功课。Gemini 3.6 Flash在化学、生物、放射性、核(CBRN)以及网络攻击滥用方面,都加强了前沿安全防护,提升了抵御越狱攻击的能力,同时尽量减少对正常有益用途的拒绝。
对于普通用户和开发者而言,这些模型自发布当天即可在Google AI Studio、Android Studio和Gemini应用中使用,同时可在Google Antigravity及Gemini Enterprise应用中使用。Gemini 3.5 Flash-Lite还将逐步在谷歌搜索引擎中推开,而Gemini 3.5 Flash Cyber将通过CodeMender以邀请制落地。
总体而言,谷歌此次发布标志着AI行业进入了一个更加注重“精算”的时代。在算力成本日益高昂的背景下,如何在保证性能的前提下,最大化效率与性价比,将成为各大厂商竞争的关键。Gemini 3.5 Pro的延期与Gemini 4的启动,也预示着未来旗舰模型将在性能与效率之间寻求更完美的平衡。对于企业而言,选择合适的模型组合,而非盲目追求最新旗舰,将是实现AI价值最大化的关键策略。