谷歌Gemini延期真相:3.6 Flash与3.5 Lite为何抢先登场?
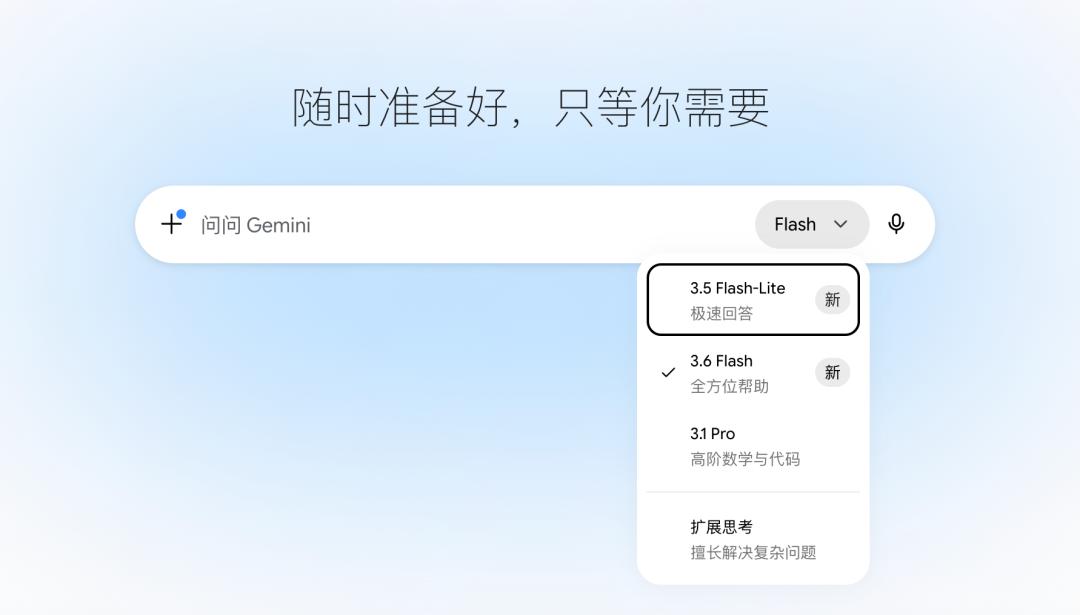
在科技行业的高速迭代节奏中,谷歌最近的举动显得有些反常。按照原定计划,备受瞩目的旗舰模型Gemini 3.5 Pro应当在6月份与公众见面,但截至7月下旬,这款被寄予厚望的模型依然处于“隐身”状态。然而,谷歌并没有选择沉默,而是突然在Google AI Studio上线了两款新模型:Gemini 3.6 Flash和Gemini 3.5 Flash-Lite。这种“旗舰缺席,配角登场”的局面,不禁让人疑惑:谷歌究竟在打什么算盘?这两张所谓的“草稿纸”,是否只是为了争取时间而临时拼凑的应急方案?还是说,这背后隐藏着谷歌对AI落地路径的深刻战略调整?
要理解谷歌的这波操作,首先需要拆解这两款新模型的核心定位。Gemini 3.6 Flash并非旨在挑战智商天花板,而是专注于“干活”。在AI Agent(智能体)时代,模型的价值不再仅仅体现在单次对话的优雅程度,更在于能否高效、低成本地完成复杂的自动化任务。一次Agent任务往往涉及数十轮甚至上百轮的模型调用,这对模型的响应速度、成本控制以及工具调用能力提出了极高要求。Gemini 3.6 Flash正是为此而生,它通过减少输出Token的数量来降低运行成本,同时强化编码、推理和外部工具调用的表现。
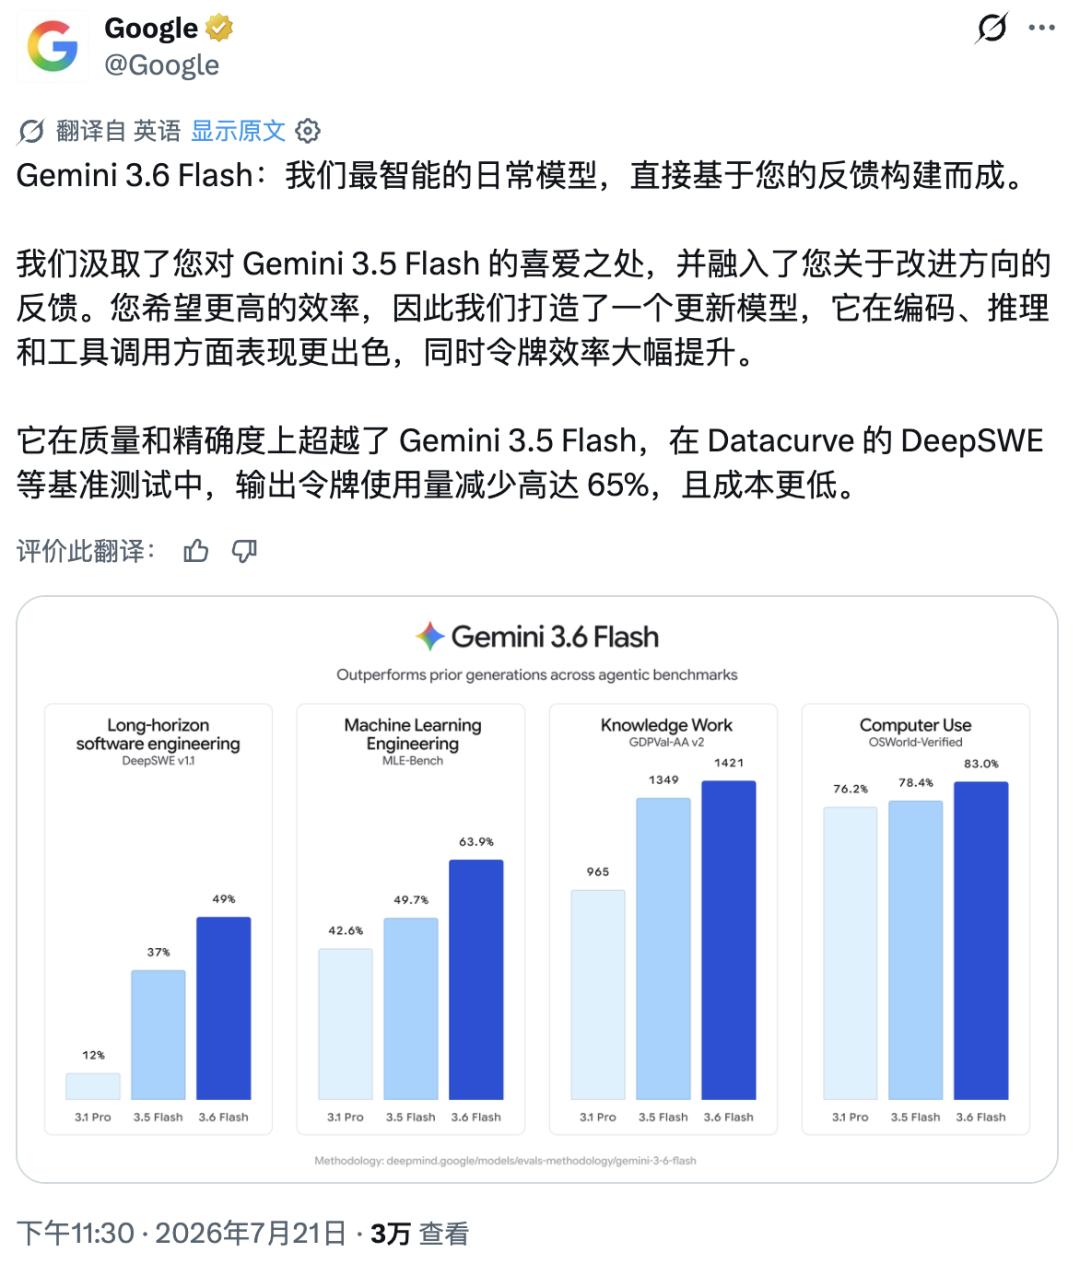
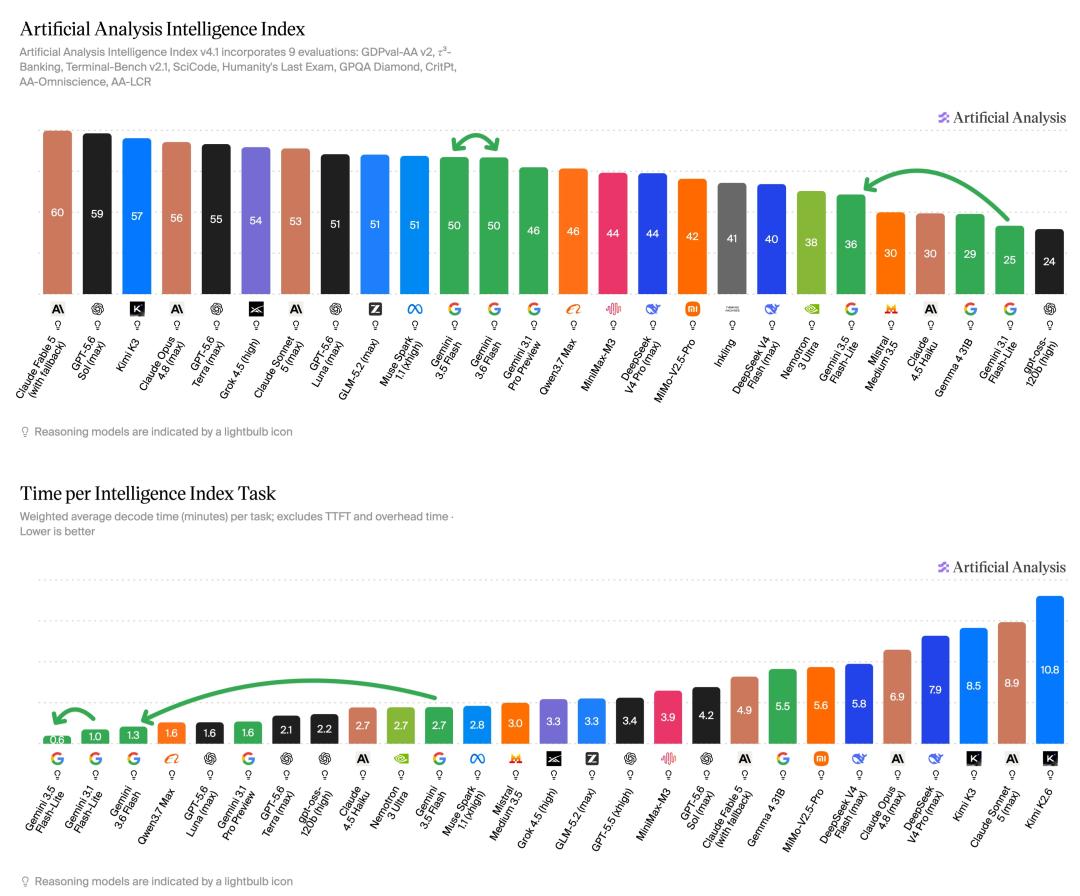
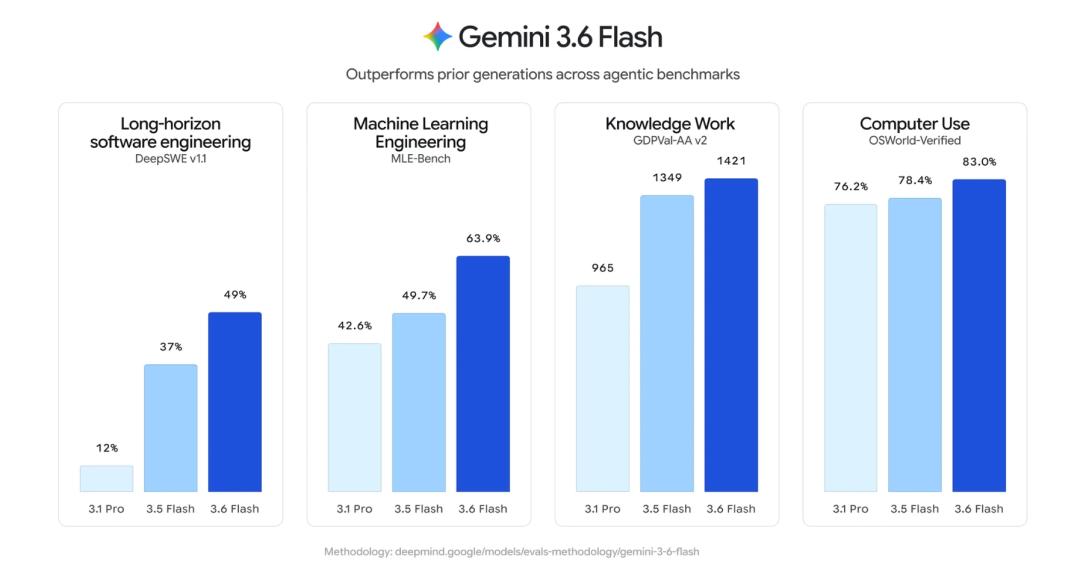
从数据上看,Gemini 3.6 Flash的提升是实质性的。在DeepSWE代码评测中,其得分从上一代的37%跃升至49%,显示出在代码生成和修改方面的显著进步。在OSWorld-Verified测试中,其操作电脑的能力得分达到83%,超过了上一代的78.4%。更引人注目的是其成本效益:官方数据显示,在完成相同任务时,该模型减少了55.8%的Token消耗,并将任务评分从85分提升至100分。定价方面,输出成本从每百万Token 9美元降至7.5美元,虽然降幅看似不大,但在大规模企业应用中,积少成多的成本节约效应不容忽视。
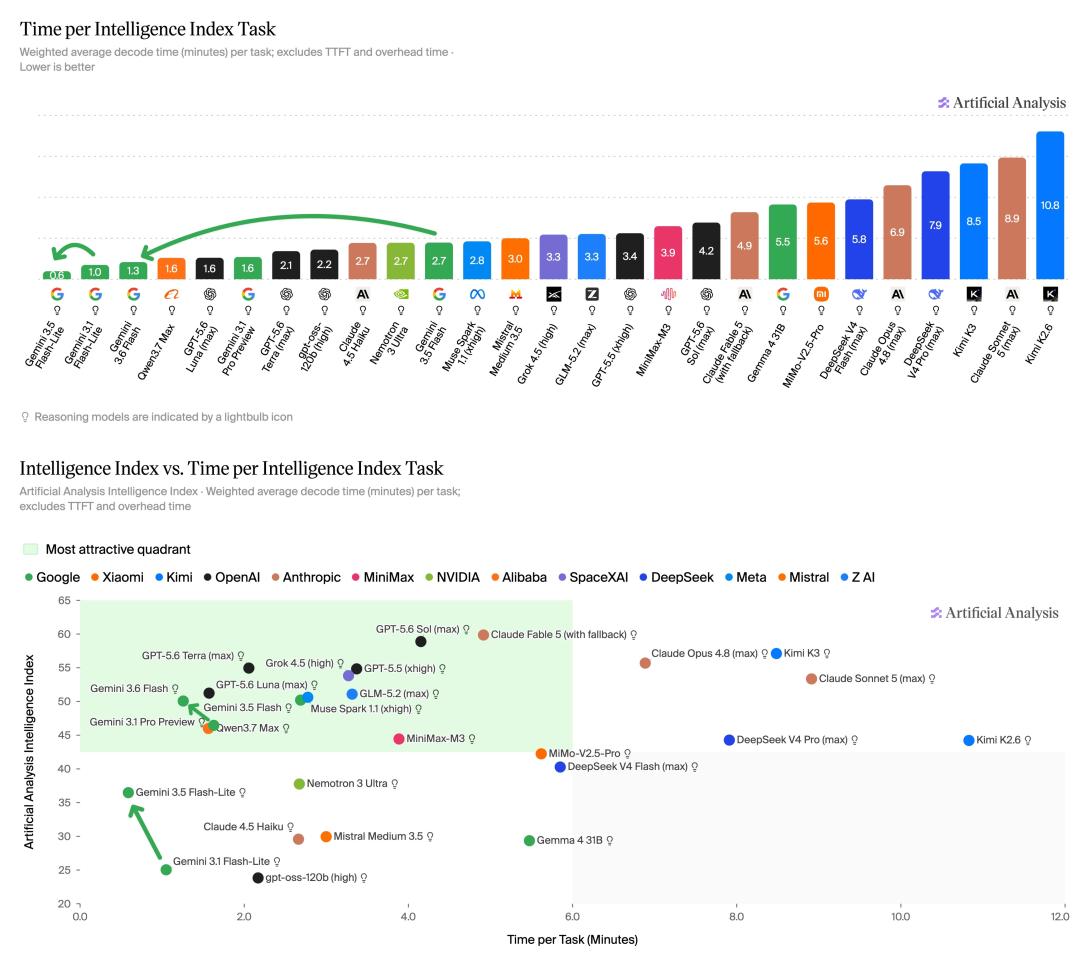
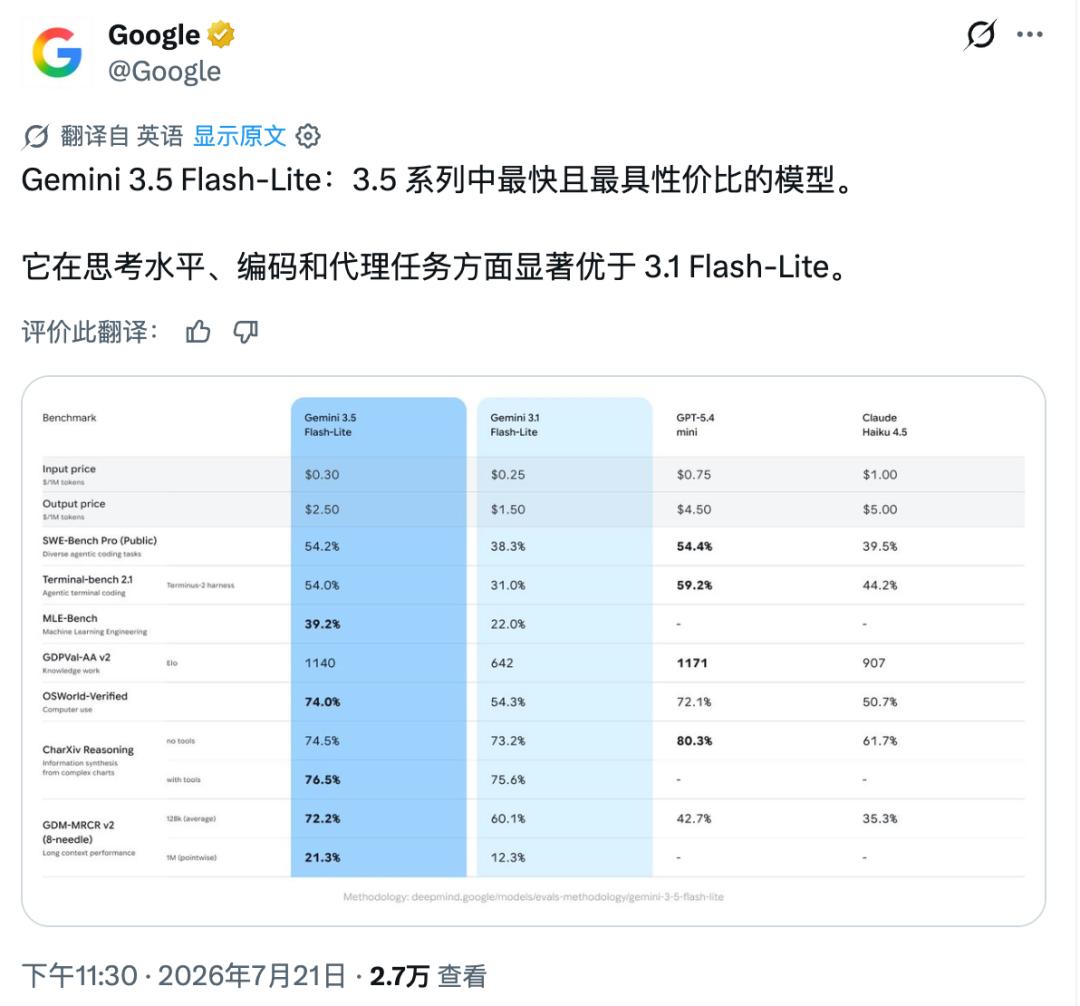
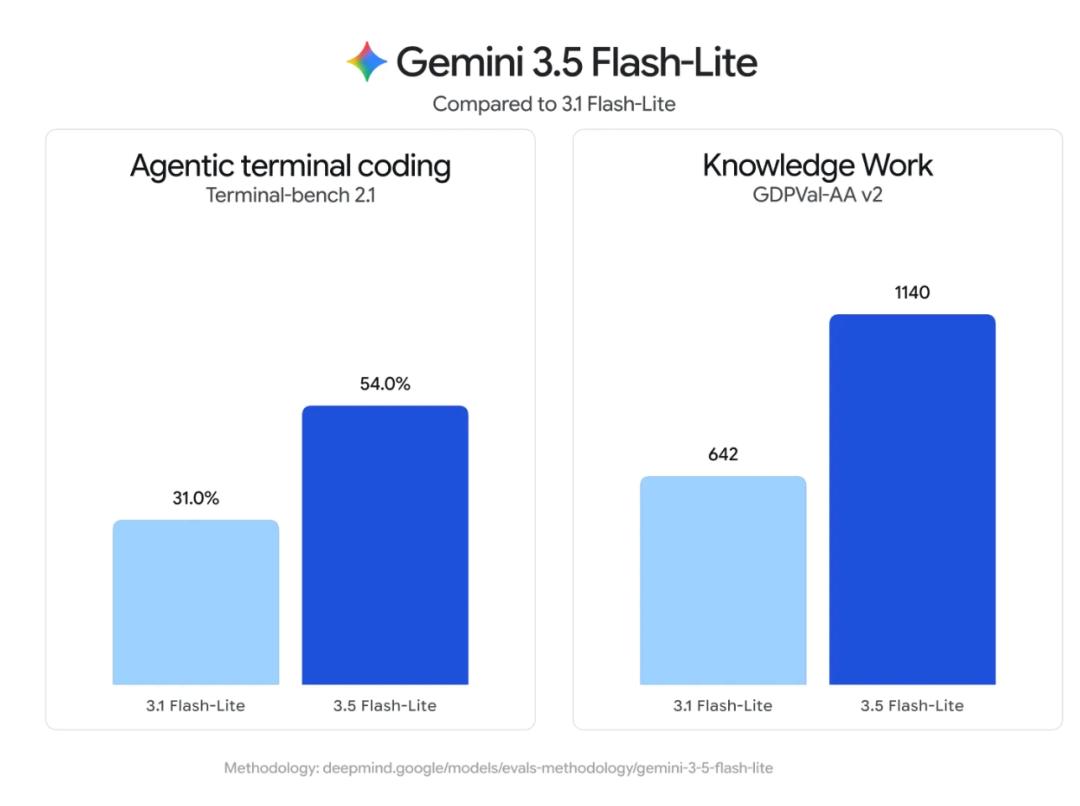
与3.6 Flash不同,Gemini 3.5 Flash-Lite走的是极致轻量化的路线。它的核心优势在于速度和极低的价格。测试数据显示,其生成速度达到约350 Token/秒,任务平均完成时间仅为0.6分钟,比上一代产品快了数倍。价格方面,输入仅为每百万Token 0.3美元,输出为2.5美元,虽然相比上一代Flash-Lite并未进一步降价,但其性能的大幅提升使得单位任务的综合成本得以控制。值得注意的是,这款轻量级模型甚至在某些Agent任务上超越了上一代定位更高的Gemini 3 Flash,例如在SWE-Bench Pro测试中得分54.2%,高于Gemini 3 Flash的49.6%。这一现象表明,随着算法优化,部分原本需要大型模型才能完成的复杂任务,正在逐渐下沉到更轻量、更便宜的模型中。
然而,这两款Flash系列模型的亮眼表现,无法掩盖Gemini 3.5 Pro缺席的事实。旗舰模型的延期,不仅仅是时间表的推迟,更反映了谷歌在技术攻坚上面临的挑战。据彭博社和路透社报道,谷歌正在对3.5 Pro进行额外优化,特别是针对编码能力的提升,以期达到内部设定的高标准。但“很快”这一模糊的时间表,暴露出谷歌在旗舰模型研发上的不确定性。在AI竞争白热化的今天,旗舰模型代表了企业的技术上限和品牌信誉。Gemini 1.0曾因演示争议受到质疑,Gemini 1.5 Pro虽凭借长上下文能力短暂回暖,但面对GPT和Claude系列的快速追赶,谷歌急需一款真正领先的旗舰产品来稳固其前沿地位。
Gemini 3.5 Pro的延期,对市场信号产生了复杂影响。一方面,它可能让部分观望者对谷歌的研发节奏产生疑虑;另一方面,这也促使谷歌不得不加速推进“效率优先”的路线。通过大力推广Flash系列,谷歌试图向市场证明,即使旗舰模型稍晚登场,其AI生态依然具备强大的商业化落地能力。谷歌CEO Sundar Pichai曾多次强调成本优势,宣称企业迁移至Gemini模型可每年节省超10亿美元。这种策略旨在通过规模化应用积累市场份额和用户粘性,为旗舰模型的最终亮相争取舆论和技术缓冲期。
此外,全球AI竞争格局的变化也为谷歌的延期增添了紧迫感。过去,AI前沿主要由OpenAI、Anthropic和Google DeepMind三家主导。但近期,GLM-5.2、Kimi K3等国产模型的迅速崛起,打破了原有的垄断叙事。这些国产模型在特定领域和性能指标上已具备与海外顶尖模型抗衡的实力,引发了广泛讨论。在这种背景下,谷歌如果无法尽快推出具有统治力的旗舰模型,可能会面临市场份额被侵蚀的风险。Flash系列虽好,但终究是“草稿”,市场最终期待的仍是一份能够证明“谷歌DeepMind依然是最强AI研究机构”的“正式答卷”。
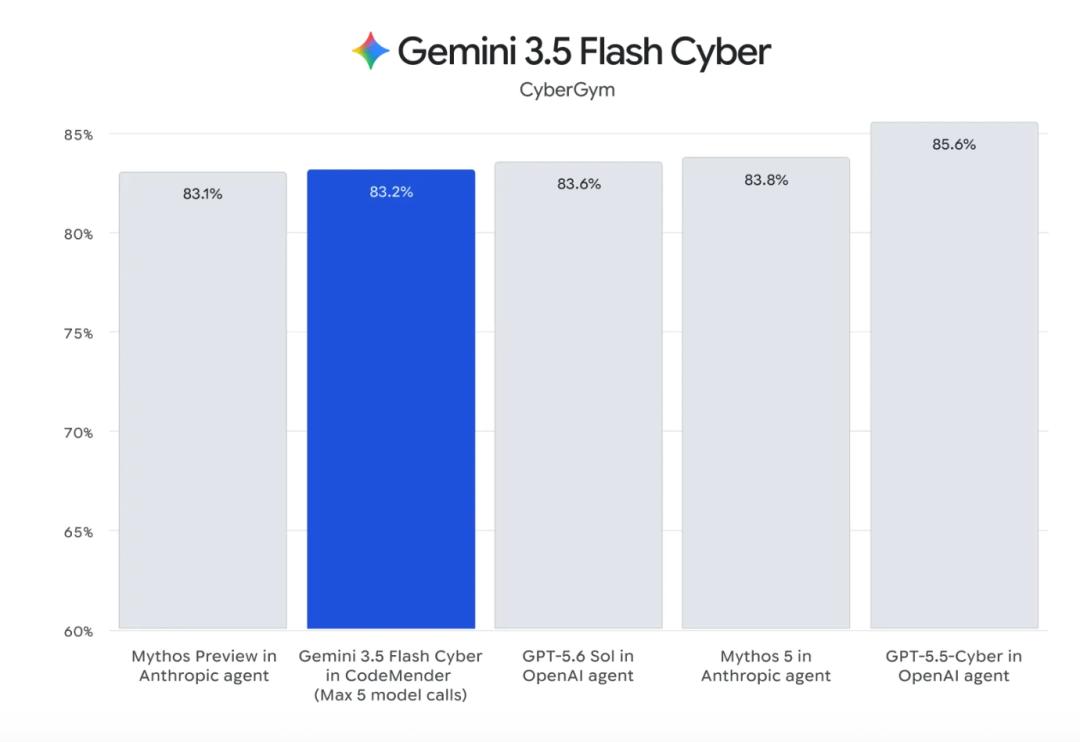
值得注意的是,谷歌在此次发布中并未忽视垂直领域的应用。除了通用模型,谷歌还推出了针对网络安全的Gemini 3.5 Flash Cyber。该模型通过多个Agent协同工作,能够自动完成代码分析并生成报告,在CyberGym基准测试中表现接近前沿水平。虽然该模型目前仅通过CodeMender平台向政府和可信合作伙伴开放,但这显示了谷歌在构建垂直行业AI解决方案上的野心。这种“通用基础模型+垂直专用模型”的双轨策略,有助于谷歌在不同细分市场建立壁垒。
从技术演进的角度看,Flash系列的崛起反映了AI应用进入“深水区”后的必然趋势。在早期,行业关注点是模型是否能通过图灵测试或解答复杂科学问题;而现在,企业更关心模型能否稳定、廉价地嵌入工作流。Gemini 3.6 Flash和3.5 Flash-Lite的成功,预示着“小而美”、“快而省”的模型将成为主流生产力工具。谷歌通过强化Agent能力和代码优化,实际上是在重新定义大模型的竞争优势:不再是单纯的智商比拼,而是执行效率与经济性的综合较量。
然而,这种策略也存在潜在风险。如果Gemini 3.5 Pro的最终表现无法超越竞争对手,那么Flash系列的规模优势可能会被旗舰能力的短板所抵消。在高端市场,企业往往愿意为更高的准确率和更强大的推理能力支付溢价。如果谷歌的旗舰产品缺乏足够的差异化优势,Flash系列的低成本策略可能难以支撑其长期的品牌价值。此外,过度依赖Flash系列可能导致外界对谷歌基础模型研发能力的低估,进而影响其在顶级科研人才和技术合作伙伴中的吸引力。
对于投资者和行业观察者而言,接下来的关键节点是Alphabet的财报电话会议。投资者可能会就Gemini 3.5 Pro的具体进展、延期原因以及对未来营收的影响提出尖锐问题。谷歌需要清晰地阐述其技术路线图,解释Flash系列与Pro系列之间的协同效应,并展示其在全球AI竞赛中的长期竞争力。如果谷歌能够证明Flash系列的成功是整体战略的一部分,而非旗舰延期的无奈之举,那么市场可能会重新评估其投资价值。
综上所述,谷歌推出Gemini 3.6 Flash和3.5 Flash-Lite,既是应对旗舰延期的战术调整,也是顺应AI规模化应用趋势的战略选择。这两张“草稿纸”展示了谷歌在成本控制、Agent执行效率和代码生成方面的显著进步,但也折射出其旗舰模型研发面临的挑战。在激烈的全球竞争中,谷歌需要在“效率”与“实力”之间找到平衡点。Flash系列可以赢得当下,但只有强大的旗舰模型才能赢得未来。对于行业而言,这不仅是谷歌的考验,也是所有AI巨头在迈向通用人工智能(AGI)道路上必须面对的共同命题。