谷歌密集发布Lite与Flash模型,旗舰Pro缺席背后的战略转向
效率至上:AI模型发展的新分水岭
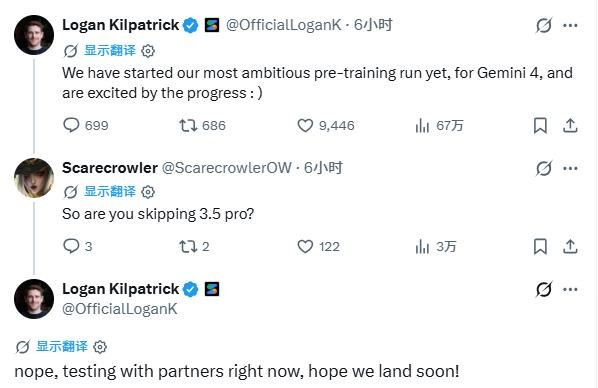
美国当地时间7月21日,谷歌DeepMind团队宣布了一次密集的模型更新,一口气推出了Gemini 3.6 Flash、Gemini 3.5 Flash-Lite以及Gemini 3.5 Flash Cyber三款新模型。这一举动在行业内引起了广泛关注,但更为引人深思的是,外界翘首以盼的旗舰级模型Gemini 3.5 Pro依然缺席。谷歌方面表示,该模型正处于与合作伙伴的内部测试阶段,并首次确认了更庞大的Gemini 4预训练工作已经启动。
从产品发布的节奏和侧重点来看,谷歌显然正在调整其战略重心。过去,人工智能行业的竞争焦点主要集中在追求极致的逻辑推理能力和参数规模上,各大厂商纷纷推出所谓的“旗舰”模型以争夺技术制高点。然而,随着AI应用从概念验证阶段迈向大规模商业化落地,企业客户开始重新审视投入产出比(ROI)。“Token即成本”成为许多公司面临的现实痛点,部分企业在2026年5月甚至提前花完了全年的大模型预算。
在这种背景下,谷歌此次发布的三款Flash系列模型,不再单纯炫技,而是直击痛点:降低输出Token消耗、提升生成速度以及增强垂直场景的实用性。这标志着AI大模型的发展进入了“深水区”,即在保持性能不降级的前提下,通过工程优化和技术微调,实现极致的性价比。这种从“性能优先”向“效率与成本平衡”的转变,或许将成为未来几年AI基础设施竞争的核心逻辑。
Gemini 3.6 Flash:重新定义编码效率
Gemini 3.6 Flash作为主力更新模型,其核心卖点在于显著的Token效率提升。根据第三方基准测试机构Artificial Analysis Index的实测数据,该模型在处理相同任务时,输出Token的使用量较前代减少了17%至65%。这一数据并非单纯的营销话术,而是体现在具体的工程任务优化中。
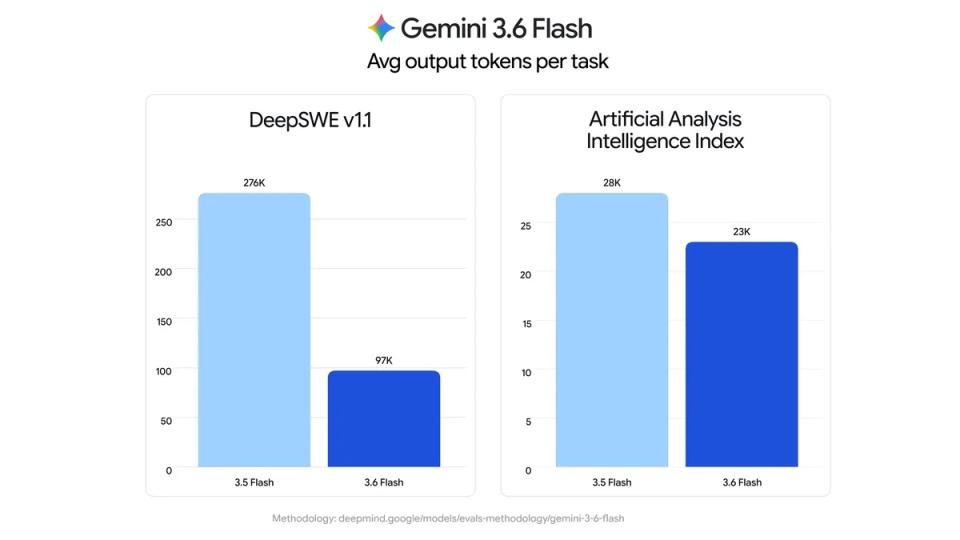
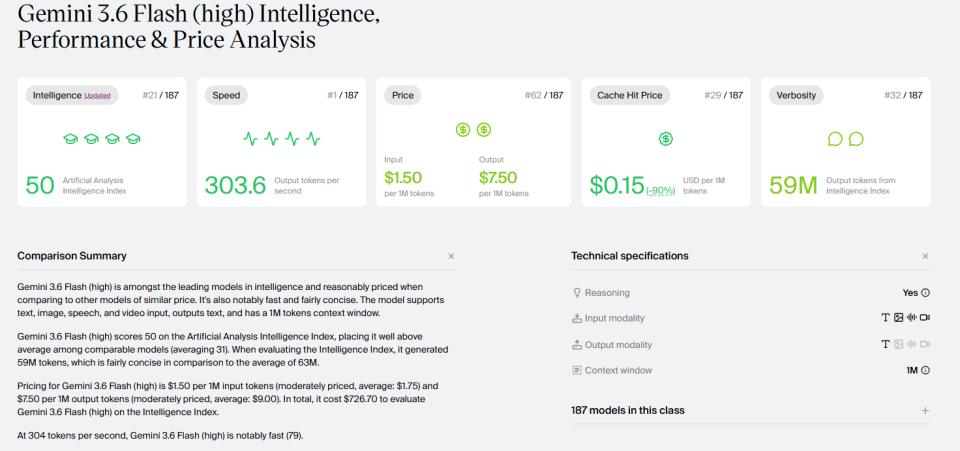
在Datacurve的DeepSWE基准测试中,Gemini 3.6 Flash将Token消耗降低了65%。这意味着在复杂的代码生成和编辑任务中,模型减少了冗余的代码循环和无效的操作步骤,直接转化为成本的节约。与此同时,定价策略也进行了相应调整:每百万输入Token为1.50美元,输出Token为7.50美元。相较于Gemini 3.5 Flash每百万输出Token 9美元的价格,单次智能体任务的总成本明显下降。
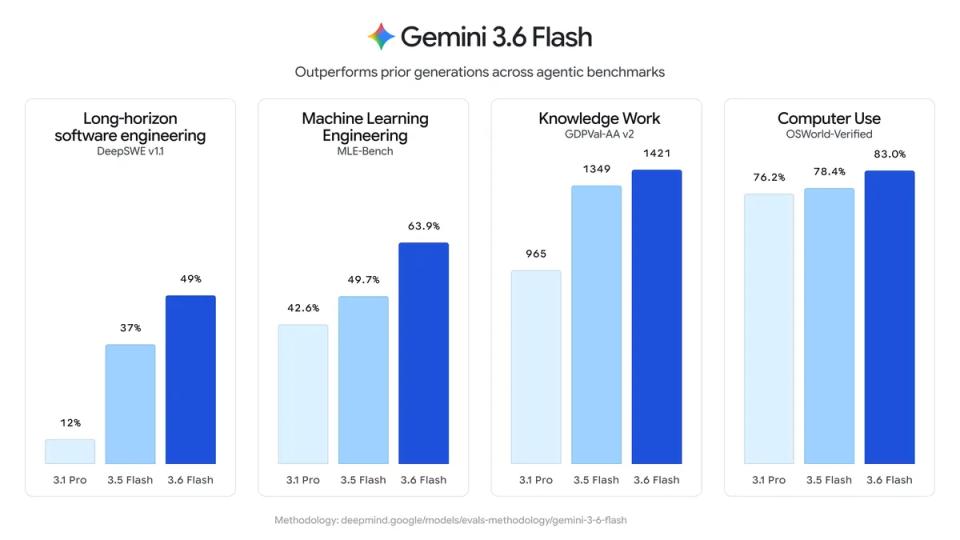
性能方面,Gemini 3.6 Flash并未因追求效率而牺牲能力。在MLE-Bench机器学习工程基准测试中,其得分从49.7%提升至63.9%;在OSWorld-Verified计算机使用能力测试中,得分从78.4%提升至83%。此外,在GDPval-AA v2知识工作基准中,得分也从1349提升至1421。
这些提升直接反映了其在实际业务场景中的价值。例如,在金融领域,模型能够更高效地解析财务数据;在代码迁移任务中,借助多智能体编排,实现了更低的延迟和更高的质量。对于Figma、JetBrains等合作伙伴而言,Gemini 3.6 Flash在复杂工作流中展现出的平衡感,使其成为降低运营成本、提升开发效率的理想工具。这种“做得更多,花得更少”的特质,正是当前企业级AI应用最为渴求的核心竞争力。
Gemini 3.5 Flash-Lite:速度的极致压榨
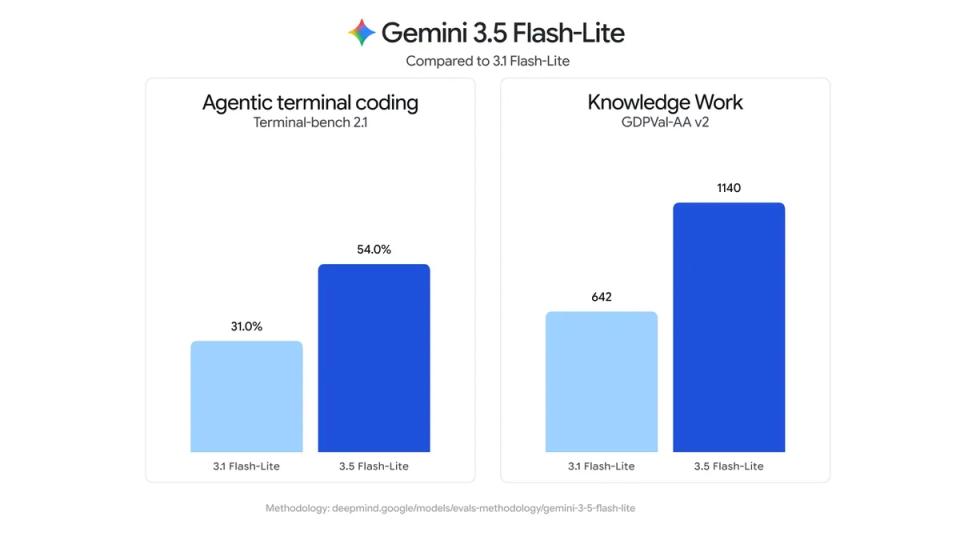
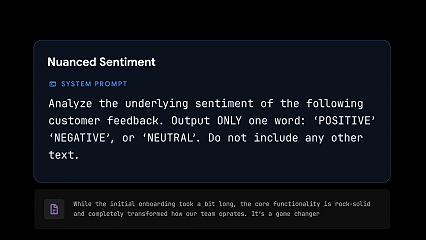
如果说Gemini 3.6 Flash追求的是效率与性能的平衡,那么Gemini 3.5 Flash-Lite则是对“速度”极限的探索。谷歌将其定义为3.5系列中“最快、最具成本效益”的模型,实测生成速度高达每秒350个输出Token,大约是上一代3.1 Flash-Lite的两倍。
极快的速度往往伴随着成本的降低,Gemini 3.5 Flash-Lite的定价极具竞争力:每百万输入Token仅0.30美元,输出Token仅2.50美元。这种超低价策略瞄准的是高吞吐量、对实时性要求极高的业务场景,如智能体搜索、大规模文档处理以及实时交互式应用。
尽管名为“Lite”,但其基础能力并未缩水。在SWE-Bench Pro测试中,它获得了54.2%的得分,超过了标准版Gemini 3 Flash的49.6%。更值得注意的是,谷歌引入了动态“思考层级”机制。开发者可以根据任务复杂度灵活调整模型资源:处理简单的高容量任务时,使用最低思考层级以换取极低延迟;面对复杂子智能体任务时,再提高思考层级以保证质量。这种动态资源分配机制,进一步提升了模型在多样化场景下的适用性。
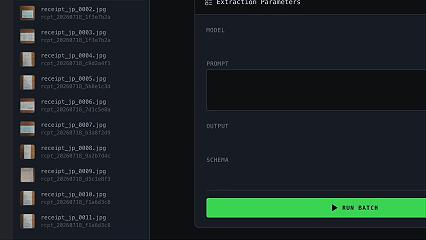
在演示案例中,该模型展现了处理海量电子商务数据特征提取、即时生成网页设计概念、大规模收据翻译摘要等场景的强大能力。对于Ashler、Palo Alto Networks等早期客户而言,这种速度、智能与成本效益的独特组合,使其能够轻松扩展智能体工作流,处理以前因成本过高而无法规模化开展的数据任务。
垂直领域深耕:安全防御的专用利器
第三款模型Gemini 3.5 Flash Cyber,展示了谷歌在垂直领域深耕的决心。这是一款专门针对网络安全漏洞检测与修复进行微调的专用模型,基于Gemini 3.5 Flash构建,旨在以更低的Token成本完成代码安全任务。
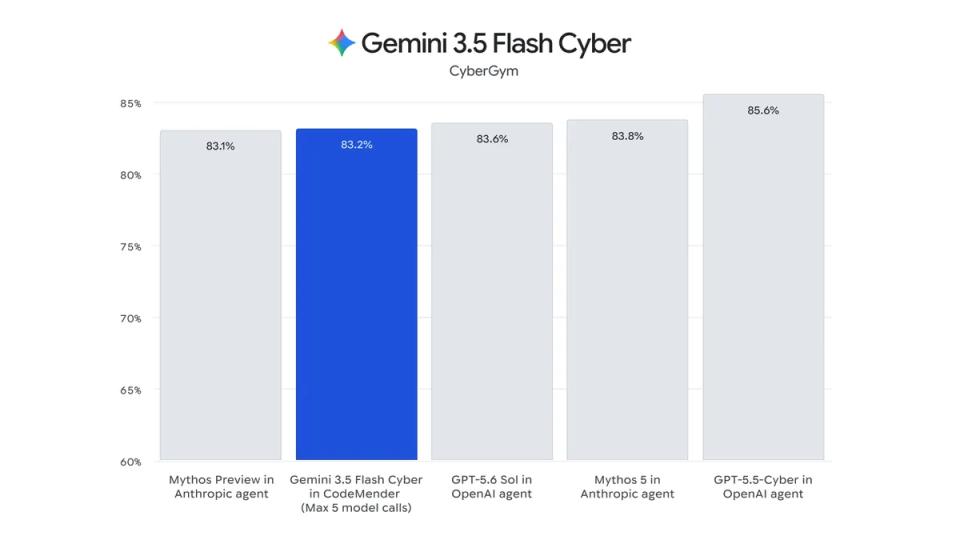
在CyberGym基准测试中,其表现已达到前沿水平。在内部测试中,该模型在开源代码库V8 JavaScript Engine中发现了55个问题,其中10个漏洞是其他通用模型未能察觉的。鉴于网络安全的双刃剑性质,谷歌采取了审慎的交付策略:不面向所有开发者开放,而是集成到代码安全智能体CodeMender中,以邀请制形式提供给政府和受信任的合作伙伴。
谷歌Gemini团队产品管理高级总监图尔西·多希表示,这一策略旨在让一线防御者在关键漏洞被广泛利用前抢先修复,降低被滥用的风险。这种针对特定高危场景的专用模型,不仅体现了技术能力的提升,更反映了AI伦理与安全治理的深化。在AI能力日益强大的今天,如何防止技术被恶意利用,已成为模型发布方不可回避的责任。
旗舰缺席与未来展望
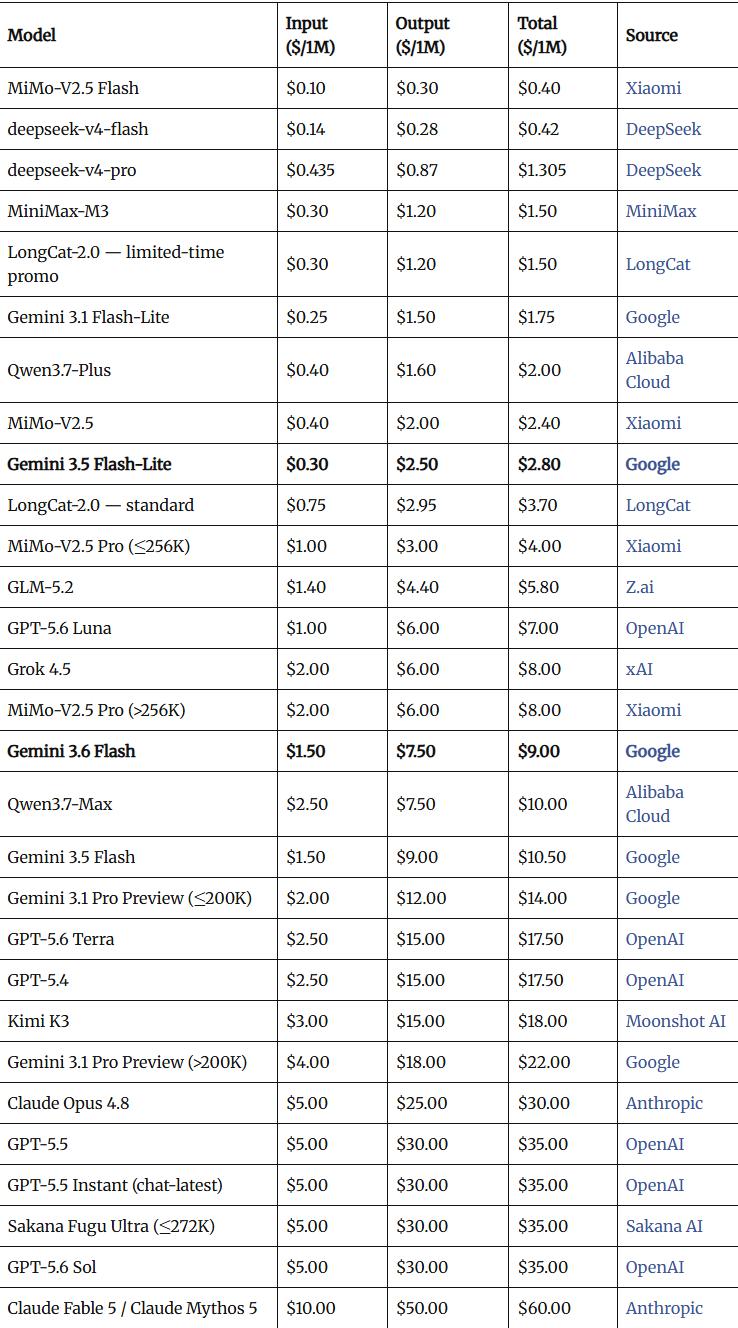
尽管Flash系列新品不断,但开发者社区最关心的Gemini 3.5 Pro仍未露面。自2026年2月发布Gemini 3.1 Pro以来,谷歌在旗舰模型更新上节奏放缓。相比之下,OpenAI的GPT-5.5/5.6系列、Anthropic的Claude Opus 4.8以及中国企业的Kimi K3、GLM 5.2等竞品持续迭代,竞争压力巨大。
彭博社此前报道指出,谷歌因难以达到内部性能目标,在3.5 Pro的推出上面临内部延迟。对此,谷歌DeepMind技术负责人洛根·基尔帕特里克回应称,该模型正在与合作伙伴测试,将在准备就绪后广泛提供,但未给出具体时间节点。与此同时,谷歌正式确认Gemini 4预训练工作已启动,并称其为“迄今最雄心勃勃的预训练工作”。
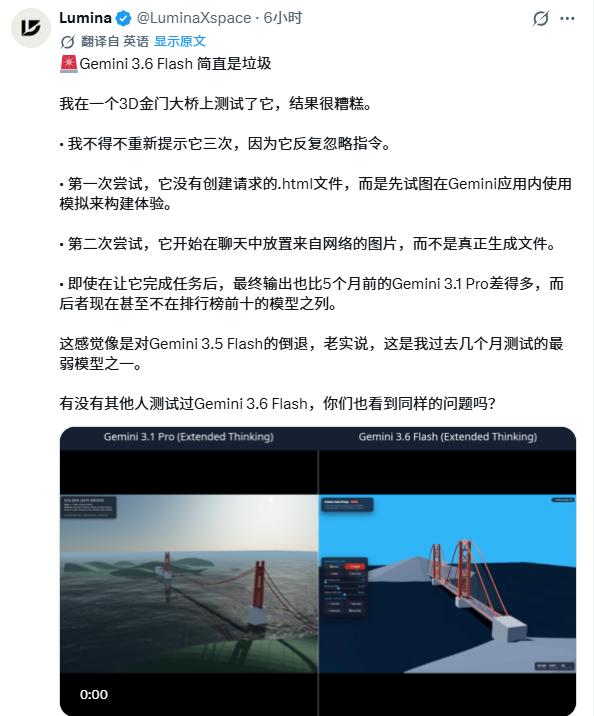
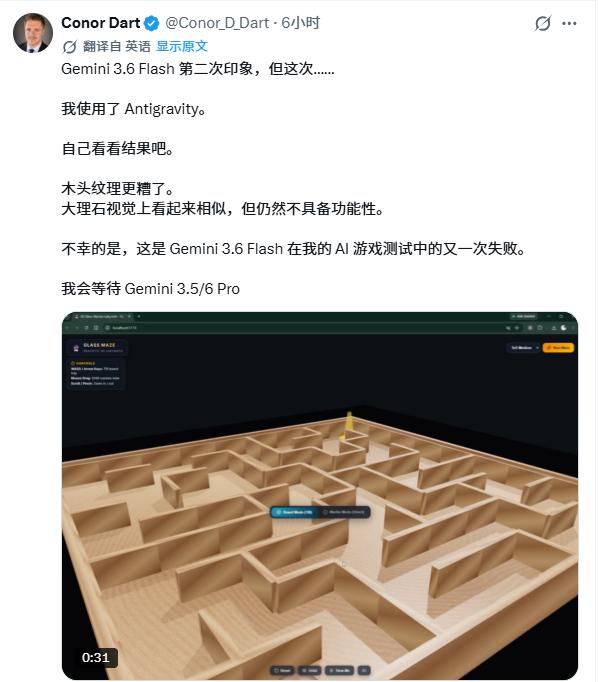
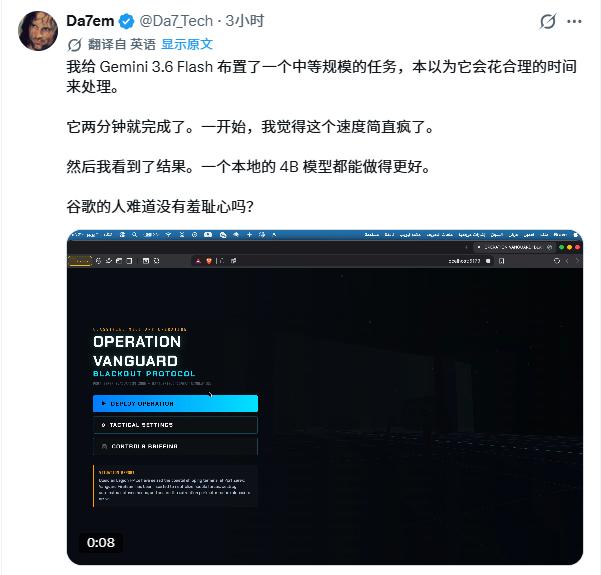
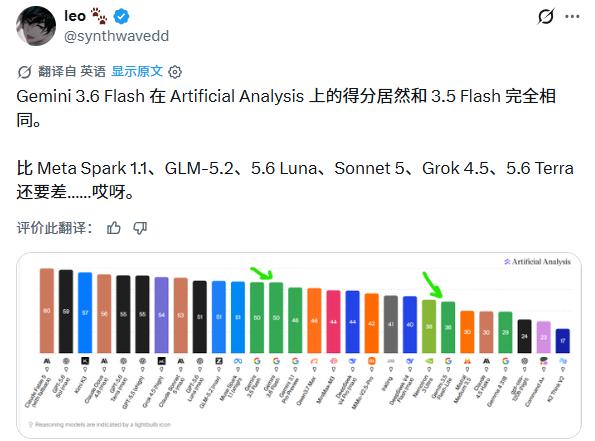
这一系列信号表明,谷歌并非放弃高端市场,而是在寻求更稳妥的突破。然而,新模型发布后,开发者社区的反馈并不全是正面。部分测试显示,Gemini 3.6 Flash在某些复杂3D场景生成中仍出现指令忽略、纹理质量下降等问题,甚至有用户认为其表现不如数月前的旧模型。在Artificial Analysis的评分中,3.6 Flash虽在成本上占优,但在综合基准测试中并未进入前十,落后于Meta Spark 1.1、GPT-5.6等多个竞品。
这种争议折射出AI行业当前的结构性矛盾:企业在追求低成本的同时,对模型智商和稳定性的期待并未降低。谷歌需要在效率优势与性能卓越之间找到更好的平衡点。随着Gemini 4的预研启动,以及3.5 Pro的最终问世,谷歌能否在2026年的下半年重新夺回旗舰性能的王座,仍需时间验证。但毫无疑问,以Flash系列为代表的效率导向策略,已经为整个AI产业设定了新的竞争基准。