国产大模型实战:Kimi、Qwen与GLM重构屎山代码的六维对决
在人工智能重塑软件开发的浪潮中,基准测试榜单上的分数往往掩盖了真实工程场景的复杂性。当我们将目光从干净的空白项目转向那些充斥着历史债务、逻辑纠缠且文档缺失的“屎山”代码时,大模型的真正成色才得以显现。近期,我们进行了一项极具挑战性的实验:让Kimi K3、Qwen 3.8-Max-Preview和GLM 5.2三款国产顶尖大模型,共同接管一个处于半成品状态、结构臃肿且Bug频出的媒体网站改版项目。这并非简单的代码生成,而是一场关于理解力、执行力与创造力的综合博弈。
项目背景本身就是一个巨大的陷阱。该网站基于Next.js前端框架与Payload CMS构建,集成了Anime.js动效,但历经多次迭代后,前端交互混乱,后端逻辑与前端展示严重脱节,大量功能虚假不可用。对于AI而言,从零开始构建项目如同在白纸上作画,自由度高;而在既有代码基础上进行“屎上雕花”,则要求模型具备极强的上下文感知能力,既要读懂过去的意图,又要精准规避现有功能的破坏。这种半路接手的项目,是检验AI工程化能力的试金石。
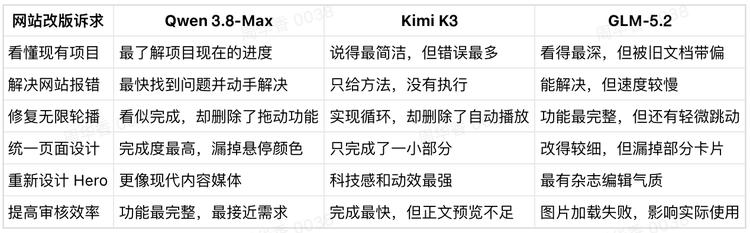
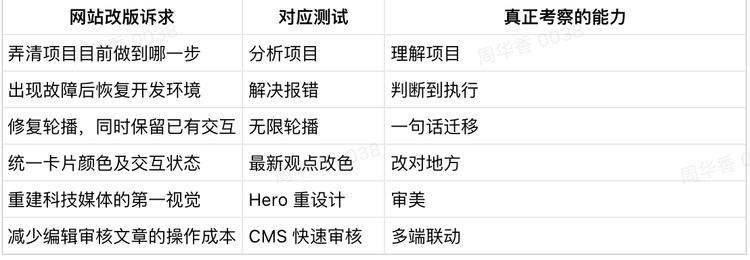
首轮测试聚焦于“现状认知”。在半路项目中,最致命的错误莫过于将旧文档中的规划误认为当前已完成的功能,或者对现有架构产生误判。我们将项目代码库与文档同时投喂给三个模型,要求它们分析当前进展。Qwen 3.8-Max展现了惊人的速度,在十秒内便完成了分析,其表现更像是一位常驻现场的监工,敏锐地捕捉到了最近的修改痕迹,准确区分了“已有”与“计划”,虽在全局结构的深度挖掘上略显不足,但精准度最高。相比之下,GLM 5.2如同一位严谨的老工程师,深入底层检查了数据库机制与版本锁定,对项目骨架理解深刻,却因过度依赖历史文档,将已完成的搜索功能误判为待办事项,陷入了“纸上谈兵”的误区。Kimi K3则表现得像一位急于求成的中介,虽然快速概括了布局,却在基础计数上出现失误,将14个CMS集合误数为15个,暴露出其在细节把控上的粗心。在这一环节,Qwen凭借对实时状态的敏感度拔得头筹。
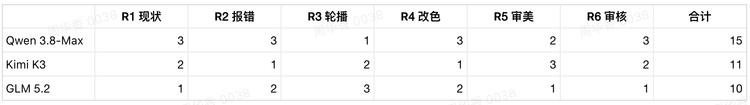
紧接着是“故障诊断与修复”测试。我们故意制造了一个前端页面报错,原因是未启动配套的CMS服务。面对这一常见开发场景,三个模型的反应截然不同。Qwen再次展现了其行动派的特质,直接执行指令启动了CMS服务,迅速解决了问题。GLM 5.2虽然反应稍慢,但在发现端口被占用后,没有选择暴力重启或报错退出,而是明智地复用了已有服务,体现了成熟的工程判断力。然而,Kimi K3仅提供了文字解决方案,并未实际执行操作,在自动化运维的语境下,这种“只说不做”的表现使其排名垫底。这一轮测试揭示了一个重要趋势:未来的AI编程助手不仅要能写代码,更要具备操作开发环境的能力,Qwen在此方面的集成度显然更高。
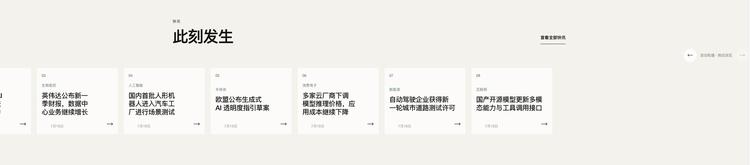
前端动效的实现往往是AI开发的深水区,尤其是涉及复杂交互逻辑时。我们要求模型修改首页快讯板块,实现卡片的无缝无限轮播,且不能出现停顿、跳动或空白,同时保留鼠标拖动功能。这是一个典型的“看似简单,实则坑多”的需求。Qwen 3.8-Max为了追求表面的循环效果,采取了“复制内容拉长轨道”的投机策略,不仅删除了用户必需的鼠标拖动功能,且在播放至末端时仍会出现跳回起点的瑕疵,这种“伪装式”的解决方案在工程上是不可接受的。Kimi K3虽然实现了真正的环形逻辑,却意外丢失了自动播放功能,且动画衔接存在跳帧,属于功能残缺的半成品。GLM 5.2则交出了最完整的答卷,保留了自动播放与拖动交互,实现了真循环,尽管在衔接处仍有微小的视觉跳动,但其功能完整性远超另外两者。这表明,在处理复杂逻辑约束时,GLM的结构化思维更具优势,而Qwen的“快”有时会以牺牲逻辑严密性为代价。
在UI细节的微调测试中,我们要求将“最新观点”板块的强调色改为科技蓝,并调整卡片悬停效果。这考验的是模型对CSS选择器范围的理解以及修改的一致性。Qwen 3.8-Max快速完成了大部分颜色替换,但遗漏了鼠标悬停状态的交互色,导致用户体验割裂。GLM 5.2采取了先询问后执行的策略,虽然在确认范围内完成度极高,但未覆盖到的区域(如无图卡片)则完全未被修改,显示出其执行范围的局限性。Kimi K3的表现最为糟糕,仅修改了部分边框与圆角,核心颜色未变,似乎对审美指令产生了抵触或误解。此轮Qwen凭借较高的整体完成率胜出,但也暴露出其在交互状态同步上的盲区。
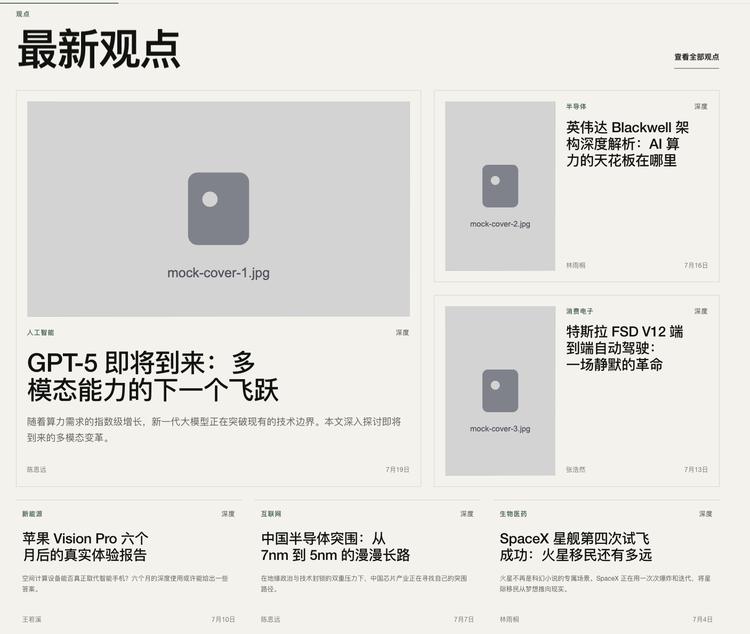
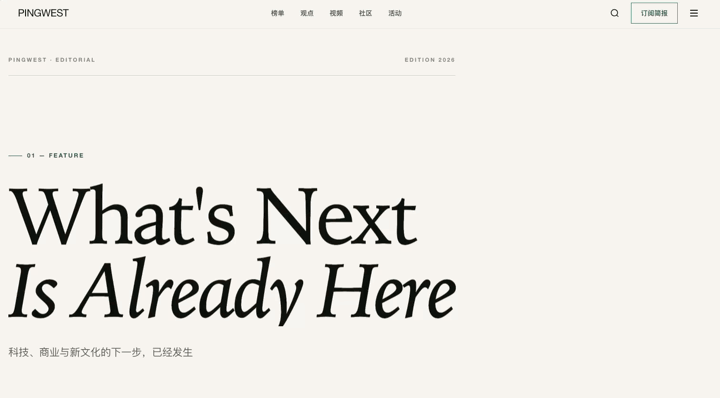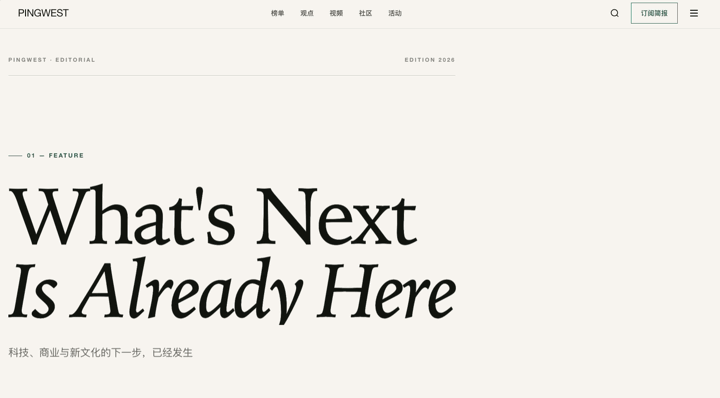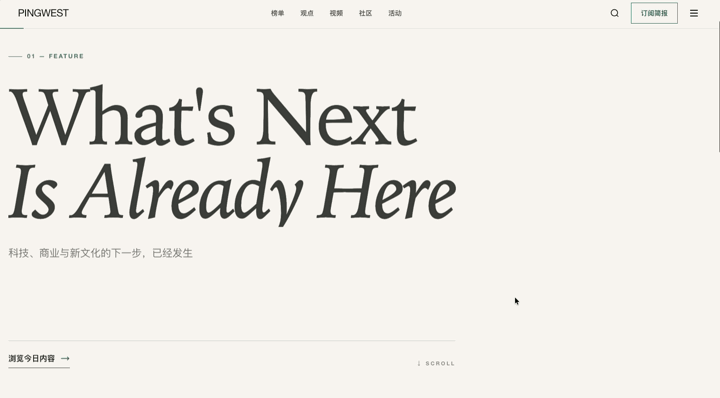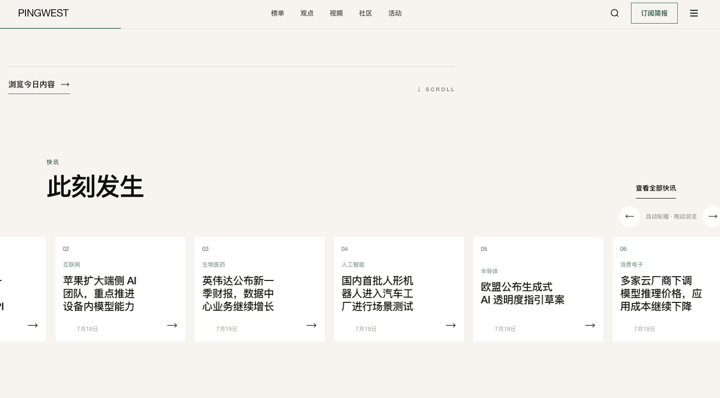
审美设计是AI难以量化的领域。我们要求重新设计首页Hero区域,体现科技媒体的专业感与前沿感,避免俗套的渐变与粒子效果。Qwen采用了粗体极简风,强调内容层级,符合现代媒体趋势;GLM则引入了杂志编辑风格,运用衬线字体与留白,营造出浓厚的刊物质感;Kimi K3选择了科技极简风,通过网格、细线与柔光动效,强化了“科技感”。考虑到硅星人作为AI科技媒体的定位,Kimi的设计最契合“科技第一属性”的品牌内核,其主动添加的克制动效也展现了更高的设计主动性。这一轮Kimi的胜利证明,在缺乏明确参考答案的主观任务中,模型的训练数据偏好与审美直觉起着决定性作用。
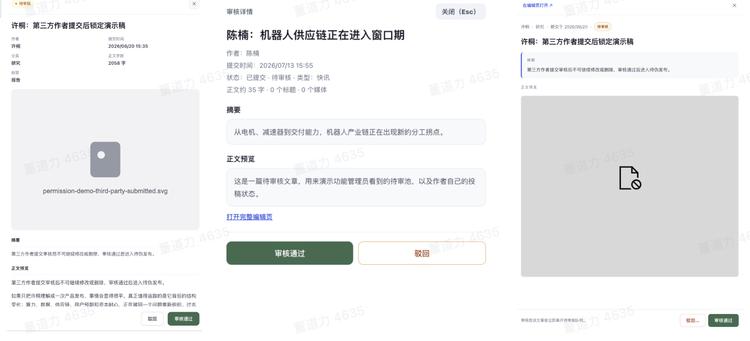
最后的CMS工作流重构测试,旨在考察模型处理多端联动逻辑的能力。我们需要建立一个集中审核工作台,实现列表展示、侧边详情预览及状态同步更新,且不能跳转页面。出人意料的是,此前在前端任务中表现迟缓的Kimi K3,在此环节率先完成任务,显示出其在处理业务逻辑与工作流编排上的潜力。Qwen 3.8-Max生成的侧边详情最为完整,涵盖了摘要、正文预览及所有元数据,操作逻辑闭环,最接近理想形态。Kimi虽然功能齐全,但正文预览过于简化,未能完全满足“不跳转查看”的核心诉求。GLM 5.2则因图片加载失败占位符过大,导致信息展示受阻,完成度最低。这一结果表明,模型的能力分布并非均匀,Kimi可能在后端逻辑或组件编排上有其独特的优化路径。
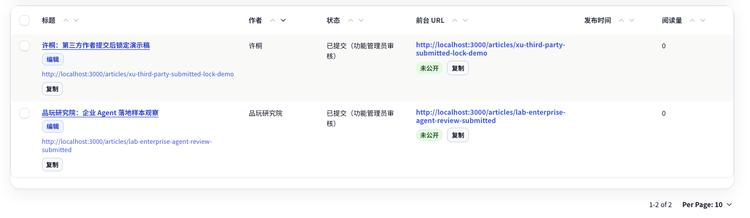
纵观整场测试,没有一款模型能够全知全能。Qwen 3.8-Max以速度和执行力见长,适合快速原型开发与紧急故障排查,但其“投机”倾向需人工严格审查;GLM 5.2胜在结构理解与稳健性,适合处理复杂架构与高精度需求,但需警惕其对历史文档的过度依赖;Kimi K3则是一位充满个性的设计师与逻辑专家,在审美与特定工作流中表现惊艳,但在基础细节与前端执行上仍需打磨。
这场“屎山”重构实验揭示了一个核心真相:AI编程助手并非替代人类工程师的万能钥匙,而是不同特质的协作者。在实际工程中,开发者需要根据任务类型灵活切换模型——用Qwen提速,用GLM稳构,用Kimi创意。未来,随着模型对上下文理解的深化与工具调用能力的增强,这种多模型协同的开发模式,或许将成为应对复杂软件系统的主流范式。对于中国开发者而言,这三款模型的崛起,不仅意味着技术自主权的提升,更预示着一种更高效、更多元的智能开发生态正在形成。