Vera CPU揭秘:英伟达如何以AI原生架构颠覆传统数据中心算力格局
从算力硬件到智能体操作系统:Vera CPU的技术破局
在人工智能基础设施演进的历史长河中,计算架构的每一次迭代都伴随着工作负载重心的转移。长期以来,GPU因其强大的并行计算能力,成为训练大模型和加速推理的核心引擎,而CPU则退居为数据预处理和任务调度的辅助角色。然而,随着Agentic AI(智能体AI)范式的兴起,这一固有格局正在发生根本性逆转。
智能体AI并非简单的单次问答,而是一个包含代码执行、工具调用、数据库交互、上下文检索及结果分析的复杂闭环过程。这种多步推理机制将大量的关键执行路径从GPU转移到了CPU上。CPU不再是被动等待指令的“加速器”,而是成为了控制密集型循环、管理并发上下文的核心决策者。正是在这种背景下,英伟达于AMD “Advancing AI 2026”大会前夕,抢先发布了Vera CPU的详细技术架构。这不仅是英伟达继Grace CPU之后在通用处理器领域的又一重大落子,更是其从“卖显卡”向“卖AI工厂”垂直整合战略的彻底摊牌。
Vera CPU被明确定义为全球首款从核心层面专为代理式AI量身定制的处理器。它代表了英伟达对AI工作负载本质变化的深刻洞察:未来的数据中心竞争,不再仅仅是GPU算力的堆砌,而是CPU在处理复杂逻辑、管理内存带宽以及优化指令流水线方面的综合较量。
Olympus架构:专为智能体逻辑打造的神经引擎
Vera CPU的核心竞争力源于其全新的Olympus核心架构。与传统的x86或ARM架构不同,Olympus的设计初衷并非为了兼容旧有的通用计算负载,而是为了极致优化智能体运行时的特定行为模式。
智能体在运行过程中,面临着极高的分支预测挑战。代码在沙箱中执行时,逻辑分支往往具有高度的不规则性和不可预测性。传统的静态或基于历史的分支预测器在处理长依赖链和指针密集的数据结构时,容易出现误判,导致流水线停顿,从而严重拖慢整体性能。为了解决这一痛点,Olympus核心引入了业界首创的神经分支预测器(Neural Branch Predictor)。
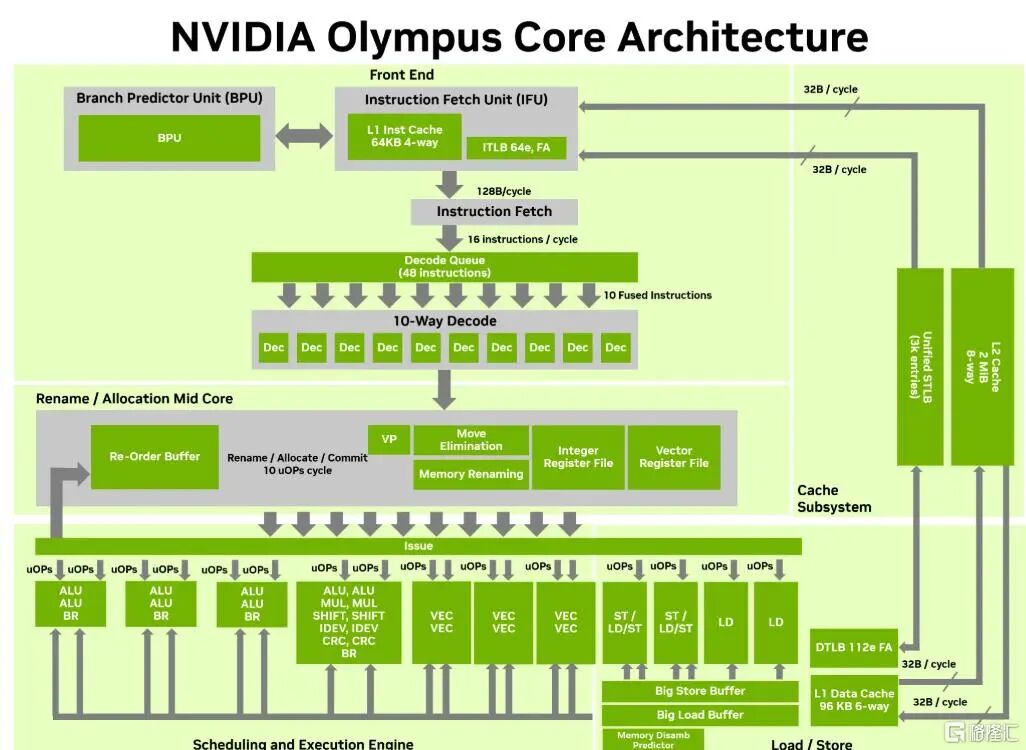
这一“黑科技”利用神经网络模型实时学习代码执行的模式,能够更精准地预测复杂逻辑分支的走向。配合10-wide的解码引擎,Vera能够高效吞吐智能体运行时的复杂指令流。单颗Vera芯片集成了88个Olympus核心,支持176个线程。值得注意的是,其设计重心明显偏向“宽发射、深流水线”,旨在确保即使在满负载条件下,单线程性能依然强劲。
此外,Vera还是首款在CPU核心中原生支持FP8精度的处理器。这一特性极大地打通了CPU与GPU之间的数值计算壁垒。在智能体进行中间结果计算或轻量级推理时,CPU可以直接使用FP8格式进行处理,无需频繁在数据格式转换和总线传输上耗费时间,从而显著降低了延迟并提升了能效比。
内存带宽革命:SOCAMM2与LPDDR5X的协同效应
在智能体并发执行的场景中,内存带宽往往是制约性能的隐形杀手。传统服务器架构中,CPU核心数量越多,对内存带宽的竞争就越激烈,导致每个核心的有效带宽被稀释。对于需要同时维护数千个活跃执行上下文的智能体而言,数据供给的延迟是不可接受的。
Vera CPU通过创新的SOCAMM2 LPDDR5X内存方案,彻底打破了这一瓶颈。该方案实现了1.2TB/s的惊人内存带宽,这一数值是传统DDR5服务器架构的两倍,而功耗却不到后者的一半。
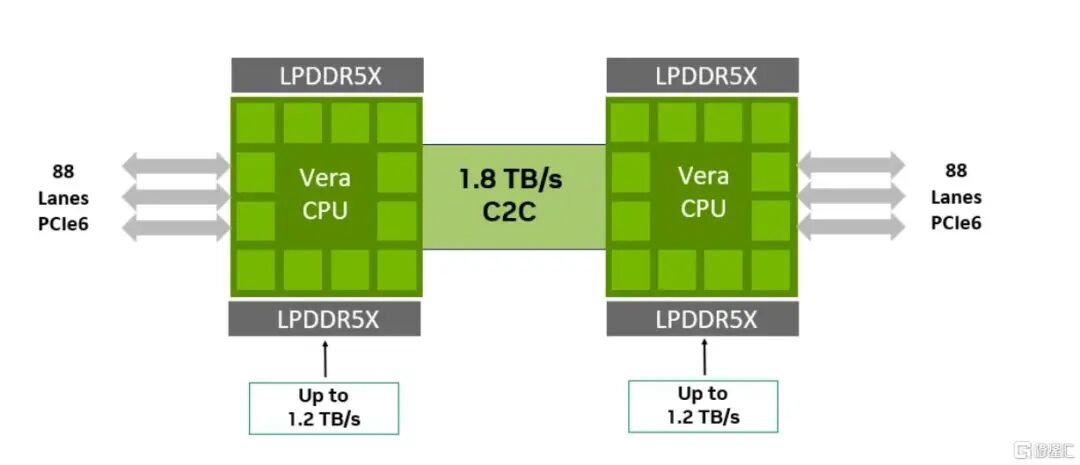
英伟达在架构设计上采用了高度优化的片上网络(NoC)和缓存层级,确保数据能够以最低延迟送达核心。在压力测试中,Vera能够维持在90%以上的峰值带宽利用率。这意味着,即便在数千个智能体并发运行、频繁进行内存读写操作时,数据供给依然源源不断,不会出现因等待内存数据而导致的CPU空转现象。这种高带宽、低延迟的内存架构,为智能体系统的稳定性与响应速度提供了坚实的物理基础。
性能基准实测:超越传统x86的维度打击
为了验证Vera CPU在智能体负载下的实际表现,英伟达公布了一系列详尽的基准测试数据。这些数据显示了Vera在面对特定AI工作负载时,相较于传统顶级x86服务器架构的显著优势。
在单线程性能方面,Vera在满载条件下的表现可达传统x86 CPU的1.8倍。这一提升对于智能体的关键路径执行至关重要,因为许多同步操作和逻辑判断依然依赖单核性能。
在任务效率方面,Vera使AI智能体任务的综合性能提升了约50%。特别是在沙箱环境中的运行速度,由于分支预测和指令吞吐效率的提升,改善尤为显著。
并发能力是Vera的另一大亮点。它支持多达1.6倍的并发智能体运行,编排速度提升高达2.2倍。这表明Vera在处理大量轻量级、高并发任务时,具有极强的扩展性和调度能力。
此外,在编译速度测试中,单颗Vera编译Linux内核仅需约20秒。每核编译效率约为128核顶级x86服务器的2倍。这一数据不仅展示了其在开发工具链上的优势,也暗示了其在构建自动化AI基础设施时的效率优势。
垂直整合战略:从卖硬件到卖“AI工厂”
长期以来,市场将英伟达牢牢贴上“GPU巨头”的标签。然而,深入剖析其最新财报与产品路线图,一个清晰的新信号已经释放:英伟达正在系统性地摆脱对单一GPU销售的依赖,围绕AI基础设施的全栈化布局,打开了多条新的收入曲线。
Vera CPU的推出,是这一战略的关键一环。黄仁勋曾明确指出:“CPU让智能体等待的每一刻,都是整栋建筑里最昂贵的东西。GPU处于闲置状态的一刻,意味着巨大的资源浪费。”Vera的设计初衷,正是为了消除这种等待,让GPU能够始终处于高效工作状态。
这一举措标志着英伟达正式杀入了由英特尔与AMD长期统治的服务器CPU腹地。但这并非简单的正面竞争,而是基于AI工作负载重构的竞争。英伟达副总裁兼CFO科莱特·克雷斯透露,预计2027财年CPU总收入有望接近200亿美元。若这一目标达成,英伟达将有机会成为全球领先的CPU供应商之一,尽管其市场份额基数可能不如传统巨头,但其增长潜力和利润空间不可估量。
与此同时,英伟达的网络互联业务也在爆发式增长。2027财年第一季度,数据中心网络收入创下148亿美元纪录,同比暴增199%。随着AI集群从千卡迈向十万卡规模,NVLink、InfiniBand与Spectrum-X已成为构建“AI工厂”的刚需。网络业务占数据中心总收入的比重已攀升至约20%。这表明,英伟达已不仅仅是卖算力的公司,更是卖“连接”的公司。通过物理层面的互联壁垒和专用的CPU、GPU、网络芯片组合,英伟达锁死了系统级竞争力。
供应链与生态布局:Vera Rubin NVL72的量产爬坡
技术落地的关键在于供应链的稳定性。英伟达透露,搭载Vera CPU的Rubin NVL72平台已进入量产爬坡阶段。该平台的供应链网络覆盖了全球350多个工厂、30个国家,超过300家合作伙伴参与其中。
这种全球化、多元化的供应链布局,不仅确保了Vera CPU的大规模交付能力,也增强了英伟达应对地缘政治风险和市场需求波动的韧性。目前,Vera CPU已经交付给OpenAI、Anthropic等头部AI客户进行测试和生产部署。这些早期采用者的反馈,将成为优化下一代处理器迭代的重要数据来源。
对于云计算服务商和大型企业而言,Vera CPU的引入意味着他们可以在现有数据中心基础设施中,更有效地运行智能体应用。无需为了适配AI工作负载而重构整个硬件架构,英伟达提供的是一种从底层芯片到上层软件栈的端到端解决方案。
行业影响与未来展望:CPU角色的重新定义
Vera CPU的发布,对整个半导体行业和AI生态系统产生了深远影响。首先,它重新定义了CPU在AI时代的角色。CPU不再是通用的、万能的,而是需要根据特定工作负载进行高度定制化的。Olympus架构的成功,可能预示着未来出现更多针对特定AI范式(如多模态、具身智能)优化的专用CPU设计。
其次,Vera CPU对英特尔和AMD构成了实质性挑战。尽管x86架构在通用计算领域仍占据主导地位,但在智能体AI这一新兴且高增长的领域,英伟达凭借垂直整合优势,正在建立新的技术标准。英特尔和AMD若不能加快针对AI负载的架构创新,可能会在高端AI基础设施市场逐渐边缘化。
最后,Vera CPU的普及将加速AI应用的落地。通过降低智能体的推理延迟和运营成本,更多企业将敢于尝试复杂的AI智能体应用,如自动化代码生成、智能客服代理、自动化科研辅助等。这将进一步繁荣AI生态,形成芯片创新与应用落地的良性循环。
综上所述,Vera CPU不仅是英伟达技术实力的体现,更是其战略野心的一览无余。它标志着AI基础设施竞争已进入全栈整合、专用硬件加速的新阶段。在这个新阶段,谁能更好地理解并优化AI工作负载,谁就能掌握未来的算力话语权。英伟达通过Vera CPU,正在书写这一新篇章。