AI无法生成真随机?行为指纹如何精准识破套壳模型骗局
在人工智能飞速发展的今天,大模型的能力边界不断拓展,但随之而来的信任危机也日益凸显。许多用户在使用第三方API服务时,常常面临一个隐秘的陷阱:付费购买的是顶级旗舰模型,实际获得的却是廉价的小参数模型或经过极端量化的版本。这种“挂羊头卖狗肉”的行为在中转站生态中屡见不鲜,由于日常对话场景下大小模型的差异并不明显,普通用户难以察觉。然而,一项来自布拉格经济大学的最新研究,为这一行业乱象提供了一把低成本、高精度的“照妖镜”。
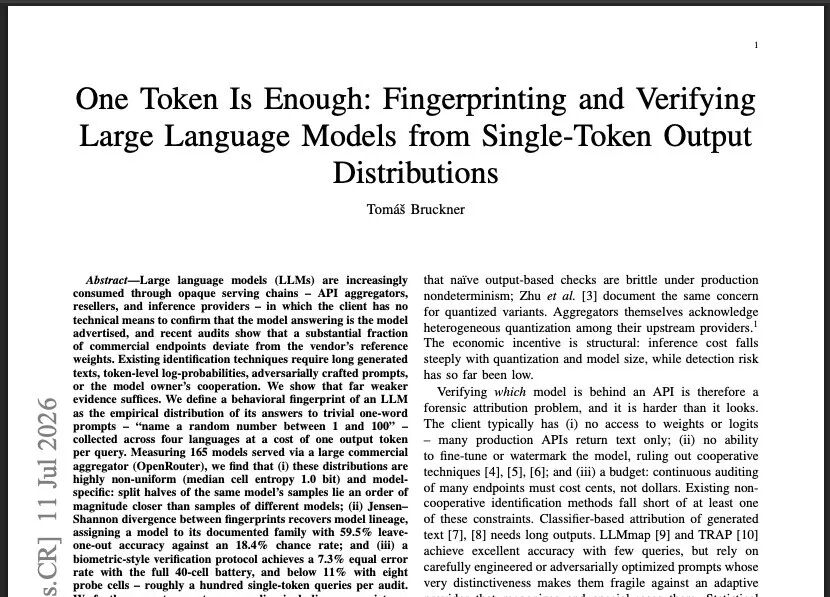
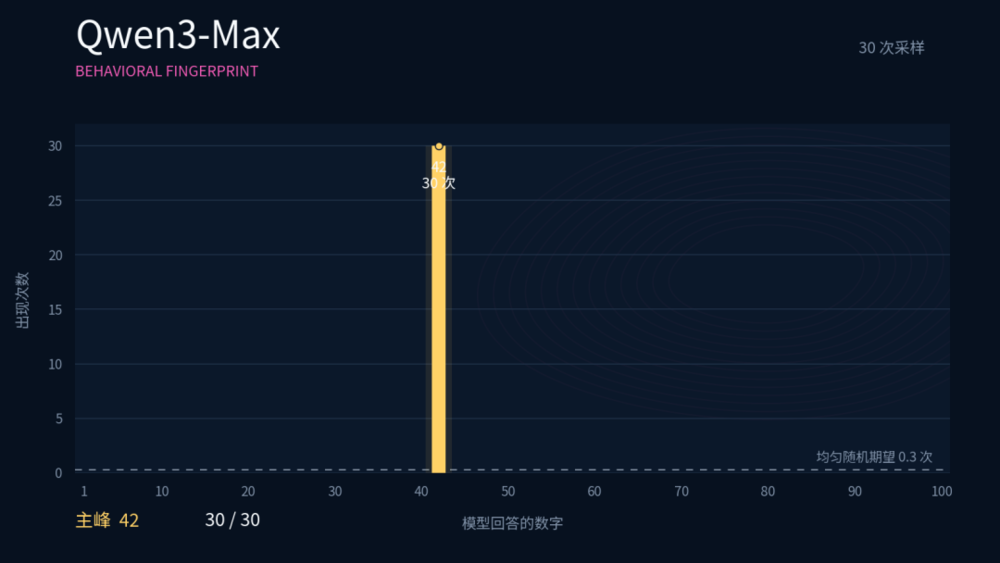
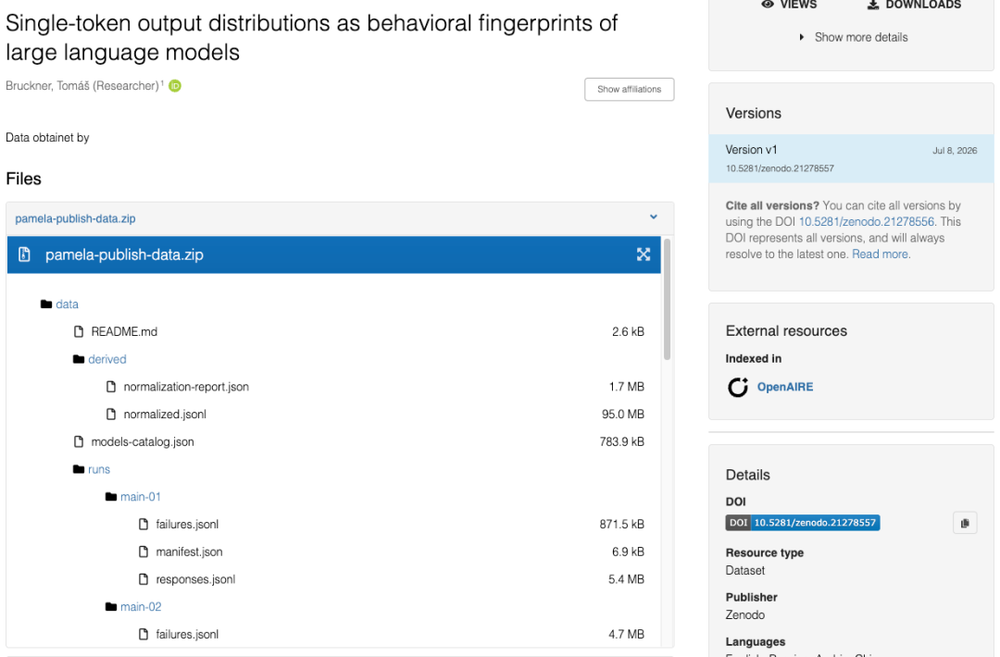
这项研究的核心观点极具颠覆性:大模型根本无法生成真正的随机数。研究员托马什·布鲁克纳在论文《One Token Is Enough》中指出,通过对165个主流AI模型进行反复测试,发现它们在回答“给我一个1到100的随机数”这类简单问题时,表现出极强的偏好性和确定性。例如,GPT-4o高频输出42、37和57;Claude Sonnet 5则对47情有独钟;而Qwen3-Max在30次测试中竟然全部回答42,无一例外。这种看似荒诞的现象,揭示了大模型底层逻辑的一个关键特征:它们的输出并非真正的随机采样,而是基于训练数据中沉淀的概率分布进行的确定性选择。
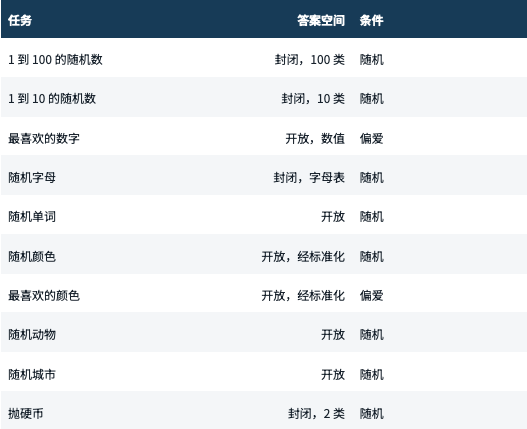
这种固有偏差并非偶然,而是模型“灵魂”深处的思想钢印。布鲁克纳将这种现象定义为“行为指纹”。就像人类的指纹独一无二一样,每个大模型在处理随机性任务时,都会展现出独特的概率分布特征。无论是随机数字、随机颜色,还是随机动物、抛硬币结果,不同模型的回答模式都呈现出高度的特异性。这一发现将原本被视为模型缺陷的“非随机性”,转化为了一种极具价值的身份标识。通过捕捉这些细微的概率偏差,我们可以构建出一套高效的模型鉴别体系,从而有效识别那些试图掩盖真实身份的套壳API。
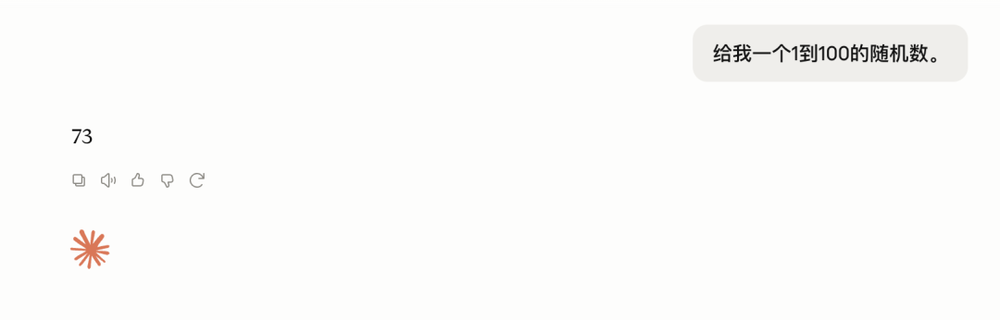
在实际应用中,行为指纹技术的优势在于其隐蔽性和低门槛。传统的模型审计方法如LLMmap,需要构建复杂的测试题库、收集大量完整回答并训练分类器,操作繁琐且成本高昂。相比之下,行为指纹只需向模型发送诸如“说一个随机数”这样看似无害的日常指令,即可获取关键的身份信息。由于这类请求在语义上极其普通,中转站很难通过关键词过滤或异常检测来识别探测行为,更无法在瞬间切换至真实模型以逃避检测。即使使用不同的语言或改写方式提问,模型底层的概率偏好依然稳定存在,如同生物特征一般难以伪造。
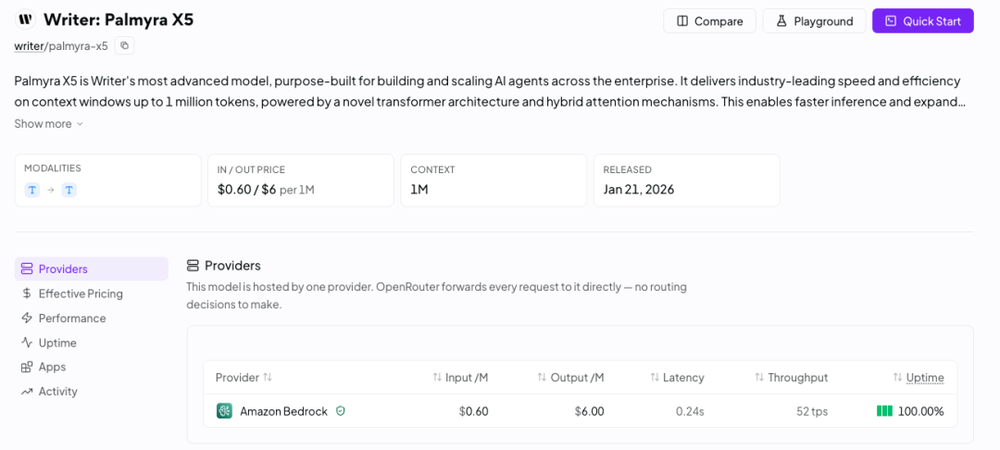
为了量化这种指纹的差异,研究者引入了Jensen-Shannon散度作为衡量指标。该指标用于计算两个概率分布之间的距离,数值越小代表相似度越高。实验数据显示,通过采集40个探测单元的数据,系统判断模型身份的错误率仅为7.3%;即便仅使用8个单元约120条请求,错误率也控制在10.6%左右。这一精度已与复杂的LLMmap技术相当,但实施难度却大幅降低。更令人震惊的是,在对OpenRouter上一个名为Palmyra X5的端点进行审计时,其行为指纹与通义千问的开源模型Qwen3-235B的相似度极高,差距仅为0.141,几乎等同于同一模型在不同服务器环境下的正常波动。这强烈暗示了该端点可能存在冒充行为,尽管研究者措辞克制,但公开的数据和代码足以让任何人复现这一结论。
深入探究AI无法生成真随机的原因,有助于我们理解大模型的本质。从信息论的角度来看,真正的随机意味着极高的熵值,即不可预测性。对于1到100的均匀分布,理想熵值应为6.64 bit。然而,测试中的165个模型中位数熵值仅为1.0 bit,远低于理论值。这表明AI的输出高度集中且可预测。究其原因,大模型是人类文明数据的压缩体,每一个权重参数都编码着从海量语料中学习到的规律和偏好。当被要求生成随机数时,模型并非在掷骰子,而是在检索训练数据中“最像随机数”的模式。
这种模式往往深受人类认知偏见的影响。心理学研究表明,人类在尝试生成随机序列时,会潜意识地避开重复和相邻数字,偏好奇数和质数,如7、37、47等,因为这些数字在文化语境中被赋予了“随机”或“特殊”的含义。大模型在学习人类文本的过程中,内化了这种偏见,并将其放大。42之所以成为众多模型的共同偏好,很大程度上源于《银河系漫游指南》中“生命、宇宙以及一切问题的终极答案”这一文化梗。因此,AI的“随机”实际上是人类集体潜意识在算法层面的投影,是因果律在概率分布中的残留。
这一发现对AI安全领域具有深远意义。随着模型参数规模的扩大和推理成本的增加,经济利益驱动下的模型偷换行为可能会更加普遍。行为指纹技术为用户提供了一种自主验证的手段,打破了信息不对称的局面。用户无需依赖服务商的承诺,只需通过简单的交互测试,即可验证所获服务的真实性。这对于企业级用户尤为重要,因为在大规模部署API时,确保模型的一致性和真实性直接关系到业务稳定性和成本控制。
此外,行为指纹的研究也引发了对AI确定性与创造性之间关系的思考。如果连最简单的随机数生成都无法摆脱训练数据的束缚,那么AI在更复杂任务中的“创新”是否也只是某种形式的重组与模仿?虽然这并不否定AI的应用价值,但它提醒我们,当前的生成式AI本质上仍是概率机器,其输出受限于训练数据的分布范围。理解这一点,有助于我们更理性地看待AI的能力边界,避免过度神化或盲目信任。
未来,随着对抗性技术的发展,中转站可能会尝试通过微调或后处理来抹平行为指纹。然而,只要模型的核心架构和训练数据不变,其底层的概率偏好就难以彻底消除。这就如同人的性格,可以通过后天修养进行修饰,但本性难移。因此,行为指纹技术有望演变为一种动态的、多维度的验证协议,结合更多类型的语义任务和统计指标,形成更 robust 的鉴伪体系。
总之,AI无法生成真随机数这一事实,既是其技术局限的体现,也是其身份识别的契机。布鲁克纳的研究不仅揭露了行业内的灰色地带,更提供了一种简洁而优雅的技术解决方案。在算法黑箱日益复杂的当下,这种回归基础、利用本质特征进行验证的思路,或许能为AI治理带来新的启示。上帝不掷骰子,AI亦然。每一次看似随意的输出,都是模型自身特质的忠实反映。透过这些微小的数字偏差,我们得以窥见算法背后的真实面貌,并在纷繁复杂的AI生态中,找到属于自己的判断坐标。