Claude Code接入实测:揭秘第三方API选型的三大核心铁律
在人工智能重塑软件开发流程的今天,Claude Code、Cursor等AI编程助手已成为许多开发者的日常标配。然而,随着使用频率的增加,官方API的高昂费用促使大量开发者转向第三方聚合平台。网络上充斥着各类“快速接入教程”,大多止步于配置Base URL和API Key的基础操作。这种浅层的接入往往掩盖了深层的工程陷阱:填对地址只需五分钟,但选错平台可能导致月度账单不降反升,甚至严重拖慢开发节奏。
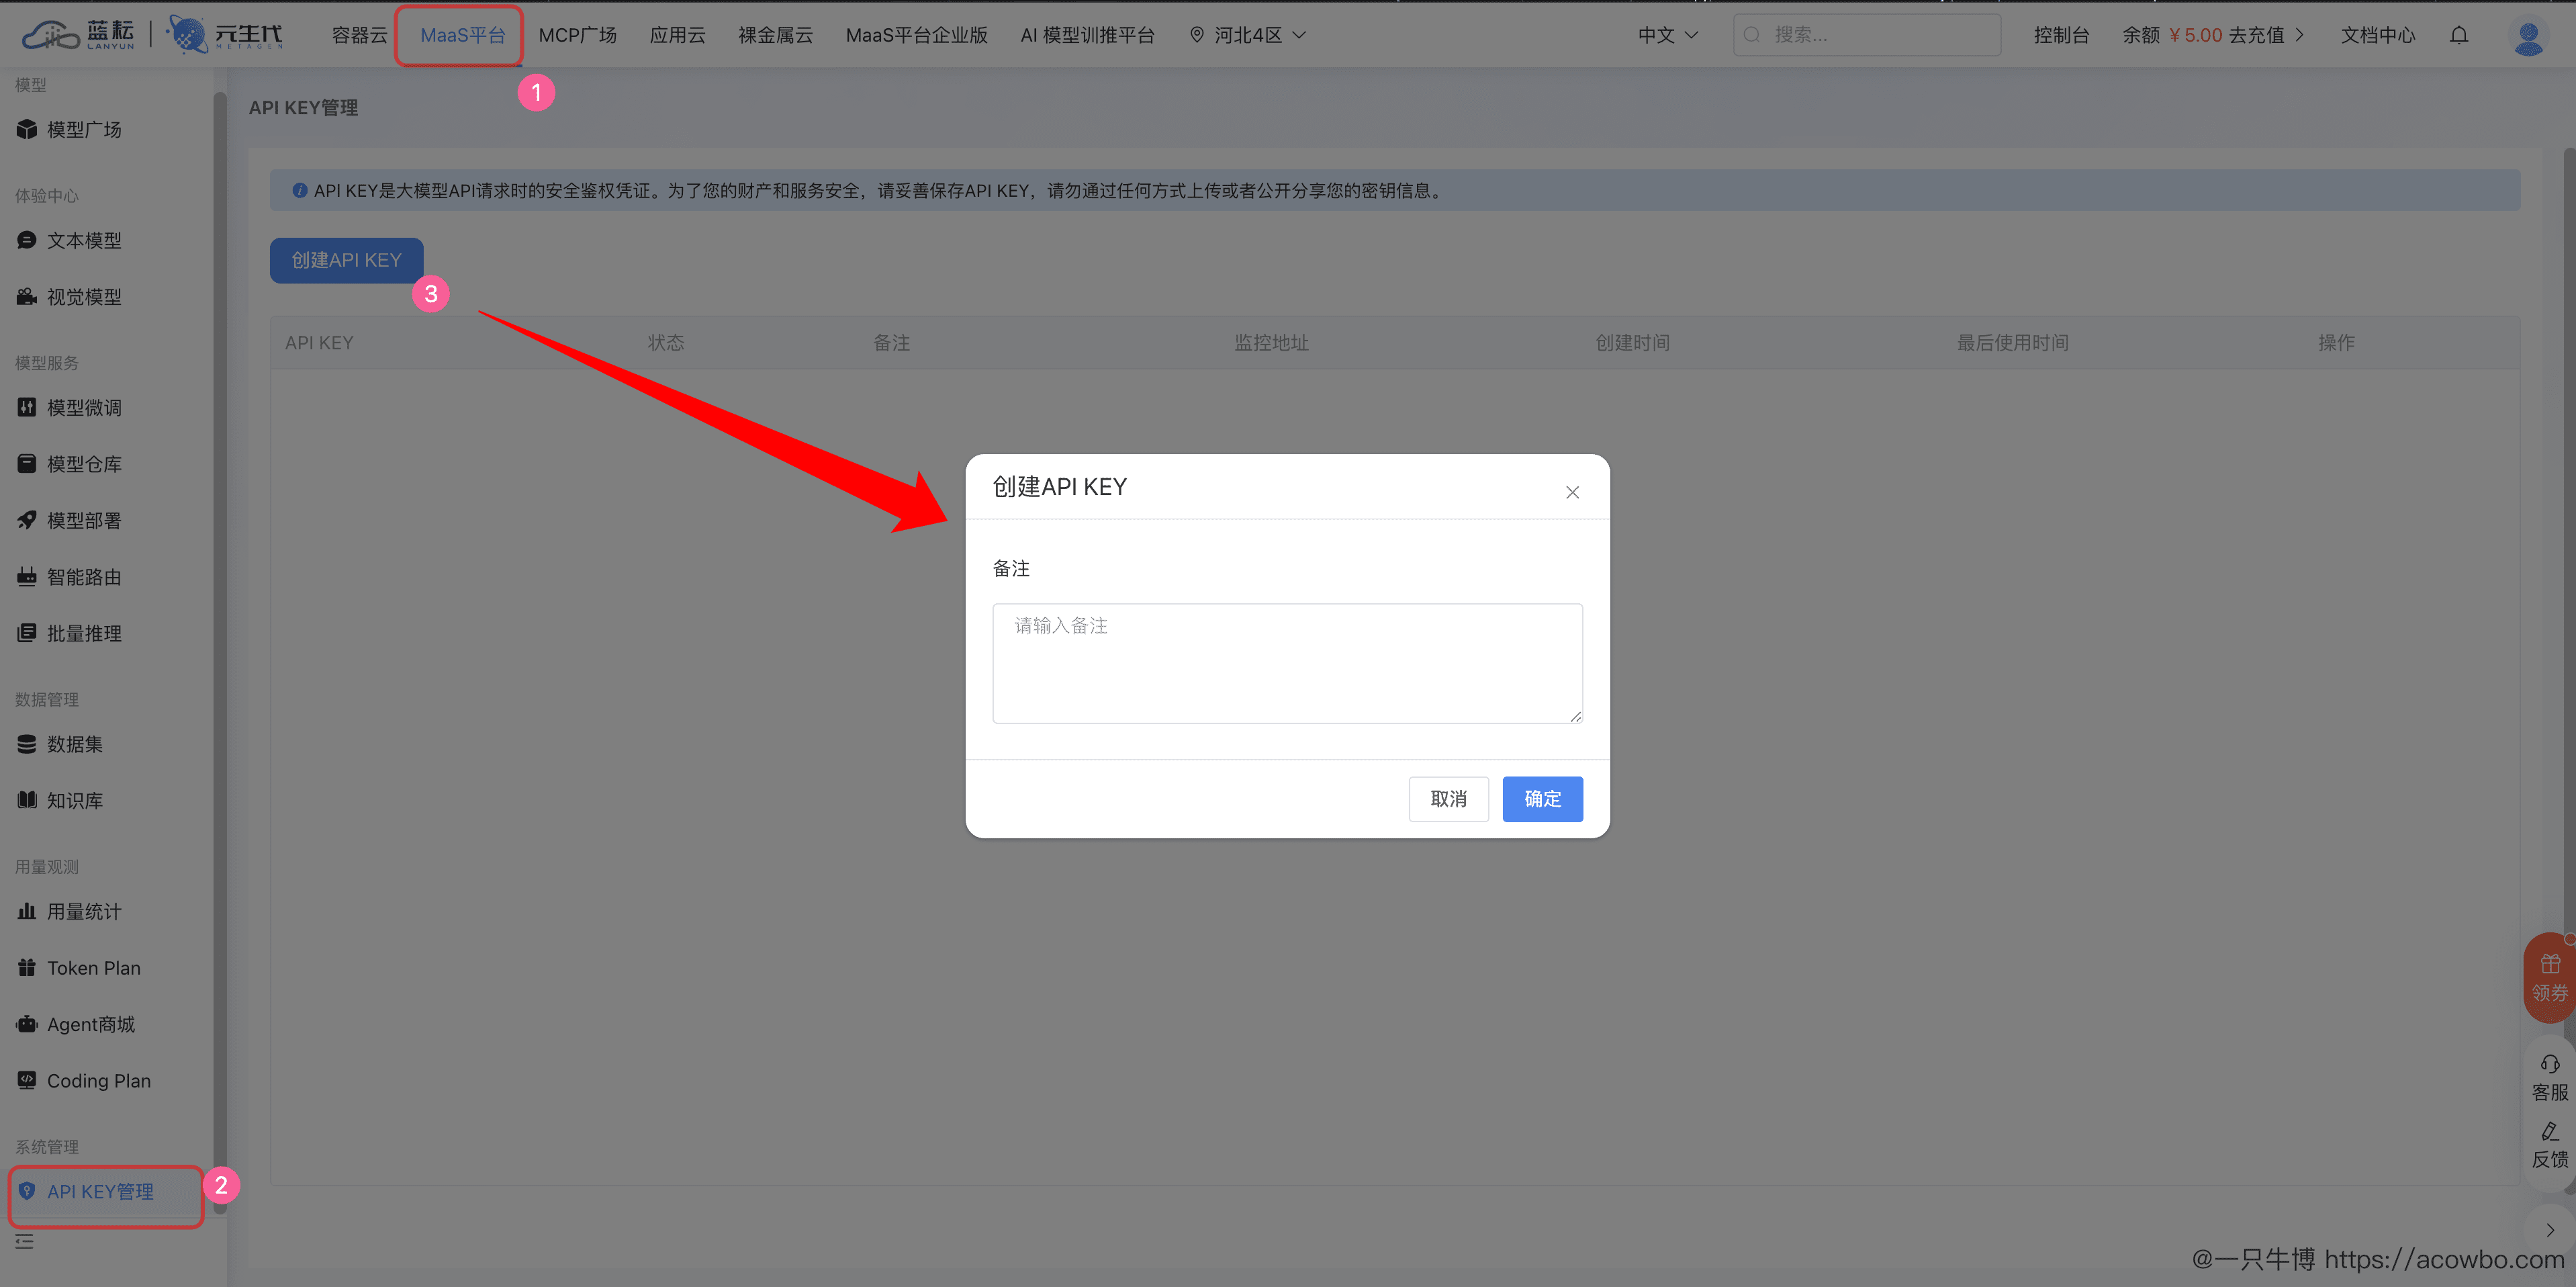
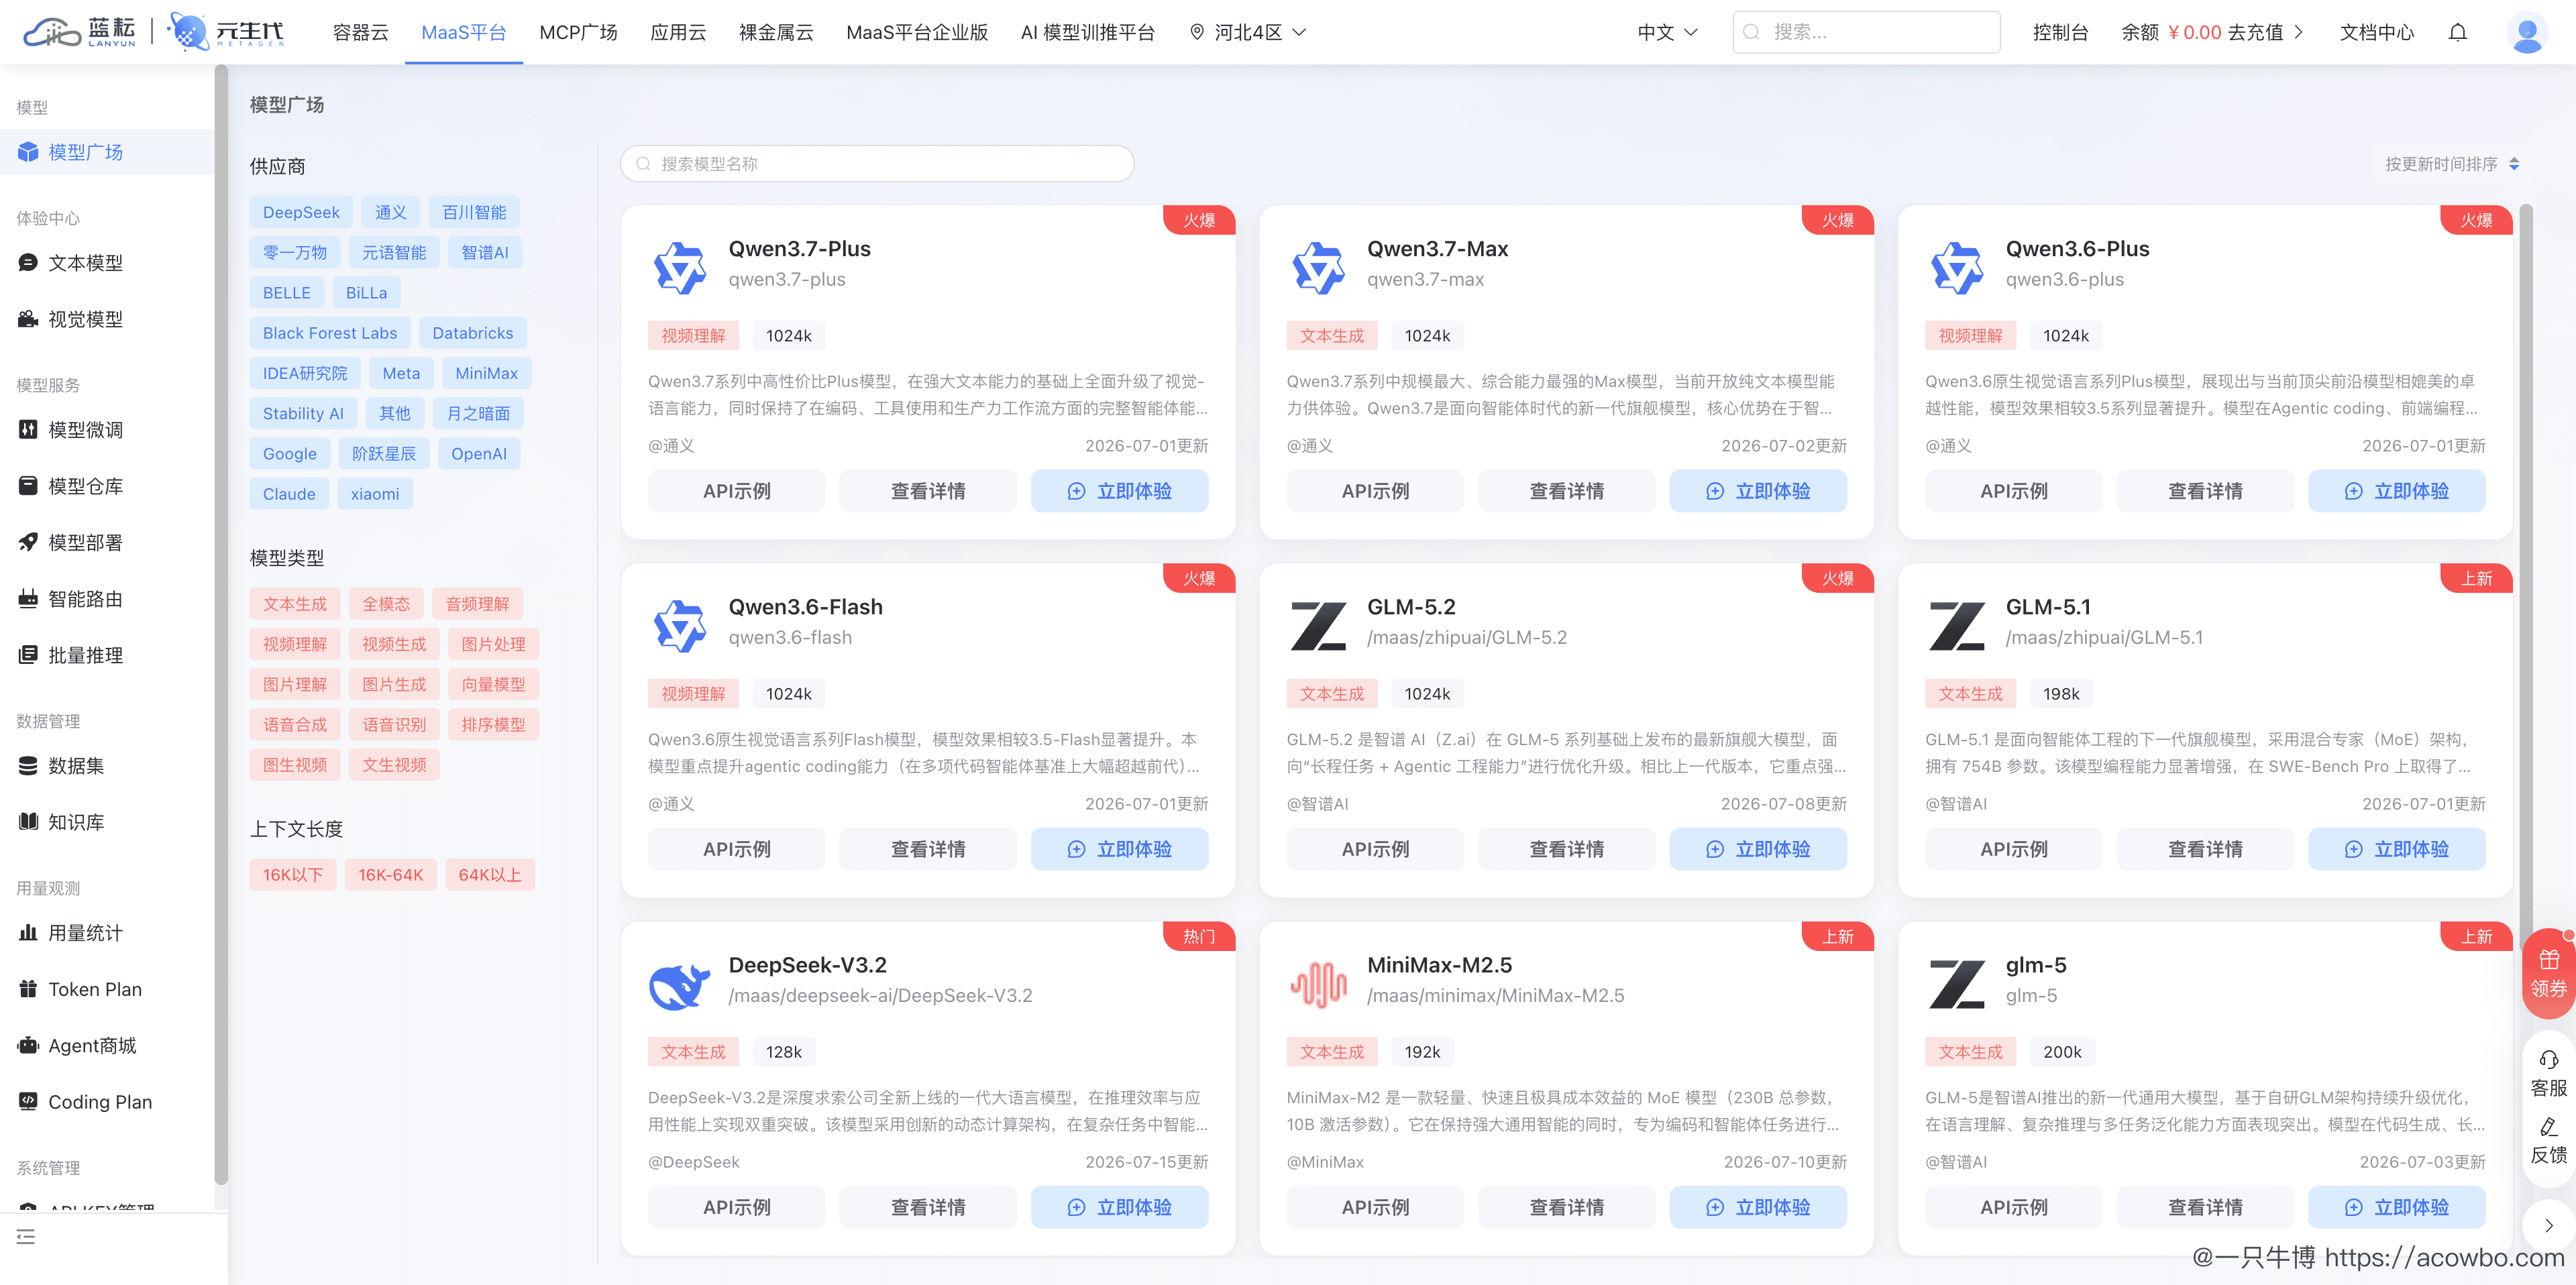
许多开发者在切换服务商后遭遇了两个典型问题:一是响应速度忽快忽慢,导致编码思路频繁被打断;二是看似低廉的单价背后,总消耗量却惊人地增长。经过对蓝耘元生代MaaS平台接入DeepSeek-V3.2模型的长期实测与横向对比,我们发现真正决定API质量的并非表面上的平均延迟或标称单价,而是三个常被忽视的核心指标:尾部延迟的稳定性、提示词缓存的有效性以及Agent工具调用的保真度。
延迟评估的误区:为何平均值毫无意义
在评估API性能时,绝大多数评测报告倾向于展示平均延迟(Average Latency)。对于简单的问答机器人而言,平均值或许具有一定的参考价值,但对于Claude Code这类基于Agent架构的编程助手来说,平均值不仅无用,甚至具有误导性。
Agent的工作模式决定了其交互特征:完成一个复杂的编程任务,往往需要连续发起数十次甚至上百次的工具调用请求。在这一连串的请求链中,只要有一次请求出现严重的延迟抖动(例如从正常的200毫秒飙升至2秒),整个任务的体感流畅度就会瞬间崩塌。平均值会将这些极端的“长尾”数据平滑掉,从而掩盖了真实体验中的痛点。
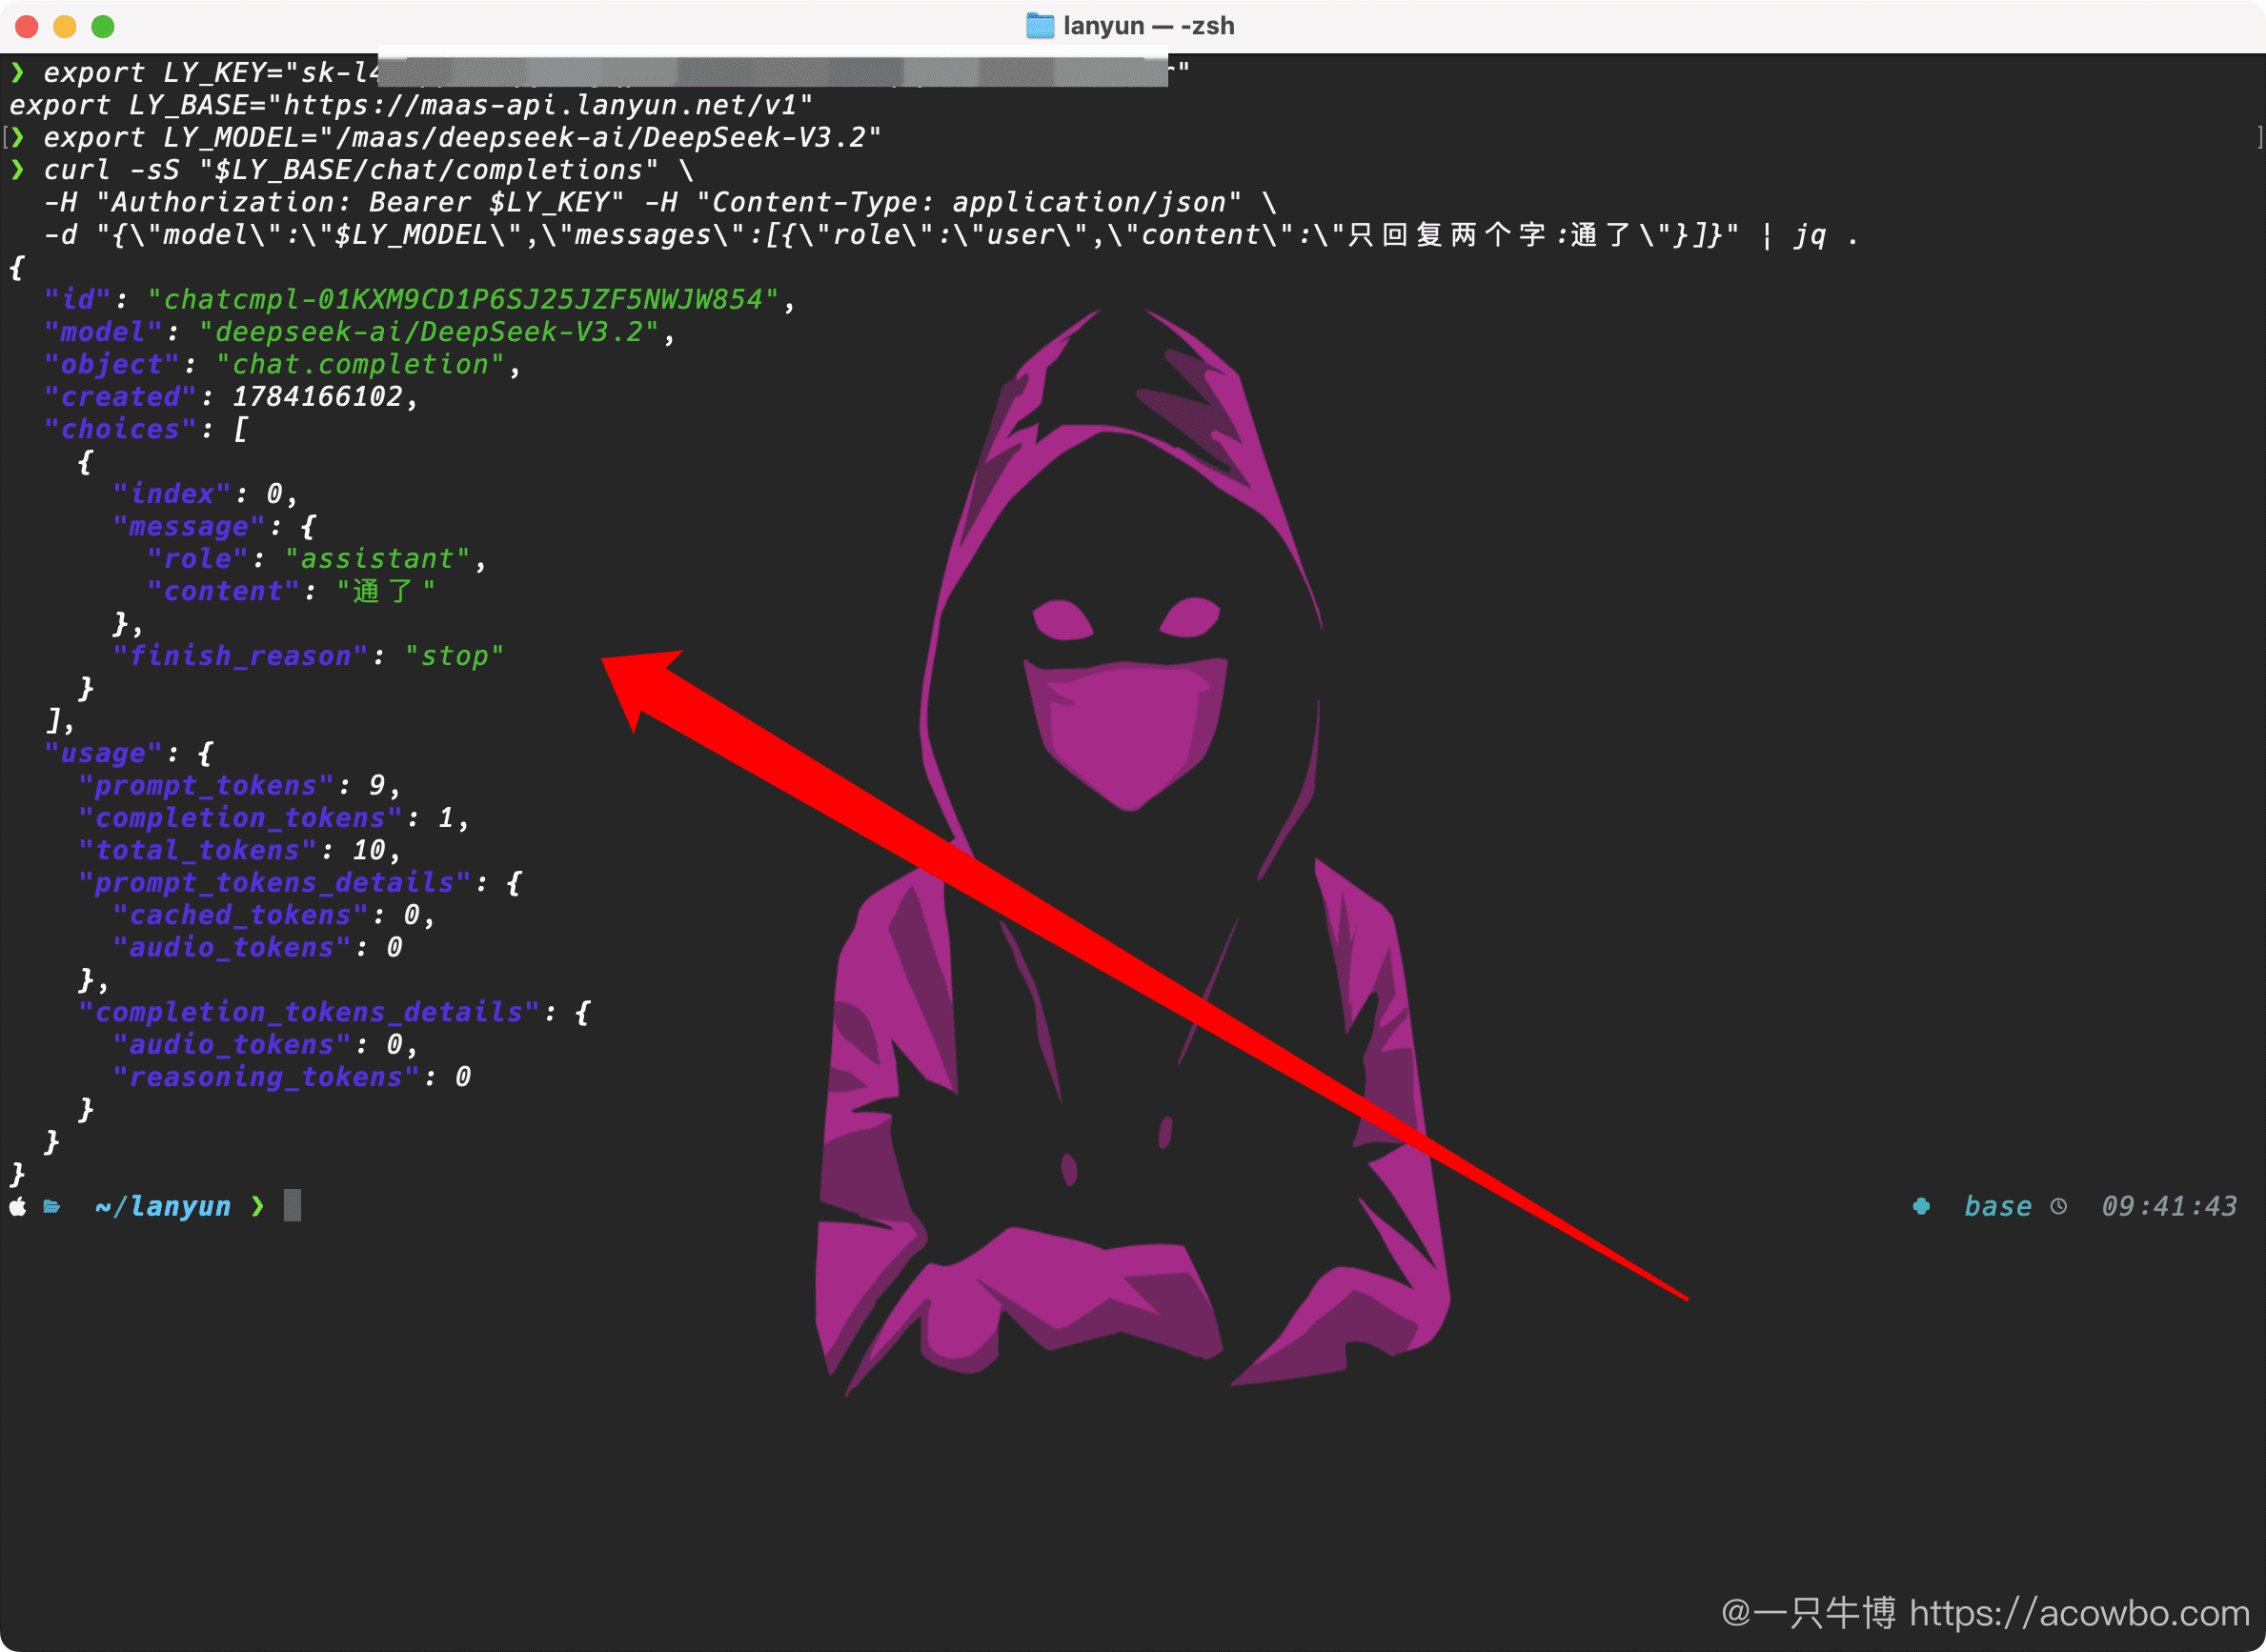
因此,专业的性能评估必须关注尾部延迟,即P95或P99延迟值。这意味着在100次请求中,最慢的那5%或1%的请求耗时是多少。此外,延迟本身也需要拆解为两个独立指标:首字延迟(TTFT)和吞吐率(TPS)。TTFT决定了用户发出指令后系统响应的即时感,直接影响“跟手”程度;而TPS则决定了长代码生成时的等待时间。在对蓝耘与其他主流平台的对比测试中,我们发现虽然某些平台在轻负载下的平均TTFT较低,但其波动幅度极大,标准差远超蓝耘。蓝耘在多次并发测试中,TTFT稳定维持在174至194毫秒之间,这种极低的方差对于维持开发者的心流状态至关重要。
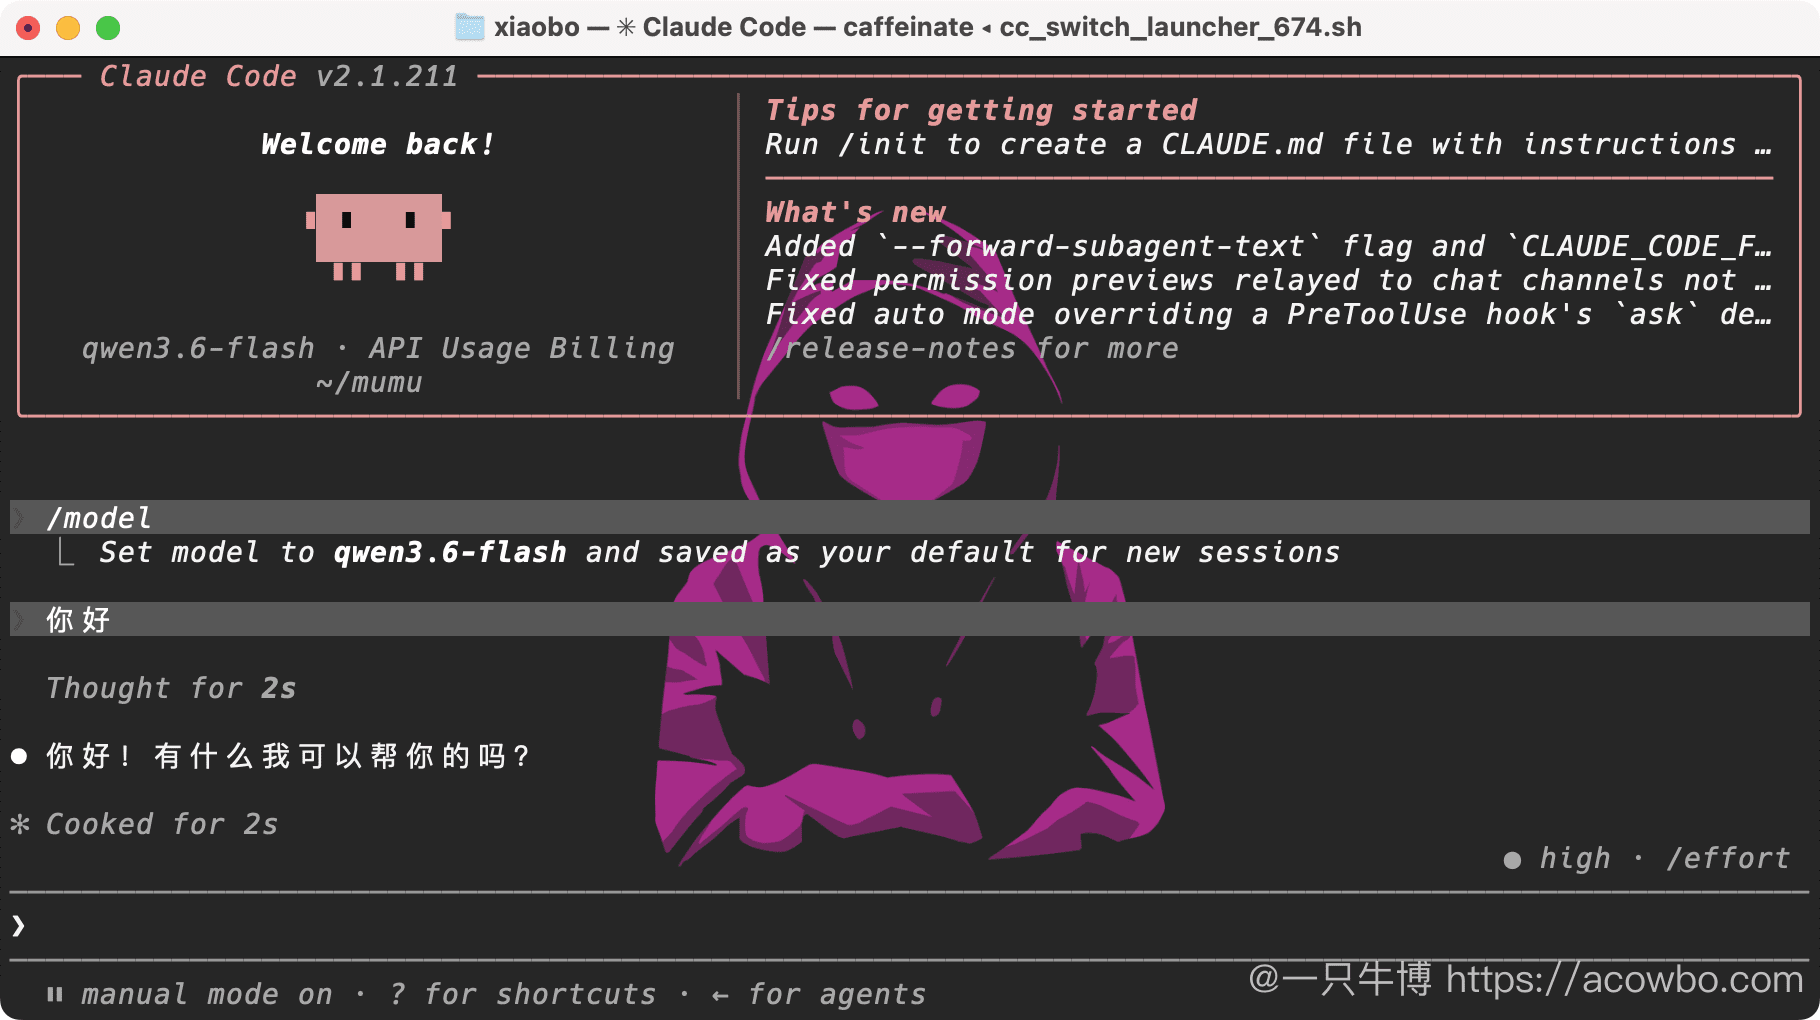
需要注意的是,测试模型的选择也会影响结果。例如,带有思维链(Chain of Thought)能力的推理模型,其TTFT天然较高,因为模型需要在输出前进行内部推理。因此,在评估平台链路本身的网络与调度性能时,应优先使用非推理类的通用对话模型,如DeepSeek-V3.2,以排除模型计算特性带来的干扰。
成本控制的盲点:提示词缓存的决定性作用
如果说延迟影响的是体验,那么缓存机制则直接决定了钱包的厚度。这是许多开发者在切换第三方API时最容易踩中的“隐形坑”。
Claude Code等Agent应用在每一轮对话中,都会将大量的上下文信息重新发送给服务器,包括系统提示词、项目文件结构、依赖定义以及历史对话记录。这些信息动辄数千甚至上万个Token。如果第三方平台不支持提示词缓存(Prompt Caching),或者缓存策略不佳,那么每一轮对话中重复发送的这部分数据都将按全价计费。
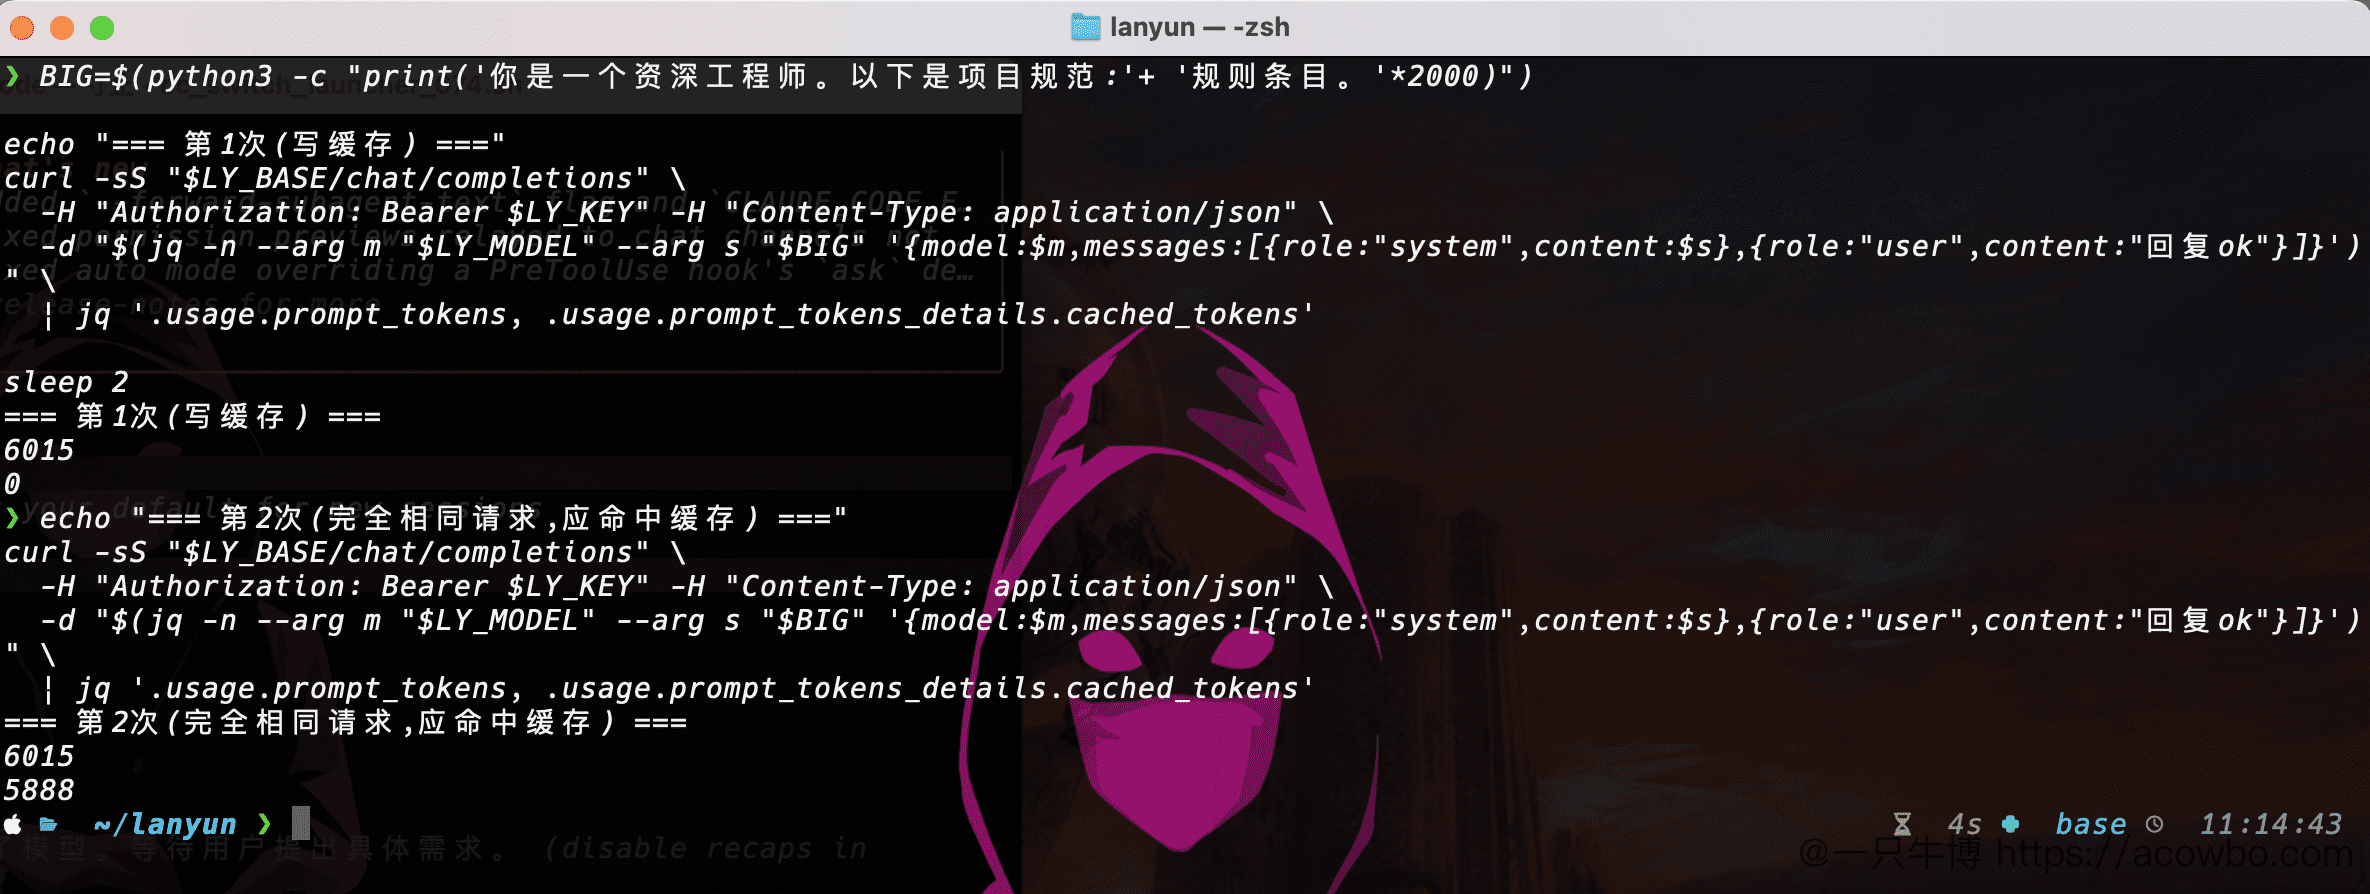
相比之下,支持高效缓存的平台会将相同的前缀内容存入高速缓存,后续请求命中缓存的部分仅收取极低的比例费用(通常为原价的10%-20%)。在实测中,我们构建了一个约6000 Token的系统上下文,并连续发送两次完全相同的请求。结果显示,第二次请求中近98%的输入Token成功命中缓存。这意味着,在典型的Agent工作流中,从第二轮对话开始,绝大部分输入成本可以被节省下来。
假设一个任务包含20轮交互,每轮重发6000 Token的上下文。在不支持缓存的情况下,总输入成本约为0.24元;而在支持高命中率缓存的情况下,成本可降至0.05元左右。两者相差近五倍。这就是为什么有些开发者更换了单价更低的API,最终账单却暴涨的原因——他们丢失了缓存这个最大的成本杠杆。因此,在选型时,必须明确询问平台是否支持缓存,以及缓存命中的具体计价规则,而不能仅看标称的每百万Token单价。
协议兼容性与工具调用的保真度
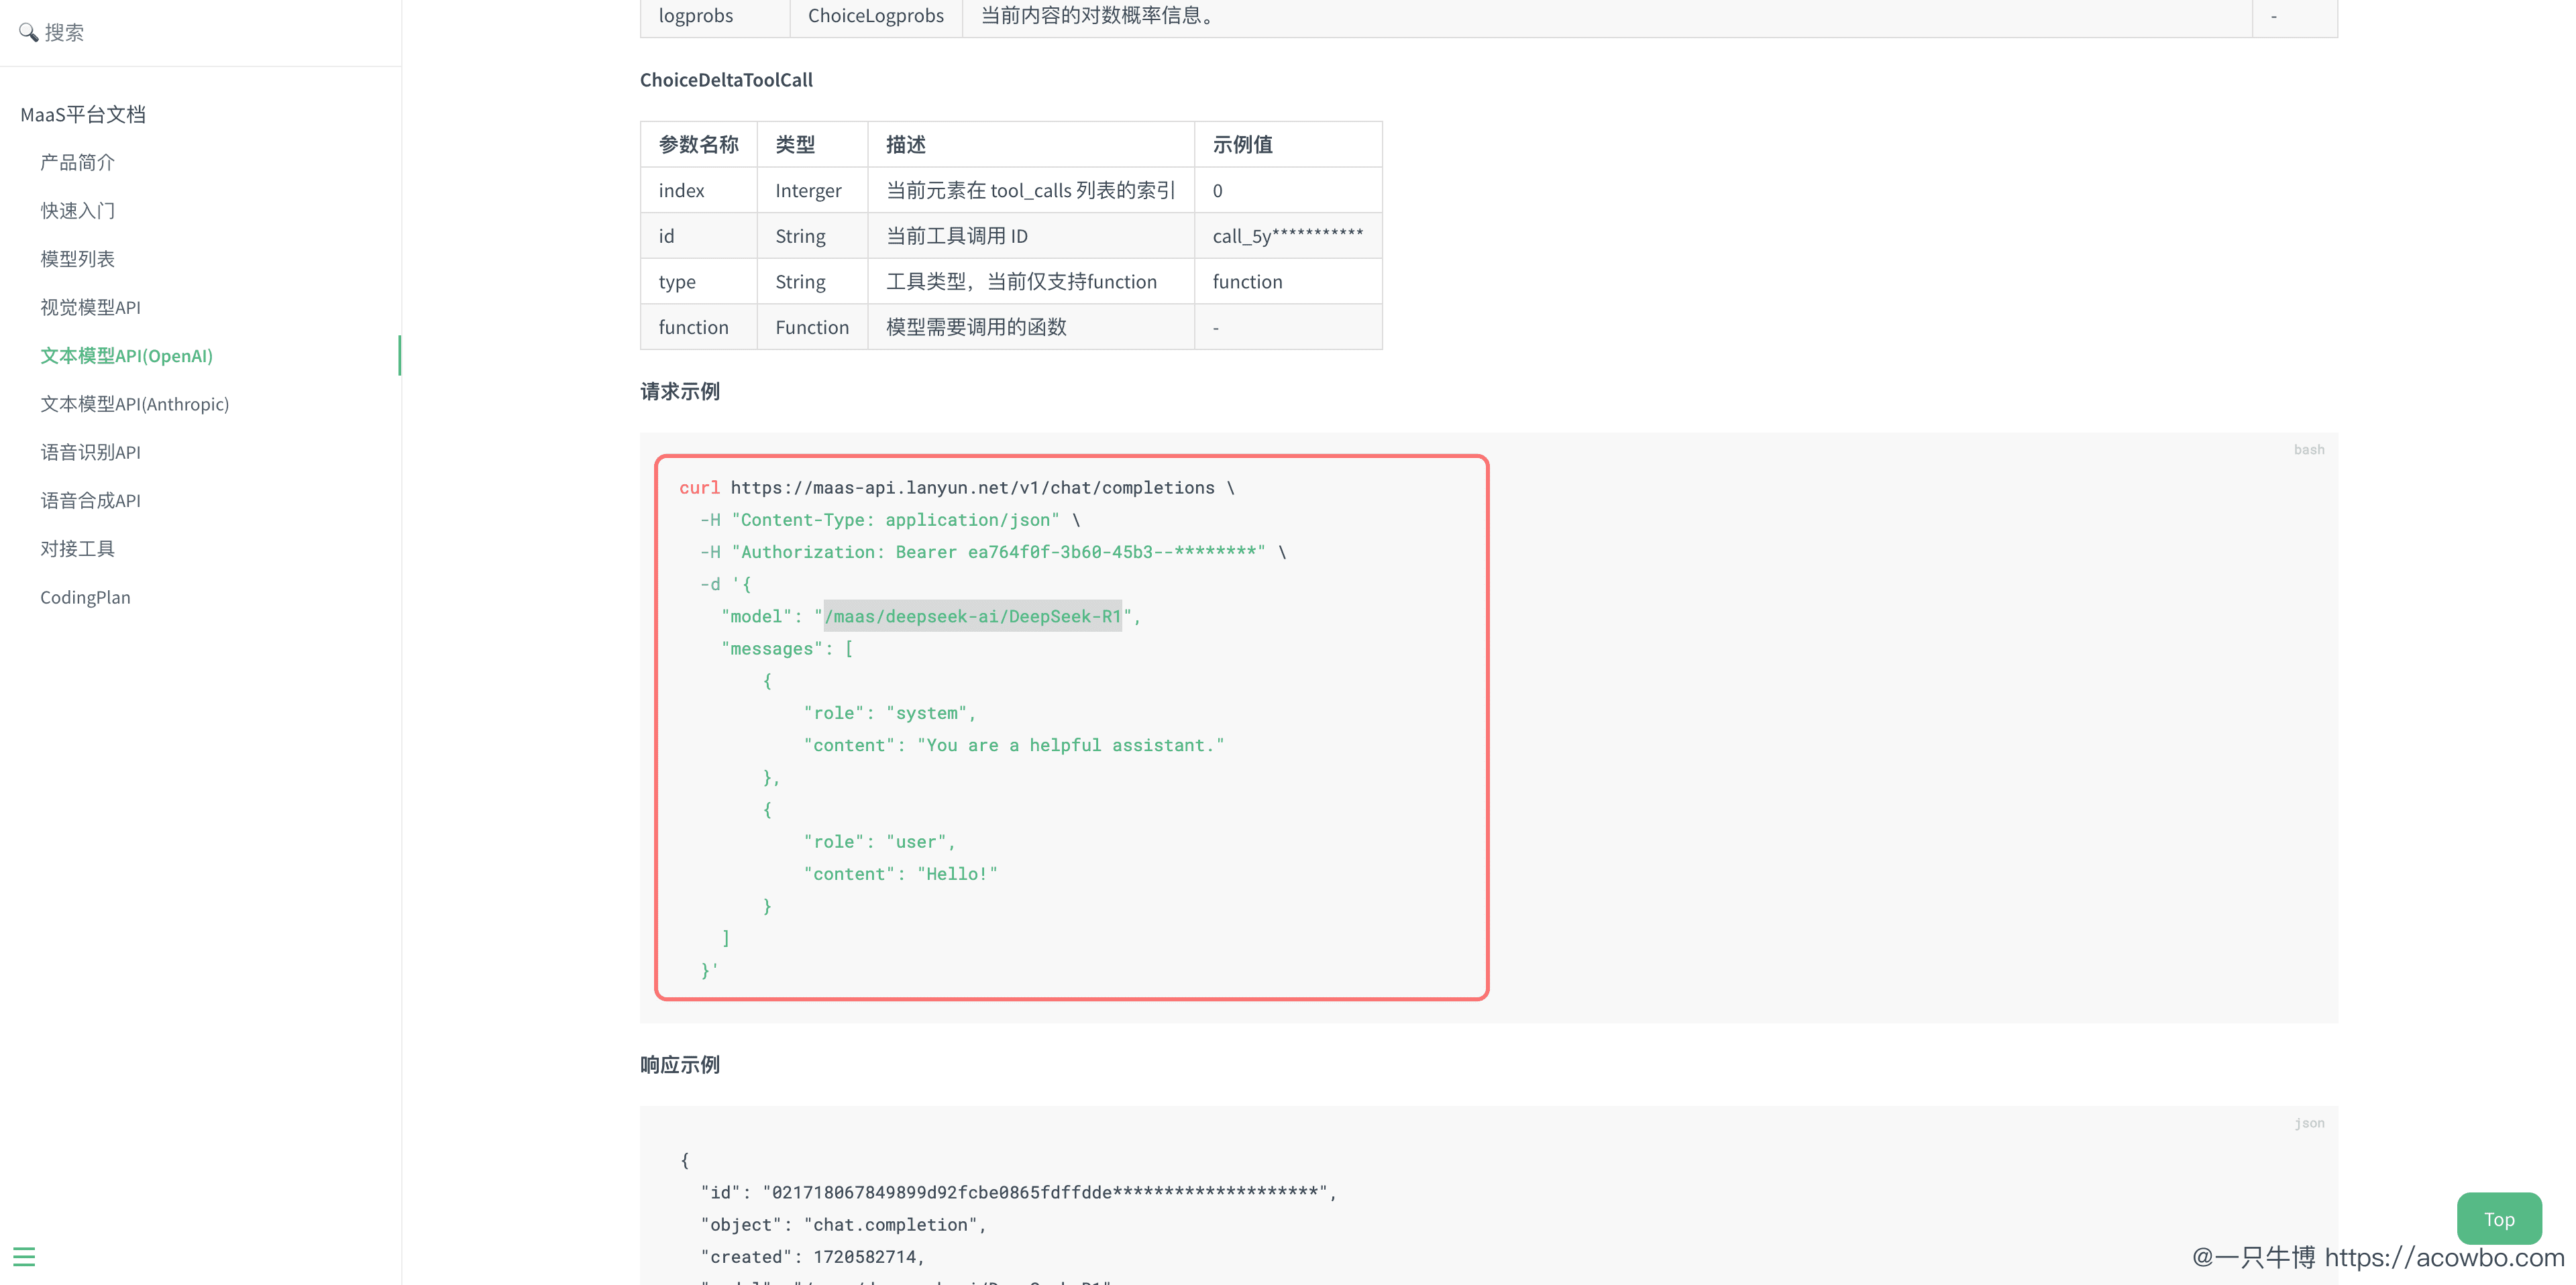
接入第三方API不仅仅是替换一个URL,更涉及协议层面的兼容性。Claude Code原生遵循Anthropic的API协议,使用/v1/messages端点和特定的认证头。而大多数开源模型(如DeepSeek、Qwen)原生提供的是OpenAI兼容接口。这就产生了两种接入路径:一是通过中间件进行协议转换,二是直接使用提供Anthropic兼容端点的平台。
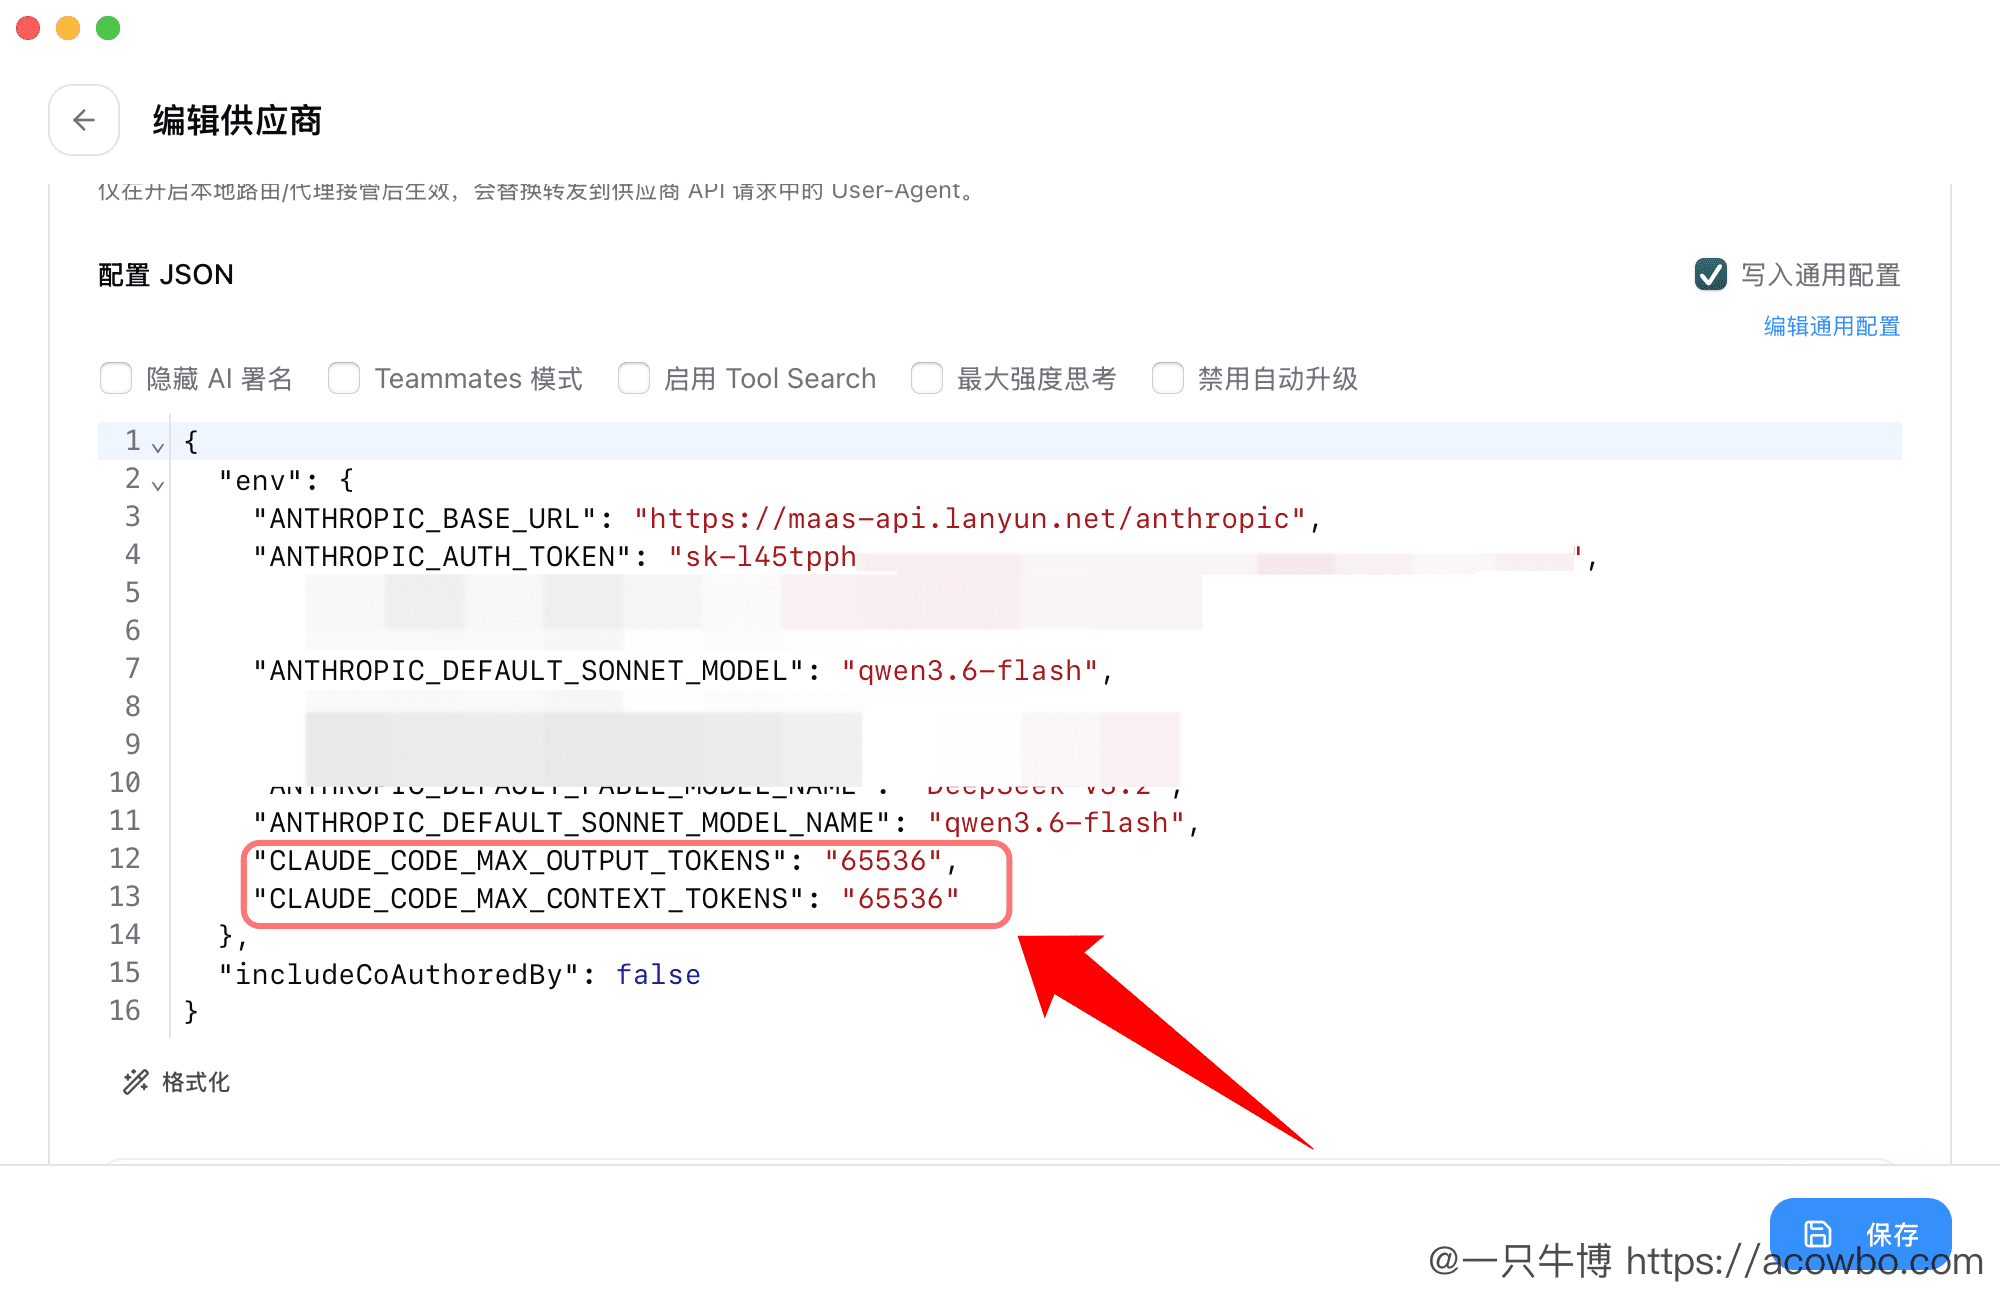
引入中间件虽然可行,但增加了系统的复杂性、故障点和额外延迟。蓝耘等平台直接提供了Anthropic兼容端点,使得开发者可以通过修改环境变量实现无缝直连,无需部署额外的翻译层。这种“原生级”的支持不仅简化了配置,还提升了系统的整体稳定性。
然而,能够成功建立连接并返回文本,并不代表API真正适用于Agent场景。Agent的核心能力在于工具调用(Tool Use),即准确地解析并执行读写文件、运行命令等操作。许多所谓的“兼容”平台在处理复杂指令时,会出现工具调用格式错误、参数缺失或静默降级等问题。这会导致Claude Code在执行关键步骤时报错中断。
因此,验证API可用性的黄金标准不是简单的“Hello World”对话,而是执行一个完整的工具链任务。例如,要求AI创建一个Python文件,编写斐波那契数列计算函数,执行该文件,并读取输出结果进行验证。只有当AI能够准确触发Write、Bash、Read等一系列工具调用,并正确解析返回结果时,才能证明该API具备支撑实际开发工作的能力。这种端到端的测试能够有效暴露平台在指令遵循和结构化输出方面的潜在缺陷。
综合选型策略:超越单一维度的考量
基于上述实测与分析,我们在选择第三方API时应建立一套多维度的评估体系。首先,在工程层面,重点关注尾部延迟的稳定性和工具调用的可靠性。一个偶尔卡顿但平均速度快的API,远不如一个始终稳定在中等速度的API适合长时间编码。其次,在成本层面,深入考察缓存机制的有效性。对于高频交互的Agent场景,缓存命中率对总成本的影响远超基础单价。最后,在长期维护层面,考虑平台的透明度和合规性。清晰的用量看板、详细的调用日志以及明确的数据隐私政策,是保障项目长期稳定运行的基石。
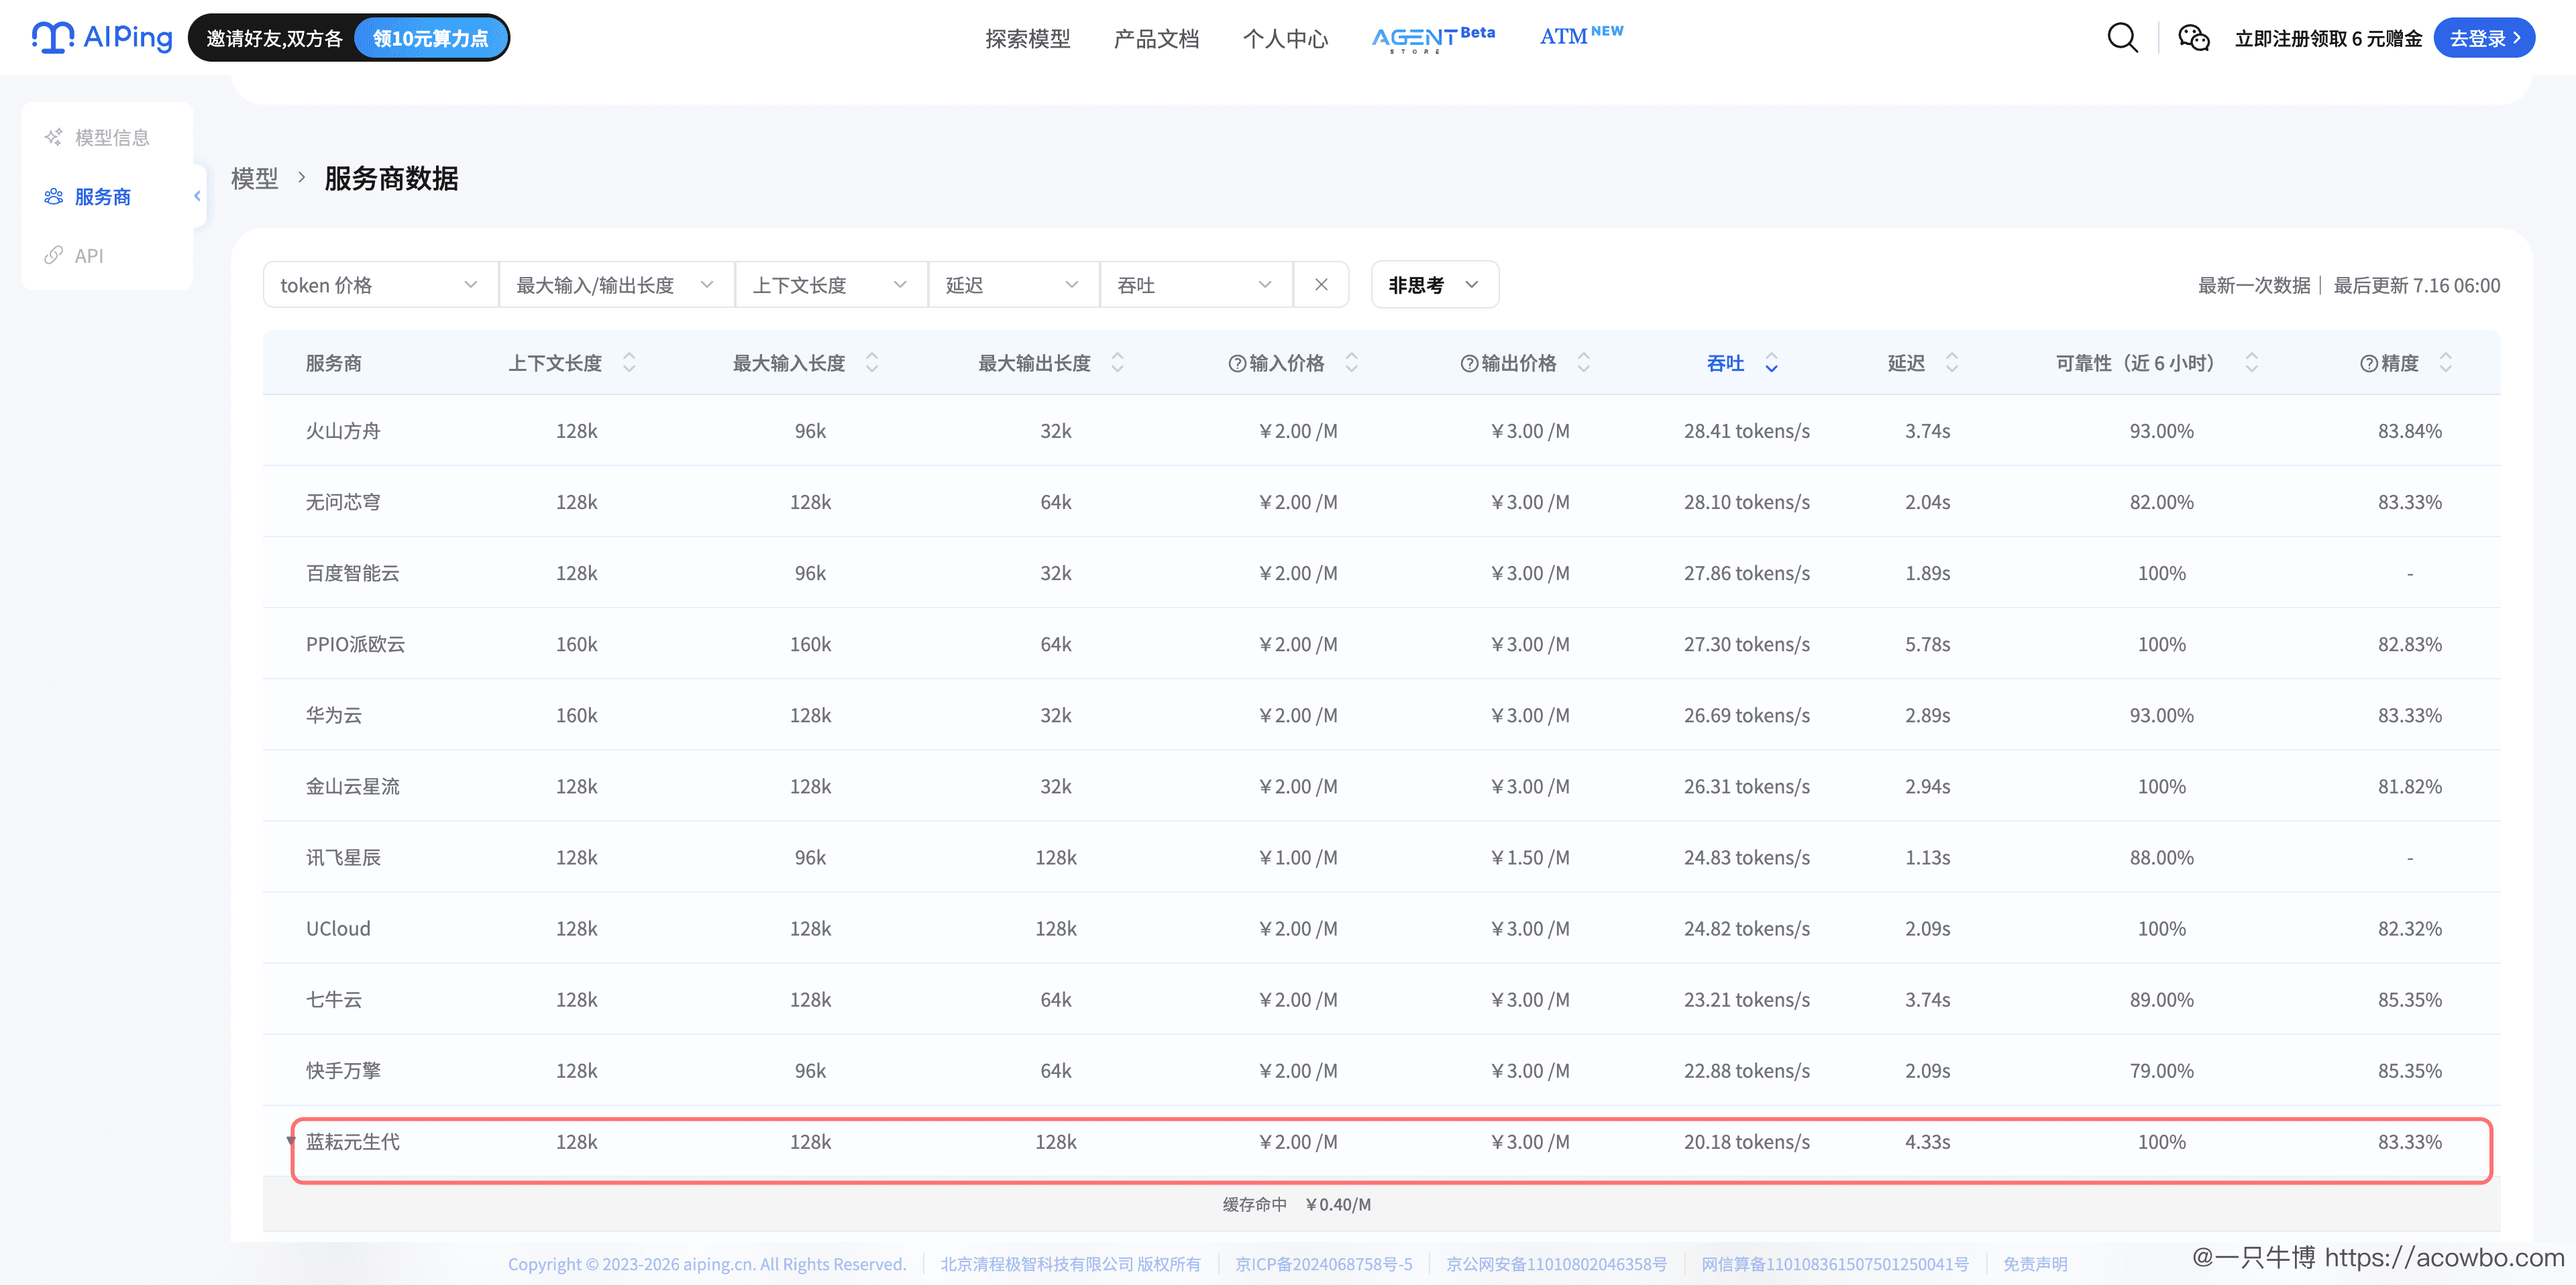
蓝耘元生代MaaS在此次实测中表现出的优势,并非在于某一项指标的绝对领先,而在于其在延迟稳定性、缓存支持和协议兼容性之间的良好平衡。特别是其100%的近期可靠性和对128k长上下文的良好支持,解决了Agent在处理大型项目时的痛点。虽然其在极端高并发下的裸吞吐数据可能不如某些主打性能的厂商,但对于注重交互体验和成本控制的个体开发者及中小团队而言,这种均衡性更具实用价值。
综上所述,接入第三方API绝非简单的配置替换,而是一次需要严谨测试的工程决策。开发者应摒弃对单一指标的盲目崇拜,转而关注那些真正影响开发效率和最终账单的核心要素。通过科学的方法论进行选型,才能在享受AI带来生产力飞跃的同时,有效控制成本,避免陷入“越用越贵、越用越卡”的困境。