二分查找为何总出错?揭秘二段性本质与边界处理的核心逻辑
在计算机科学与算法设计的广阔领域中,二分查找(Binary Search)无疑是最基础却又最易被低估的算法之一。许多初学者往往认为其不过是将数组一分为二的简单操作,但在实际工程应用与高难度算法竞赛中,二分查找的变体及其边界处理往往成为区分初级开发者与资深工程师的分水岭。深入理解二分查找,不仅是为了掌握一种搜索技巧,更是为了培养一种基于“单调性”与“二段性”进行决策的思维方式。
核心哲学:二段性带来的降维打击
二分查找的本质并非仅仅针对有序数组,而是针对具备“二段性”的数据结构。所谓二段性,是指在一个集合中,存在一个分界点,使得该点一侧的元素满足某种性质A,而另一侧的元素满足性质B,且不存在同时满足A和B的元素。
以升序整数数组为例,假设我们要查找目标值target。若我们将数组中的元素与target进行比较,可以发现:小于target的元素位于左侧(性质A),大于等于target的元素位于右侧(性质B)。这种天然的分割属性,使得我们无需遍历整个数组,而是可以通过比较中间元素,判断目标值位于哪一半区间,从而将搜索范围缩小至原来的一半。
这种策略带来的最显著优势在于时间复杂度的量级跃迁。对于包含n个元素的数组,线性查找需要O(n)的时间,而二分查找通过每次排除一半的可能性,仅需O(log n)的时间即可完成搜索。当数据规模达到百万级甚至亿级时,log n与n之间的差距将是数量级的差异,这体现了算法优化在大数据时代的核心价值。
从朴素二分到精准定位:模板的演进
经典的朴素二分查找通常用于判断目标值是否存在,其代码结构相对固定:设定左右指针,计算中点,根据中点值与目标值的大小关系调整指针区间。然而,在实际业务场景中,我们往往需要寻找更精确的信息,例如第一个等于目标值的位置、最后一个等于目标值的位置,或是满足特定条件的极值点。此时,朴素二分便显得力不从心,需要引入更精细的区间查找模板。
左边界查找:锁定首个符合条件的元素
当我们需要查找目标值在排序数组中出现的第一个位置时,关键在于如何处理相等元素以及区间的收缩方式。
在这一场景下,二段性表现为:左侧区间内的所有元素均小于目标值(性质A),而右侧区间(包含目标值首次出现的位置及之后)的所有元素均大于或等于目标值(性质B)。我们的目标是找到性质B的第一个元素。
算法实现的核心在于维护left < right的循环条件,并采用向下取整的方式计算中点:mid = left + (right - left) / 2。当nums[mid] < target时,说明中点及其左侧都不可能是左边界,因此左指针右移至mid + 1。当nums[mid] >= target时,说明中点可能是左边界,或者左边界在中点左侧,因此右指针左移至mid,保留中点作为候选。
这种设计的精妙之处在于避免了死循环。如果采用向上取整且右移逻辑不当,当区间仅剩两个元素[a, b]且a为目标值、b大于目标值时,mid取a,若执行right = mid,区间变为[a, a],循环正确结束;但若逻辑稍有偏差,极易陷入无限循环。
右边界查找:锁定末个符合条件的元素
同理,寻找目标值最后一次出现的位置时,二段性调整为:左侧区间(包含目标值末次出现的位置及之前)的元素均小于或等于目标值(性质A),右侧区间的元素均大于目标值(性质B)。目标是找到性质A的最后一个元素。
此时,中点计算必须采用向上取整:mid = left + (right - left + 1) / 2。当nums[mid] <= target时,说明中点可能是右边界,或者右边界在中点右侧,因此左指针右移至mid。当nums[mid] > target时,说明中点及其右侧都不可能是右边界,因此右指针左移至mid - 1。
向上取整的使用是为了防止在区间仅剩两个元素时,mid始终指向左侧元素,导致left无法移动而引发死循环。例如区间[a, b],若mid取a,执行left = mid,则left不变,循环停滞;若mid取b,执行left = mid,则left右移,循环向前推进。
避坑指南:细节决定成败
在实际编码中,二分查找的错误往往源于对边界条件和区间开闭的混淆。以下是几个至关重要的技术细节:
循环终止条件:大多数边界查找模板推荐使用
left < right。这是因为当left == right时,区间缩小至单个元素,该元素即为我们要找的边界点,无需再进行判断。若使用left <= right,在边界查找中容易多进行无意义的判断或导致索引越界。防止整数溢出:计算中点时,直接使用
(left + right) / 2在某些语言或极端情况下可能导致整数溢出。推荐使用left + (right - left) / 2,这在逻辑上等价,但能有效避免加法溢出问题。更新区间的逻辑:
left = mid + 1与right = mid(或反之)的组合必须严格对应中点的取舍逻辑。一旦确定中点不是解,必须将其排除;若中点可能是解,则必须将其保留在新区间内。这一逻辑的连贯性是防止死循环的关键。
实战演练:从理论到实践的跨越
理解模板只是第一步,灵活运用才是关键。以下通过几个经典案例展示二分思想的迁移能力。
案例一:x的平方根
题目要求计算非负整数x的平方根,结果取整。这可以转化为寻找最大的整数y,使得y * y <= x。这符合右边界查找的特征:左侧区间(y*y <= x)满足性质A,右侧区间(y*y > x)满足性质B。
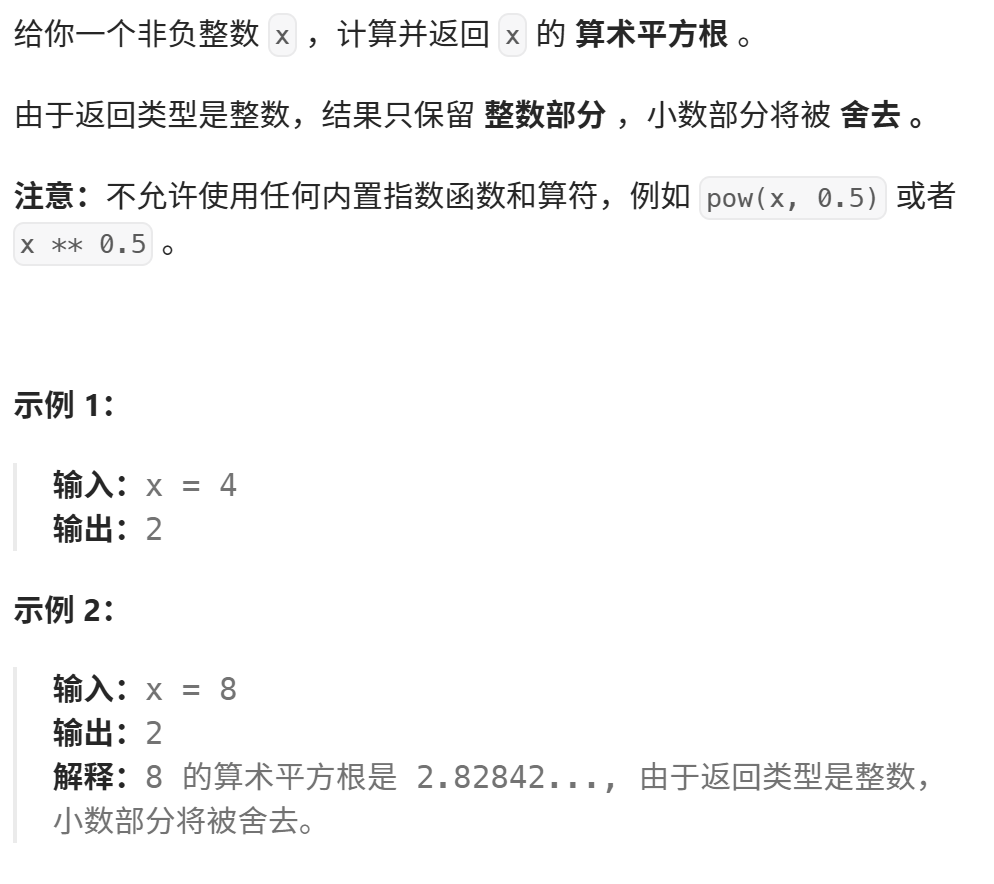
由于结果取整,我们需要找到满足mid * mid <= x的最大mid。因此,采用右边界查找模板,中点向上取整。当mid * mid <= x时,left = mid;否则right = mid - 1。最终left即为所求。
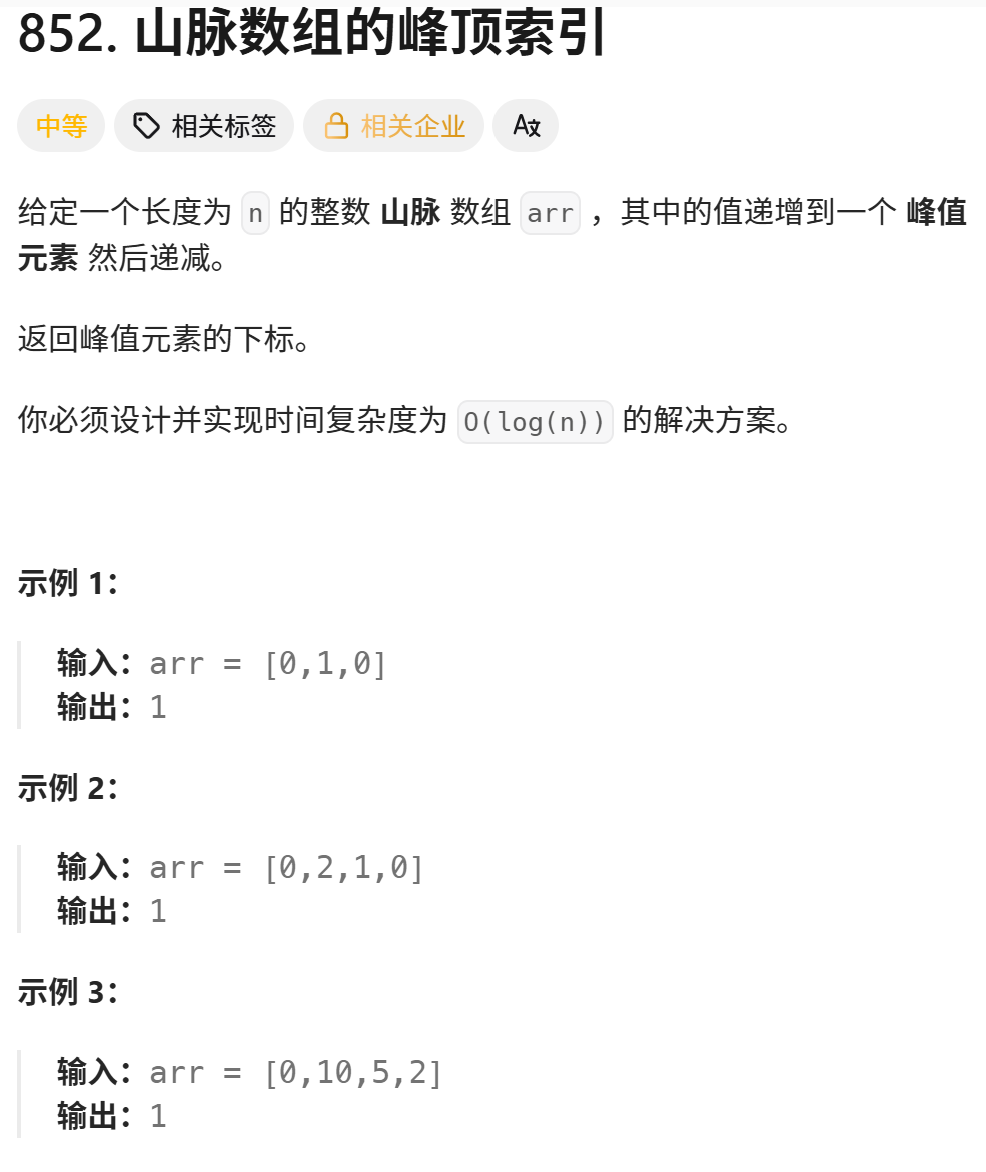
案例二:山脉数组的峰顶索引
给定一个先递增后递减的数组,寻找峰值元素的索引。虽然数组整体无序,但在任意一点,若arr[i] < arr[i+1],则峰值一定在右侧;若arr[i] > arr[i+1],则峰值一定在左侧(包括i)。这构成了二段性:左侧区间满足arr[i] < arr[i+1](性质A),右侧区间满足arr[i] > arr[i+1](性质B)。
我们可以利用左边界查找的思想,寻找第一个满足arr[i] > arr[i+1]的位置,或者寻找最后一个满足arr[i] < arr[i+1]的位置。代码中,若arr[mid] < arr[mid+1],说明处于上升阶段,峰值在右侧,left = mid + 1;否则,峰值在左侧或即为mid,right = mid。
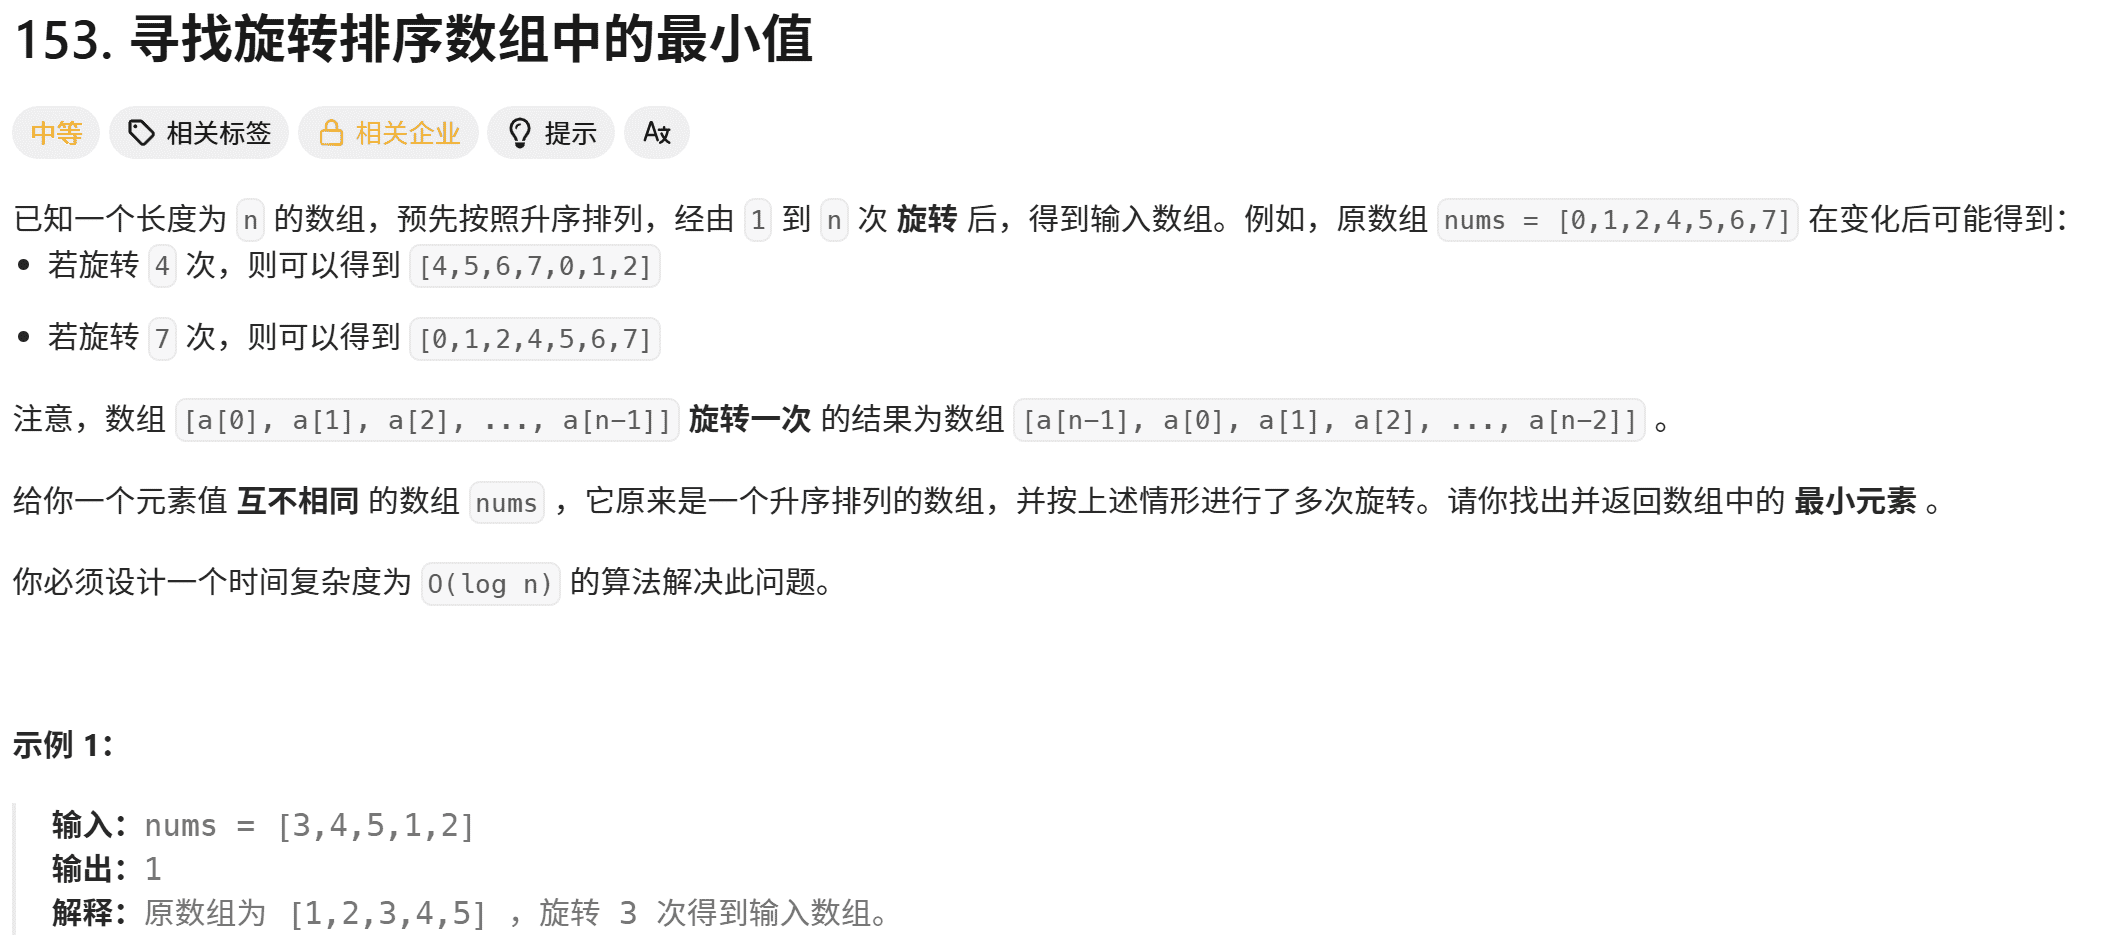
案例三:旋转排序数组的最小值
一个原本有序的数组经过旋转,如[4, 5, 6, 7, 0, 1, 2]。虽然整体无序,但相对于最后一个元素,数组呈现出二段性:左侧区间元素大于等于最后一个元素,右侧区间元素小于最后一个元素。最小值即为右侧区间的第一个元素。
利用左边界查找模板,以最后一个元素为基准。若nums[mid] <= target,说明mid在右侧区间或即为最小值,right = mid;若nums[mid] > target,说明mid在左侧区间,left = mid + 1。最终left指向最小值。
深度思考:二分思想的泛化
二分查找的魅力不仅在于其效率,更在于其体现的“分治”与“排除”思想。只要一个问题可以被划分为两个互斥的子问题,且满足单调性或二段性,二分思想便大有所为。
在算法设计中,我们不应机械地记忆模板,而应着重分析问题的二段性特征。明确“哪一边满足性质A,哪一边满足性质B”,然后根据边界定义选择对应的模板(左边界找性质B的第一个,右边界找性质A的最后一个)。这种基于逻辑推理而非死记硬背的学习方式,才能让人在面对复杂多变的算法问题时游刃有余。
此外,二分查找的应用场景正在不断扩展。除了传统的数值搜索,它在答案具有单调性的优化问题中也大放异彩。例如,在“最小化最大值”或“最大化最小值”的问题中,我们往往可以对答案进行二分查找,通过判定函数(Check Function)来验证某个答案是否可行,从而将优化问题转化为判定问题。这种思路极大地拓宽了解题的视野。
综上所述,二分查找不仅仅是一个算法模板,更是一种高效处理有序数据和单调性问题的方法论。掌握其原理,洞察其细节,方能在算法的海洋中乘风破浪,构建出既高效又稳健的程序逻辑。对于每一位追求卓越的开发者而言,深入钻研二分查找,无疑是提升算法素养不可或缺的一课。