YARN资源调度底层逻辑:Default与Dominant计算器的核心差异解析
资源调度器的核心痛点
在Hadoop YARN的架构设计中,资源管理器(ResourceManager)扮演着集群心脏的角色,而位于其核心的资源调度器(Scheduler)则是决定资源流向的关键中枢。随着企业级大数据应用从单纯的离线批处理向交互式查询、实时流处理以及深度学习训练等多模态负载演进,集群资源的异构性日益显著。传统的资源分配策略往往难以在CPU密集型与内存密集型任务之间找到平衡点,导致集群出现“木桶效应”:尽管内存尚有剩余,但CPU资源已耗尽,反之亦然。
这种资源利用率的低下,本质上源于资源计算器(ResourceCalculator)对“可用资源”定义的局限性。YARN提供了多种资源计算器实现,其中最为常见且极具对比研究价值的两个类是DefaultResourceCalculator和DominantResourceCalculator。前者是Hadoop早期的默认实现,逻辑简单直接;后者则是为了应对多资源类型并发竞争而引入的高级策略。深入理解两者的底层逻辑差异,不仅有助于优化现有集群性能,更是构建高效、稳定大数据平台的基础前提。
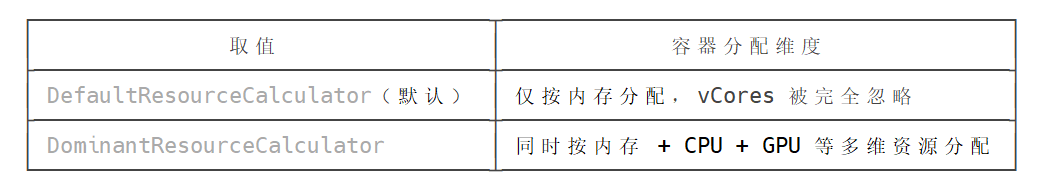
DefaultResourceCalculator:单一维度的简朴哲学
DefaultResourceCalculator是YARN中最基础的资源计算实现类。从其名称即可窥见其设计哲学:简单、直接、聚焦于单一核心指标。在代码实现层面,该类主要关注内存(Memory)资源。当调度器评估一个节点是否足以容纳某个应用请求时,DefaultResourceCalculator仅比较申请的内存量与节点剩余的可用内存量。
这种设计在早期Hadoop版本中占据统治地位,主要基于当时的历史背景。在Hadoop 1.x及Hadoop 2.x早期阶段,MapReduce任务绝大多数是内存密集型或IO密集型应用,CPU资源通常不是瓶颈,且当时节点硬件配置相对同质化,内存成为衡量资源稀缺性的首要标准。因此,DefaultResourceCalculator的算法逻辑几乎不包含对CPU、磁盘IO等其他维度的复杂计算,其核心方法isSufficient仅仅执行内存数值的比较。
然而,这种单一维度的视角在现代计算环境中逐渐显露出局限性。当一个任务请求10GB内存和4核CPU,而节点剩余20GB内存但仅剩2核CPU时,DefaultResourceCalculator会判定资源充足并尝试分配。这将导致任务实际运行因CPU饥饿而严重降级,甚至触发OOM或超时异常,而调度器却认为资源“充足”。这种认知偏差导致了资源分配的假象,使得集群整体吞吐量受损。
此外,DefaultResourceCalculator在多租户场景下极易引发资源倾斜。如果集群中混合运行着内存友好的小任务和CPU密集的大任务,基于内存的简单计算无法有效隔离不同工作负载的资源竞争,容易导致“嘈杂邻居”问题,即某一类任务独占某种稀缺资源,而阻塞其他关键业务。
DominantResourceCalculator:多维平衡的艺术
为了解决单一资源维度的缺陷,Apache社区引入了DominantResourceCalculator(主导资源计算器)。与DefaultResourceCalculator不同,该类引入了“主导资源”的概念,旨在通过多维度的比例计算,实现更公平、更高效的资源分配。
DominantResourceCalculator的核心逻辑基于“最大最小公平性”(Max-Min Fairness)理论的延伸。在每次资源分配决策中,它不仅检查资源的绝对剩余量,更计算每种资源类型的使用比例。所谓“主导资源”,是指在当前节点资源状态下,剩余比例最小(即最稀缺)的资源类型。调度器会优先保障主导资源的公平分配,从而避免其他非主导资源被过度分配而闲置。
具体而言,DominantResourceCalculator会同时监控内存、CPU以及可能扩展的其他资源维度(如磁盘IO等,取决于具体配置)。当计算分配优先级时,它会将申请的CPU和内存分别归一化,找出使得某种资源占比最高的维度作为主导维度。例如,若节点剩余10%的内存和20%的CPU,则内存为主导资源。此时,调度器会优先确保内存的公平性,防止内存密集型任务挤占所有资源而导致CPU利用率低下。
这种机制在多资源类型的异构集群中表现尤为出色。通过平衡不同资源类型的分配比例,DominantResourceCalculator显著提高了集群的整体利用率。它不再让CPU或内存出现明显的“短板”,而是通过动态调整,使得各类资源尽可能同步被消耗。这对于运行混合负载(如既有Spark SQL这种内存计算重的任务,又有Kafka这种CPU网络重的服务)的大数据平台而言,是提升稳定性的关键配置。
深度对比:算法差异与适用场景
要准确选择资源计算器,必须深入剖析两者在算法逻辑、资源利用率以及适用场景上的本质差异。
从算法复杂度来看,DefaultResourceCalculator属于O(1)复杂度的简单比较操作,计算开销几乎可以忽略不计。而DominantResourceCalculator需要进行多维度的归一化计算和比例比较,虽然其计算量依然极小,但在大规模并发调度场景下,理论上会引入微小的额外CPU开销。不过,在现代多核CPU背景下,这一开销通常不足以成为性能瓶颈。
在资源利用率方面,两者差距显著。DefaultResourceCalculator容易导致资源碎片化。例如,当集群中大量任务申请高内存低CPU配置时,内存资源会被快速耗尽,而CPU资源大量闲置,形成典型的资源浪费。DominantResourceCalculator通过主导资源机制,能够识别并抑制这种不平衡,促使调度器在分配时考虑资源的互补性,从而显著提升集群的整体资源吞吐率。
在适用场景的选择上,DefaultResourceCalculator更适合资源类型单一、任务特征高度一致的集群。例如,仅运行Hive离线批处理任务,且任务对内存需求远大于CPU,或者集群硬件配置极其老旧且同质化严重的场景。此外,对于需要极致简化配置、对调度器逻辑不熟悉的新手环境,DefaultResourceCalculator是一个安全的默认选项。
相反,DominantResourceCalculator是现代化、多元化大数据集群的首选。特别是在以下场景中表现优异:一是异构硬件集群,不同节点配置差异较大;二是多租户共享集群,不同业务线对CPU和内存的需求比例各异;三是运行Spark、Flink等内存计算框架,这些框架对资源敏感度高,且任务生命周期短、并发度高,需要精细的资源调控。
生产环境的配置策略与优化建议
在实际的生产环境部署中,资源计算器的选择并非一成不变,而是需要根据集群的演进阶段和业务特征进行动态调整。许多大型互联网公司在集群升级过程中,会从Default逐步迁移至DominantResourceCalculator,以换取更高的资源ROI(投资回报率)。
首先,配置切换需结合调度器类型。无论是Capacity Scheduler还是Fair Scheduler,YARN都支持通过配置文件yarn.scheduler.capacity.resource-calculator或yarn.scheduler.fair.resource-calculator来指定计算器实现。将值设置为org.apache.hadoop.yarn.server.resourcemanager.scheduler.capacity.DominantResourceCalculator即可启用主导资源计算。需要注意的是,切换配置通常需要重启NodeManager或ResourceManager,因此在变更窗口期需谨慎操作。
其次,需关注标签化资源的扩展性。随着YARN版本迭代,除了内存和CPU,磁盘IO、GPU等异构资源也逐渐被支持。DominantResourceCalculator具备良好的扩展性,可以通过实现自定义的ResourceCalculator接口来处理新增的资源类型。对于有特定硬件(如AI训练集群)需求的企业,可以考虑基于Dominant逻辑开发自定义计算器,以适配GPU显存等非标准资源。
此外,监控与调优是不可或缺的环节。启用DominantResourceCalculator后,应密切监控集群的“资源倾斜度”指标。通过YARN UI或Prometheus监控节点级的CPU和内存使用率曲线,观察两者是否趋于平滑。如果发现某些节点依然频繁出现CPU满载而内存闲置的情况,可能需要进一步调整权重参数或检查应用的任务提交策略。
最后,避免盲目跟风。虽然DominantResourceCalculator在大多数场景下更优,但其复杂的计算逻辑可能会在某些极端高并发、低延迟要求的场景中引入调度抖动。因此,在切换前务必进行充分的压测和模拟,评估其对调度延迟的影响,确保业务稳定性不受负面影响。
未来展望:动态资源计算的演进
随着云原生技术与大数据平台的深度融合,YARN资源调度正面临新的变革。Kubernetes的兴起迫使Hadoop生态重新思考资源管理的边界,而YARN自身也在向更细粒度、更动态的资源分配方向演进。
未来的资源计算器可能会引入机器学习算法,通过历史数据分析预测任务资源需求,实现动态权重调整。例如,系统可以学习特定业务线在高峰期的资源消耗模式,自动调整DominantResourceCalculator中的优先级权重。此外,随着Serverless架构在大数据领域的渗透,基于抢占式实例和细粒度切片的资源分配将成为主流,这将要求资源计算器具备更高的灵活性和实时响应能力。
DefaultResourceCalculator作为历史产物,其简洁性值得尊重,但已无法满足现代复杂计算环境的需求。DominantResourceCalculator则代表了资源调度从“粗放式分配”向“精细化平衡”的转型。对于架构师而言,理解这一转变背后的技术逻辑,不仅有助于解决当下的资源痛点,更为应对未来云原生大数据架构的演变奠定了坚实的理论基础。在资源日益昂贵的今天,选择正确的资源计算器,就是选择了更高的集群效能与更低的企业成本。