K3模型48小时引爆全球AI圈,中国开源力量如何重塑算力与商业格局
算力海啸与全球震动:K3发布的48小时
Kimi K3模型的发布,在2026年7月的第一个周末掀起了一场席卷全球人工智能领域的海啸。在短短48小时内,这场技术发布引发的连锁反应远超业界预期,不仅让Kimi的服务器瞬间承压至极限,更在金融市场上引发了剧烈震荡。
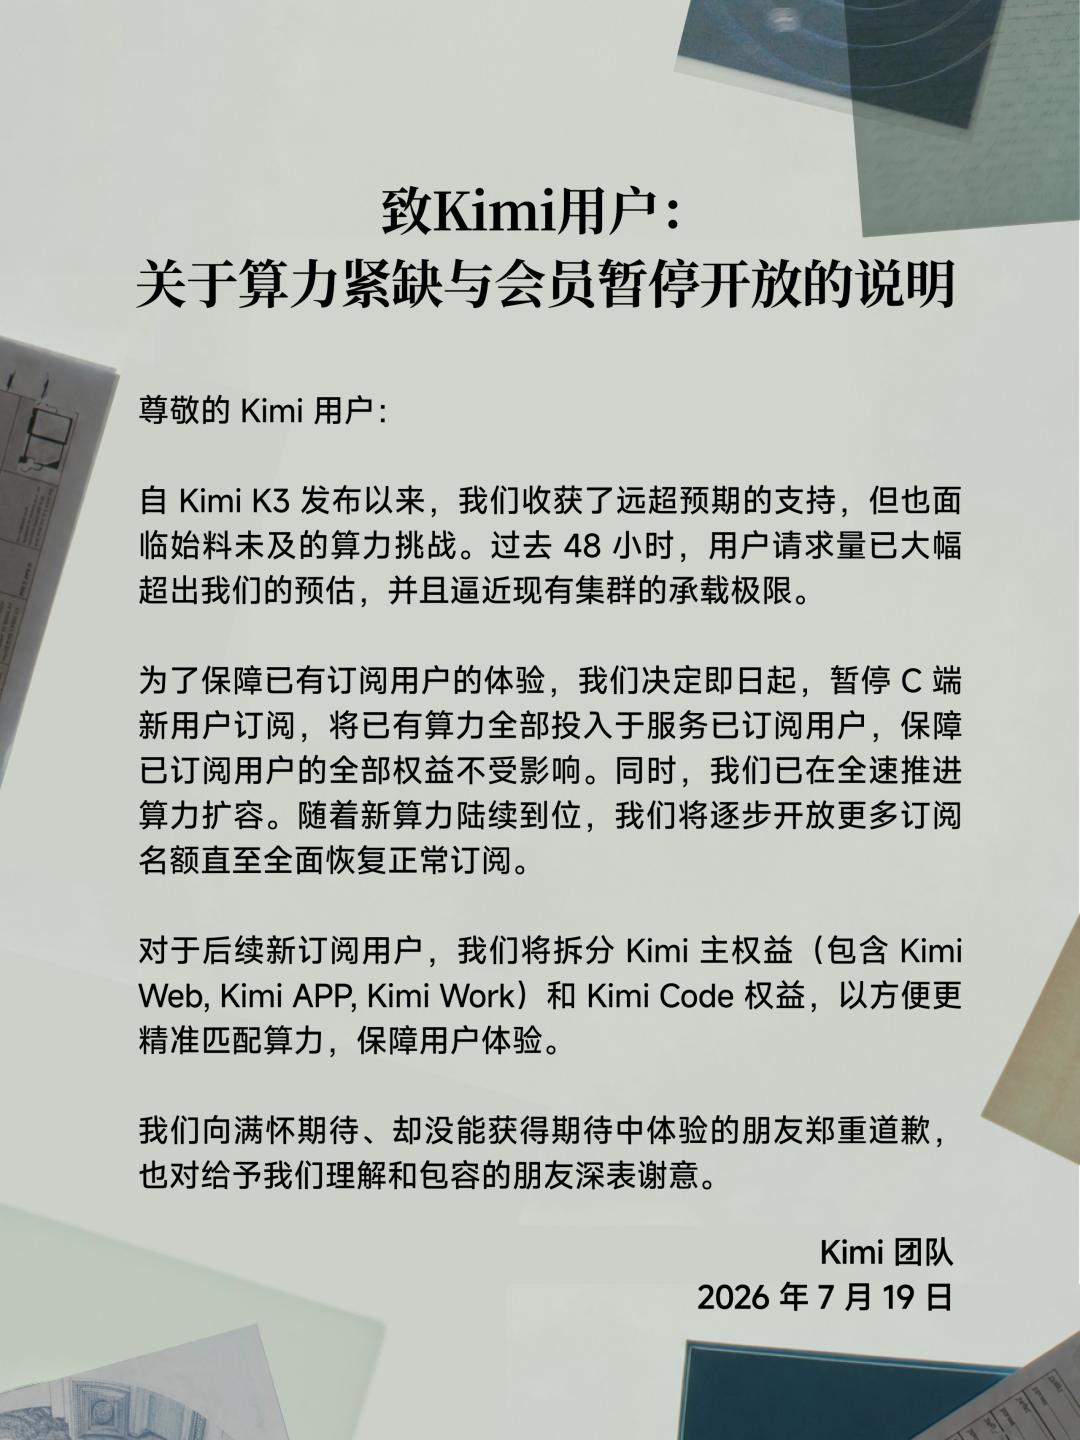
面对激增的用户请求,Kimi官方在深夜不得不发布紧急公告,承认现有算力集群已逼近承载极限。为了保障既有订阅用户的体验,平台果断暂停了C端新用户的会员订阅,并将会员体系重构为主权益与Code权益两部分,以实现对算力的精细化分配。这一举措背后的潜台词清晰而直接:K3的热度超出了所有预估,算力资源已成为稀缺瓶颈。
与此同时,资本市场迅速做出了反应。K3发布的首个交易日,英伟达单日市值蒸发约1111亿美元,这一数字与2025年初DeepSeek发布时的市场反应如出一辙。费城半导体指数当周下跌12.5%,创下15个月以来的最差单周表现。摩根大通策略师在研报中直接将此次事件定义为“DeepSeek 2.0”,认为中国开源模型正在重新定义行业基准。
在技术层面,美国国家前AI事务负责人大卫·塞克斯公开承认,这是中国模型首次在编程赛道取得领先地位,并警告美国若不能调整战略,将在AI竞赛中处于被动。甚至硅谷巨头马斯克也表态,其旗下xAI的最新模型将加速训练以追赶K3。这一系列反应表明,K3不仅仅是一个产品发布,更是全球AI权力格局变化的一个标志性事件。
技术范式转移:从死记硬背到自主进化
要理解K3为何能引发如此巨大的震动,必须回溯其背后的技术基因。K3并非凭空出现,而是两年前杨植麟提出的“强化学习扩展定律”(Reinforcement Learning Scaling, RL Scaling)的大规模落地成果。
传统的语言模型遵循Next-Token Prediction范式,本质上是通过海量数据训练来“记忆”答案。这种模式虽然能提升短期表现,但缺乏真正的推理能力。而RL Scaling的核心逻辑在于让模型像人类学习一样,通过“试错-反馈-修正”的闭环来积累经验。模型不再被动接收答案,而是主动刷题、自我打分、查找错误并迭代优化。这种机制在K0-Math模型中首次得到验证,其数学推理能力甚至超越了当时OpenAI最强的o1模型。
K3将这一逻辑扩展到了全场景的“视觉闭环”(Vision in the Loop)中。这意味着模型在生成代码或内容后,能够像人一样观察结果,发现偏差并自动修正。这种能力在K3的技术Demo中得到了惊人展示:模型从零开始编写了一个基于WebGPU的程序化生成开放世界游戏,甚至独立完成了包含帧级精准节拍同步的视频剪辑任务。
在性能评测方面,K3展现了极高的性价比与强大的基础能力。根据Artificial Analysis的数据,K3在AI智能指数上排名全球第三,仅次于Claude Fable 5和GPT-5.6 Sol。更关键的是,其完成单个任务的成本仅为0.94美元,不到Claude Opus 4.8的一半。这种高性能与低成本的结合,正是其迅速占领市场并引发巨头焦虑的核心原因。
性能边界与工程挑战:差距依然存在
尽管K3在综合指数上表现亮眼,但深入拆解其各项能力指标,仍可发现其与顶尖闭源模型之间存在的实质性差距。在真实代码库长程工程能力基准DeepSWE中,GPT-5.6 Sol以73.0分领先,Fable 5为70.0分,而K3为67.5分。在涉及多步骤、高复杂度的工程任务中,K3的稳定性稍逊一筹。
此外,K3在视觉推理测试Zerobench中得分41.0,落后于Fable 5的46.0分。Fable 5凭借截图重建Web应用源码、从密集科学图表中提取数据的能力,展现了更深的视觉理解力。K3虽然具备视觉闭环能力,但在视觉理解的深度与精度上仍有提升空间。
部署层面的挑战也不容忽视。K3在训练过程中保留了完整的思考历史,这对调用方的Harness架构提出了极高要求。若无法正确传递推理过程,或在多模型混合环境中切换,K3的输出质量将出现显著下降。同时,K3在任务模糊时表现出“过度主动”的倾向,倾向于替用户做决定而非确认意图,这在需要精确执行的工程流程中可能引发连锁错误。
值得注意的是,K3的幻觉率在AA-Omniscience测试中较上一代K2.6有所上升。对于定位为长程编程和知识工作的模型而言,幻觉是致命伤。相比之下,Fable 5凭借宪法式AI(Constitutional AI)架构,在长时间Agent运行中表现出更高的谨慎性与安全性。这些差距表明,K3虽已具备极强的竞争力,但在极端复杂场景下的可靠性仍需打磨。
商业策略重构:订阅制的防御性调整
K3的出现不仅冲击了技术基准,更迫使竞争对手重新评估其商业策略。Anthropic在K3发布后连夜调整了Fable 5的订阅政策,原本计划下架的订阅方案被永久保留,并向不同层级的用户提供了额度补偿。这一举措被视为对K3高性价比优势的直接回应。
Anthropic的防御性调整揭示了开源模型对闭源巨头构成的真正威胁:并非绝对性能的碾压,而是性价比与生态兼容性的挑战。K3以接近顶级模型的性能,提供了更低廉的使用成本,这使得大量企业用户开始重新权衡自研模型与调用第三方API的成本效益。
与此同时,Kimi自身的商业化进程也在加速。外界爆料称,Kimi正寻求在香港上市,估值可能超过300亿美元。其年化经常性收入(ARR)在三个月内从1亿美元飙升至近3亿美元,其中API业务占比已突破70%。收入结构从依赖C端订阅向B端API服务转型,标志着Kimi正从一款C端应用向基础设施级的AI服务平台演进。这种商业模式的转变,使其更能适应企业级市场对稳定性、定制化及成本控制的严苛要求。
创始人逻辑:杨植麟为何选择归国创业
K3的成功背后,是创始人杨植麟独特的职业轨迹与创业哲学。杨植麟在卡内基梅隆大学(CMU)期间师从鲁斯兰·萨拉霍丁诺夫,共同参与了XLNet和Transformer-XL的研究。尽管拥有留在美国顶级大厂工作的机会,杨植麟却坚定地选择回国创业。
这一决策的背后有三层深层逻辑。首先是创业执念。早在博士二年级,杨植麟便开始兼职创业,他认为大厂的科学研究往往受限于组织架构,难以真正推动产品落地。科学家缺乏足够的资源与权力去打破学术与工业界的壁垒,导致技术转化率低下。
其次是对方向把控的追求。杨植麟不仅希望从事基础研究,更渴望打造具有影响力的产品。回国创业为他提供了从底层模型到上层应用的完整掌控权,避免了在大型组织中被边缘化的风险。
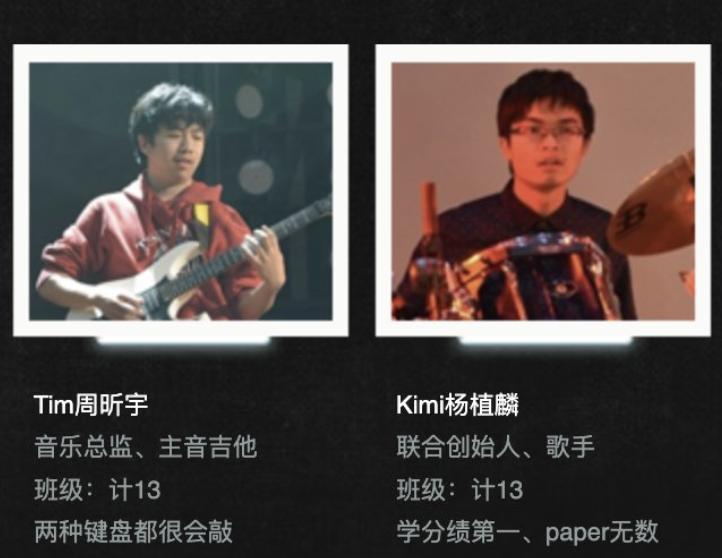
最后,是生态资源的协同效应。杨植麟的联合创始人周昕宇、陈麒聪等核心团队成员,均源自清华KEG实验室或其创业圈子。这种紧密的人才网络与客户资源,使得Kimi在中国市场的启动成本远低于在美国从零组建团队。回国创业不仅是个人选择的体现,更是对中国AI产业生态、数据资源及市场潜力的深刻信任。
未来展望:开源力量重塑全球AI格局
K3的发布标志着全球AI竞争进入了一个新阶段。中国开源模型正在缩小与顶尖闭源模型的技术差距,从过去的6-9个月缩短至2-3个月。加州大学伯克利分校教授伊翁·斯托伊卡指出,这一趋势正在改变全球AI的技术版图。
对于行业而言,K3的成功证明了强化学习扩展机制的可行性,也为后续模型的研发提供了新范式。对于市场竞争者来说,如何在保持高性能的同时控制算力成本、降低幻觉率、优化长程推理能力,将成为未来的核心竞争点。
与此同时,K3引发的市场震荡也提醒我们,AI技术的进步不仅是算法的胜利,更是算力、数据与商业模式共同作用的结果。随着Kimi推进上市进程,以及更多中国开源模型的涌现,全球AI生态将更加多元化。在这场竞赛中,技术开源与商业闭环的平衡,将成为决定最终胜负的关键变量。