Kimi K3登顶开源榜首:2.8万亿参数模型如何改写AI成本与能力格局?
开源新范式:Kimi K3的技术突破与生态冲击
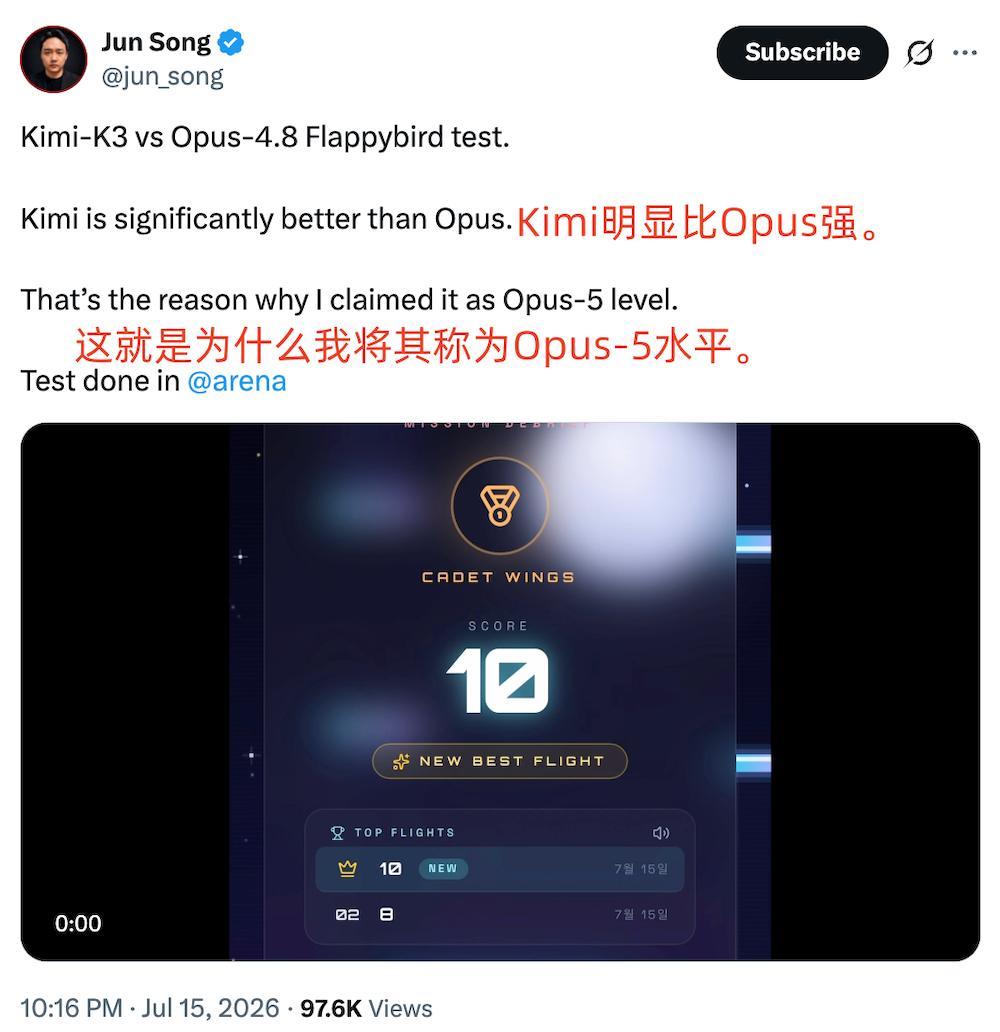
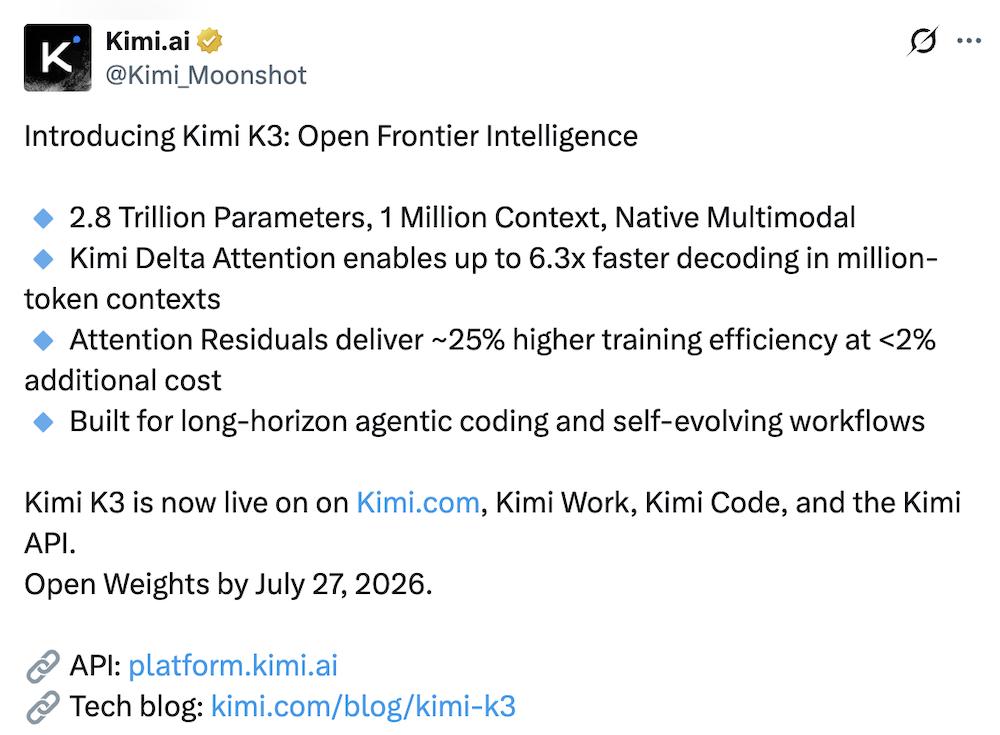
随着Kimi K3的正式发布,全球人工智能大模型领域迎来了一次具有里程碑意义的震荡。作为首个开源的3万亿参数级别模型,Kimi K3不仅以2.8万亿的庞大参数规模打破了开源社区的容量上限,更在多项权威基准测试中实现了对外部闭源顶级模型的超越。这一举措被业界广泛视为“中国的Fable 5时刻”,标志着开源大模型在能力边界与商业化落地之间找到了新的平衡点。
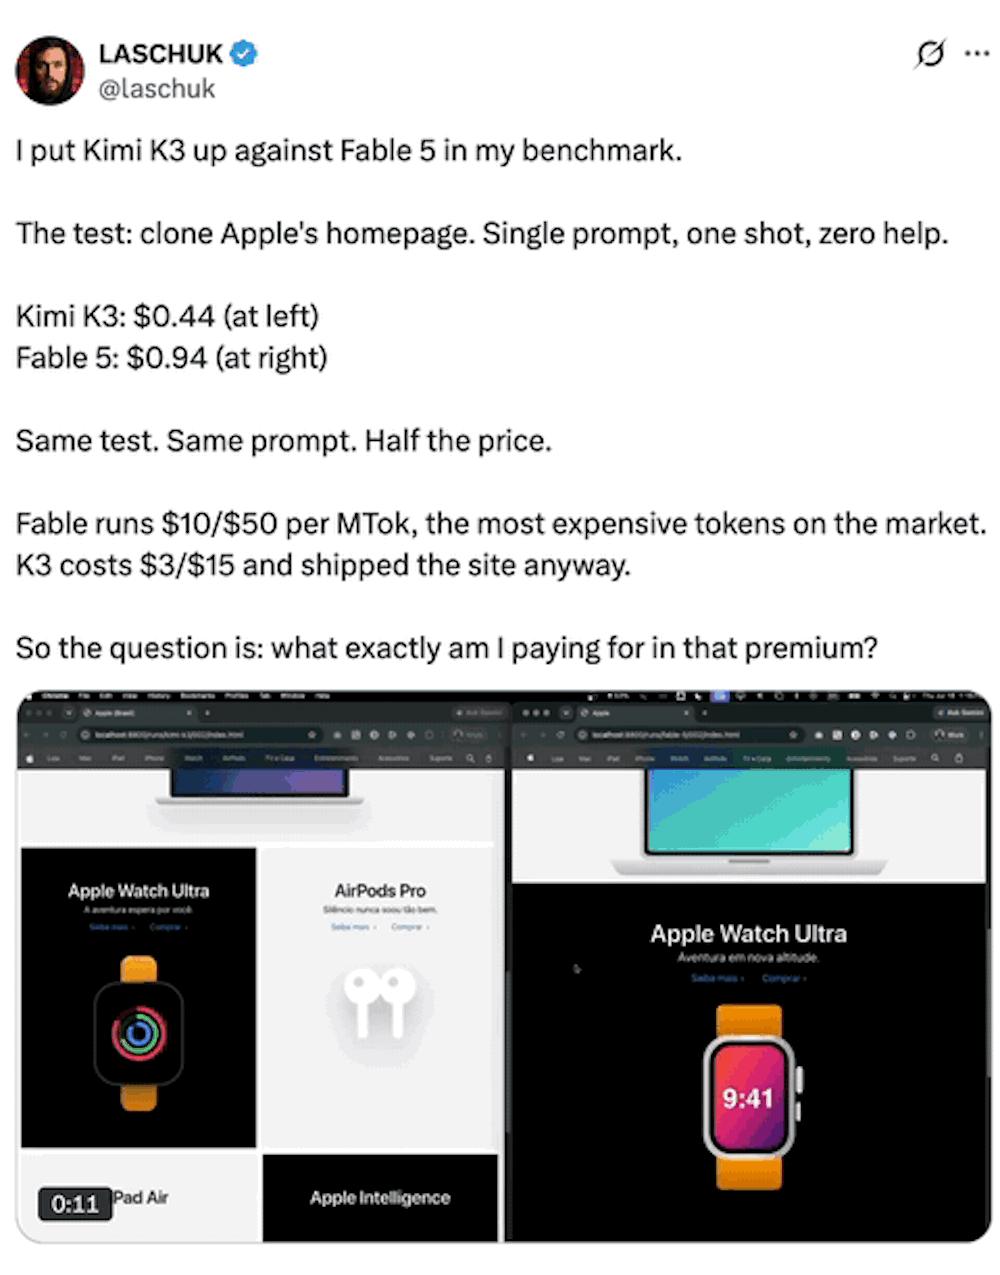
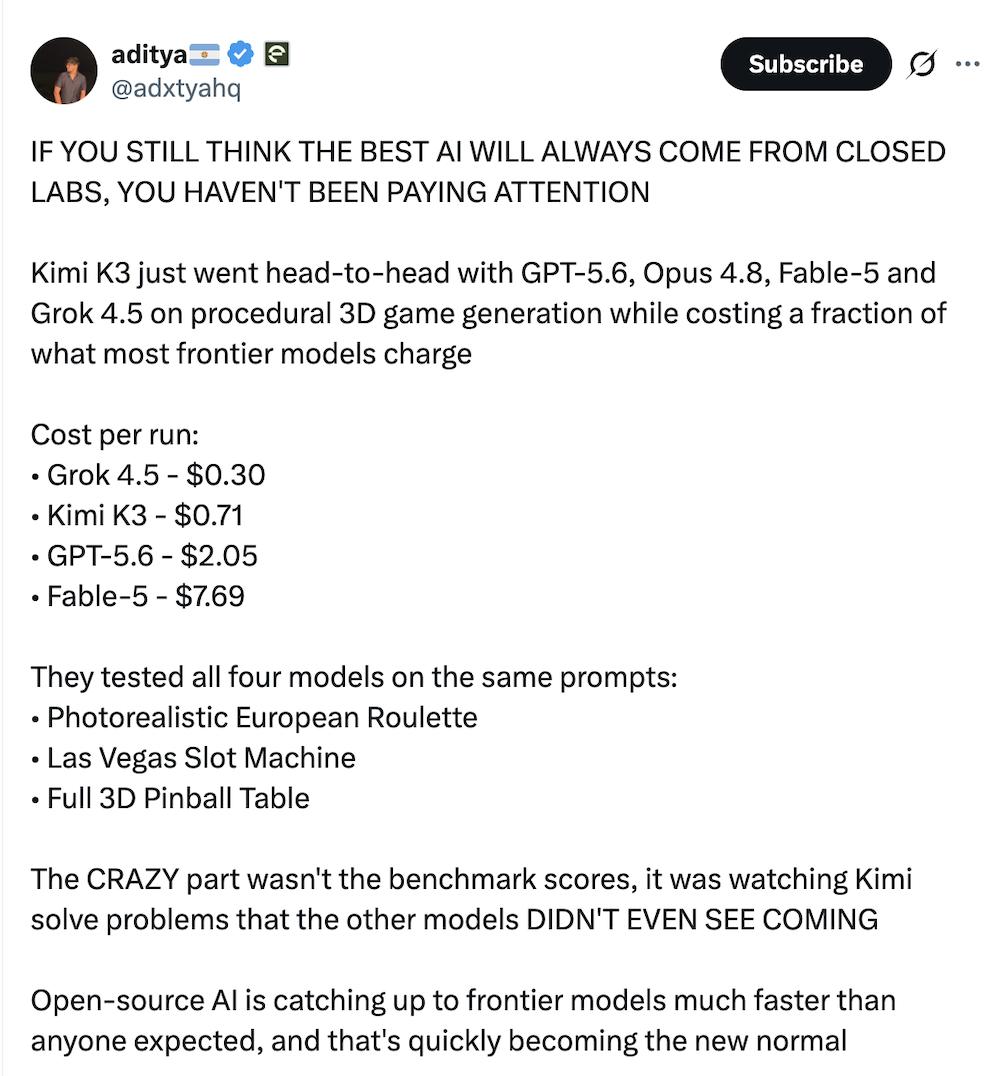
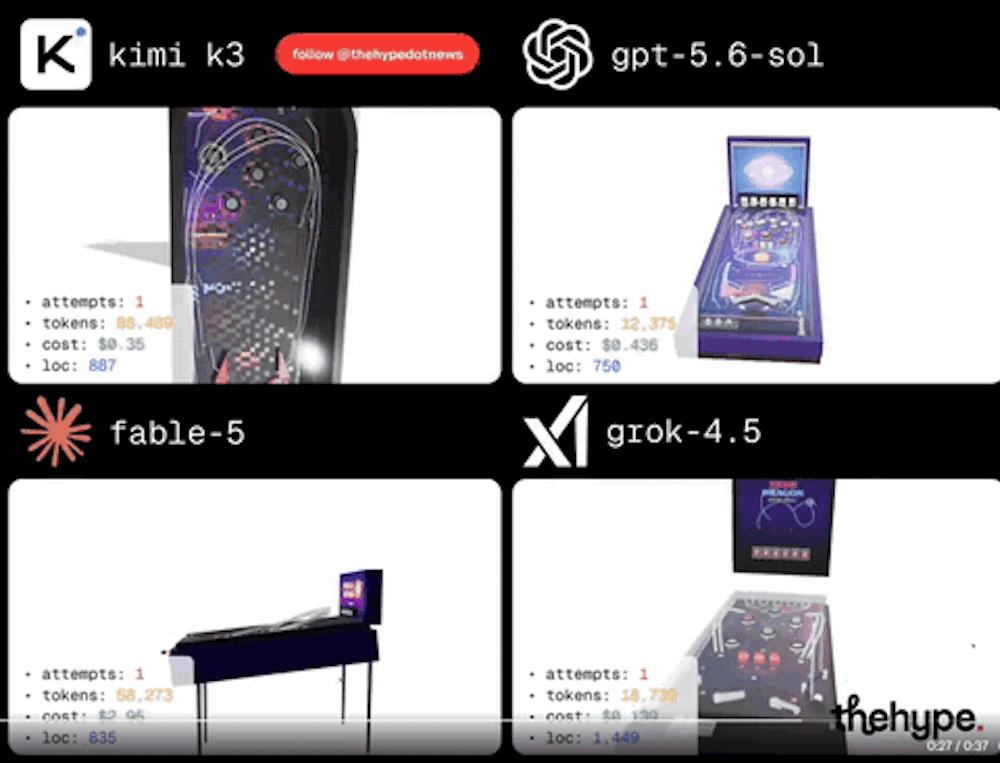
Kimi K3的核心亮点在于其原生支持的100万token上下文窗口以及卓越的多模态理解能力。这种长程记忆与复杂信息处理能力,使得模型能够处理从数十年的行业研究资料到复杂的GPU内核优化代码等高难度任务。更令人瞩目的是,尽管其性能在多个维度上接近甚至超越了Claude Fable 5等闭源巨头,但其API定价策略却保持了极高的性价比,输入价格仅为后者的三分之一左右。这种“高性能、低成本”的组合,正在重塑开发者对大模型基础设施的选择逻辑。
架构创新:解码2.8万亿参数的效率秘密
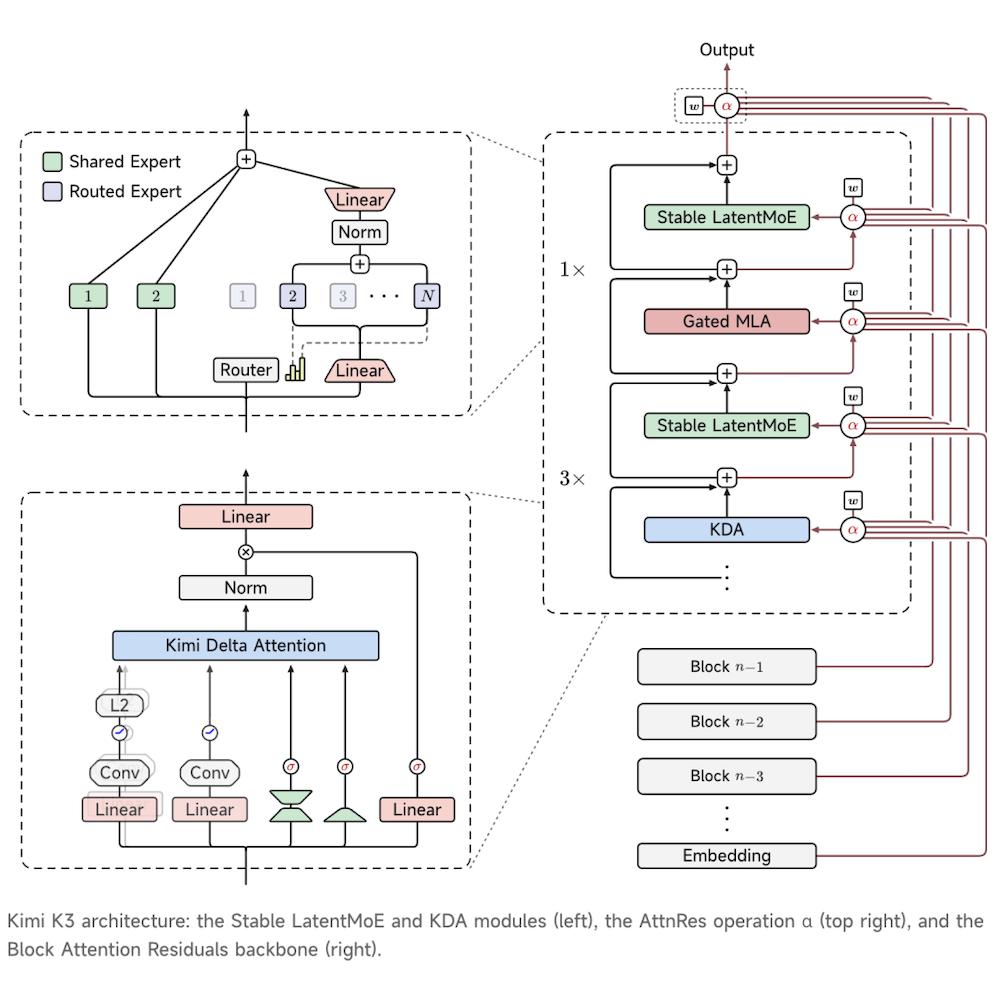
要实现2.8万亿参数的高效运转,传统的Transformer架构已难以独力支撑。Kimi K3的成功,很大程度上归功于其在底层架构上的两项关键创新:Kimi Delta Attention(KDA)与Attention Residuals(AttnRes)。这两项技术升级并非简单的堆砌,而是针对长序列处理与信息流动效率的深层优化。
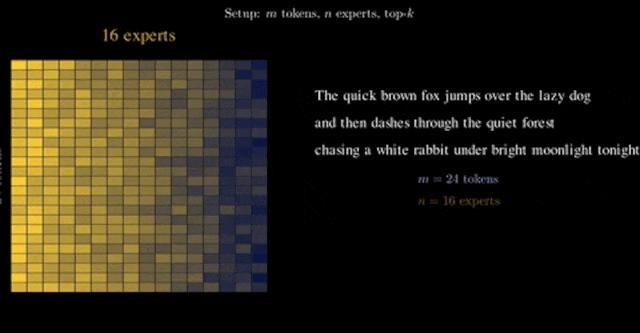
KDA机制通过改进注意力计算方式,使得信息能够在更长的序列和更深的网络层中顺畅流动,显著降低了长上下文推理中的算力损耗。与此同时,AttnRes技术则通过残差连接优化,增强了模型在处理极端复杂任务时的稳定性与收敛速度。结合更高稀疏性的混合专家(MoE)设计,Kimi K3在896个专家中仅需激活16个即可完成推理,这种极致的稀疏化策略不仅提升了扩展效率,还大幅降低了推理时的内存占用。
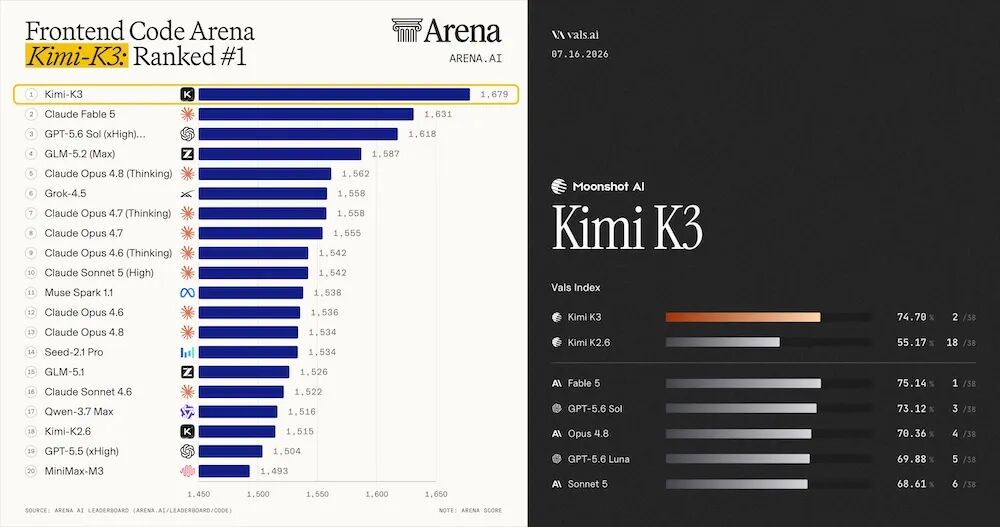
数据显示,相比前代Kimi K2,Kimi K3的整体扩展效率提升了约2.5倍。这意味着在相同的算力投入下,Kimi K3能够产生更强大的智能表现。此外,从SFT(监督微调)阶段引入的量化感知训练技术,采用MXFP4权重和MXFP8激活值,进一步平衡了精度与吞吐率。这些底层技术的协同作用,使得2.8万亿参数的大模型在保持百万token上下文支持的同时,推理成本得到了有效控制,为大规模商业应用扫清了障碍。
能力跃迁:从代码生成到复杂工作流交付
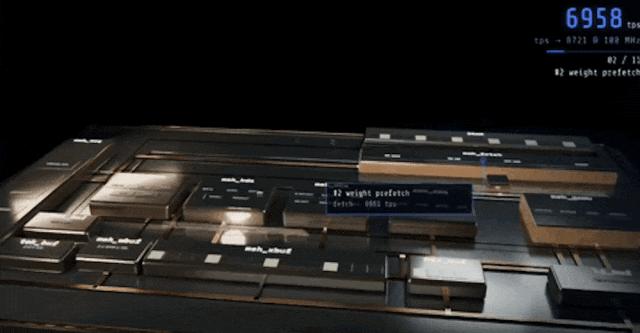
Kimi K3的强大不仅体现在基准测试的数字上,更体现在其对复杂真实场景的解决能力上。在编程领域,Kimi K3展现了类似资深工程师的思维模式。它不仅能理解数百万行代码的大型代码库,还能自主调用终端工具进行GPU内核优化、编译器开发甚至芯片设计。
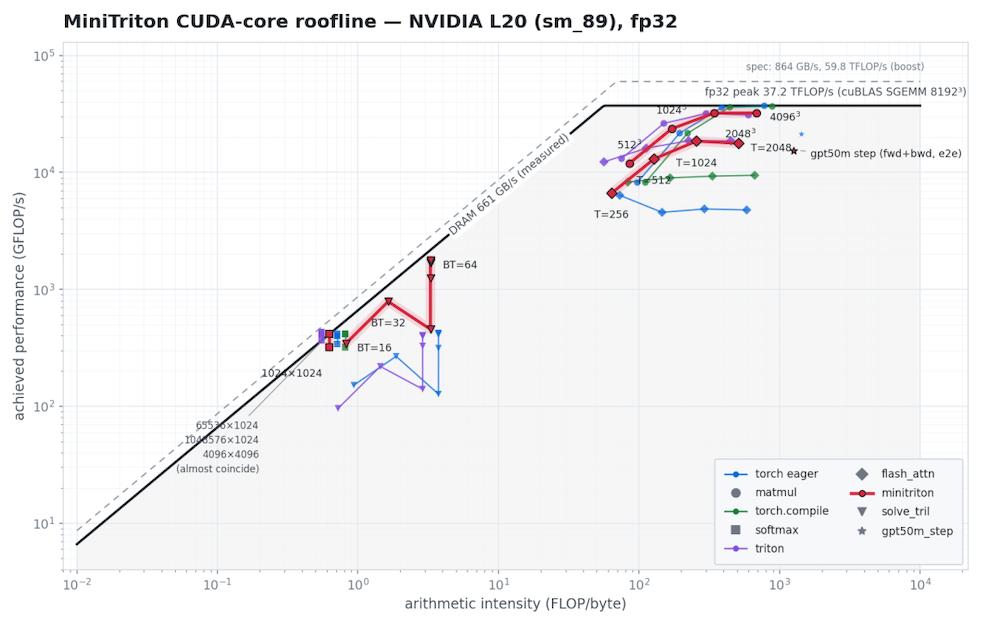
在一项关于构建完整GPU编程系统的演示中,Kimi K3从零开始开发了类似Triton的编译器MiniTriton,并成功将其转换为GPU可执行代码。在性能测试中,该编译器在部分场景下甚至超越了现有主流工具。此外,在芯片设计领域,Kimi K3在连续48小时的自主Agent运行中,基于开源EDA工具完成了芯片的构建、优化与验证,展示了其在超长时间跨度任务中的稳定性。
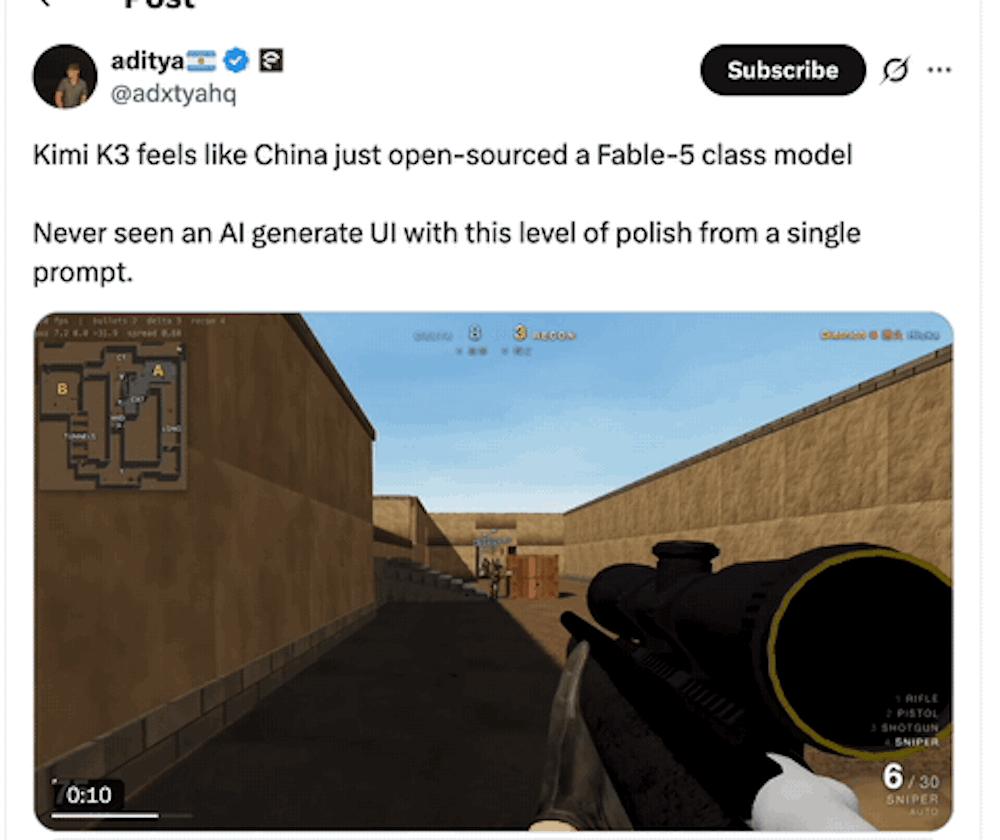
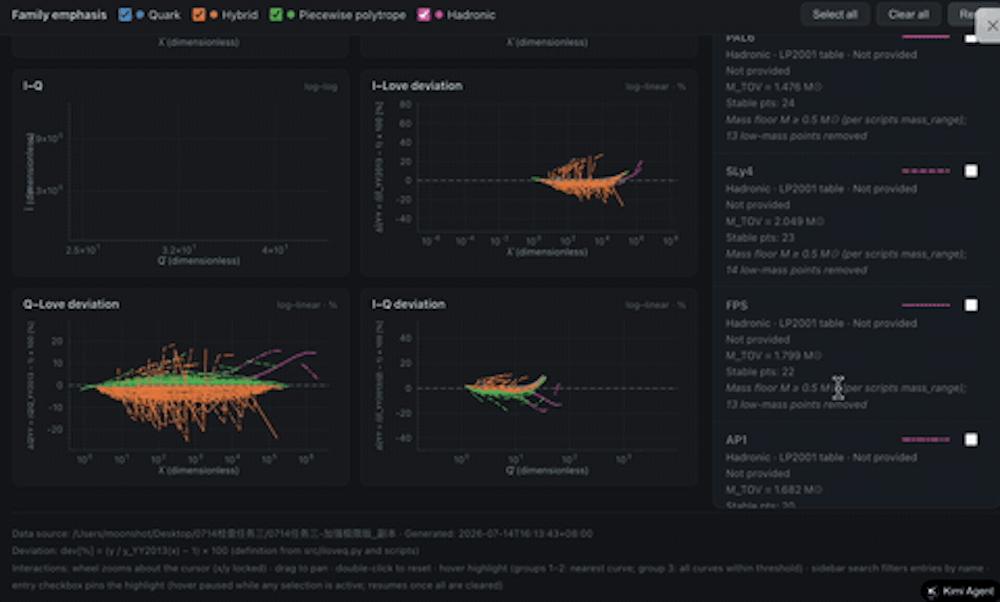
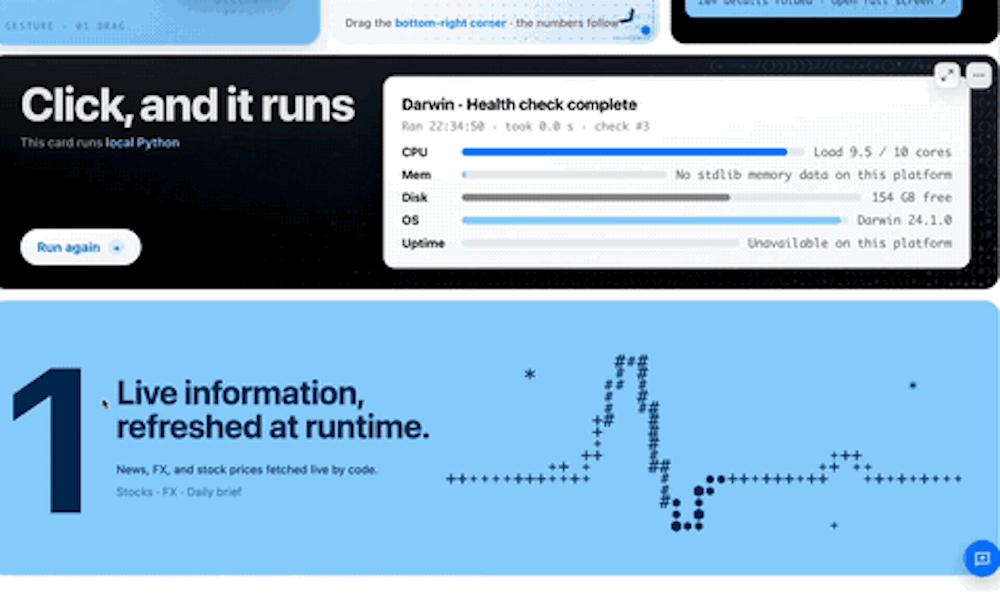
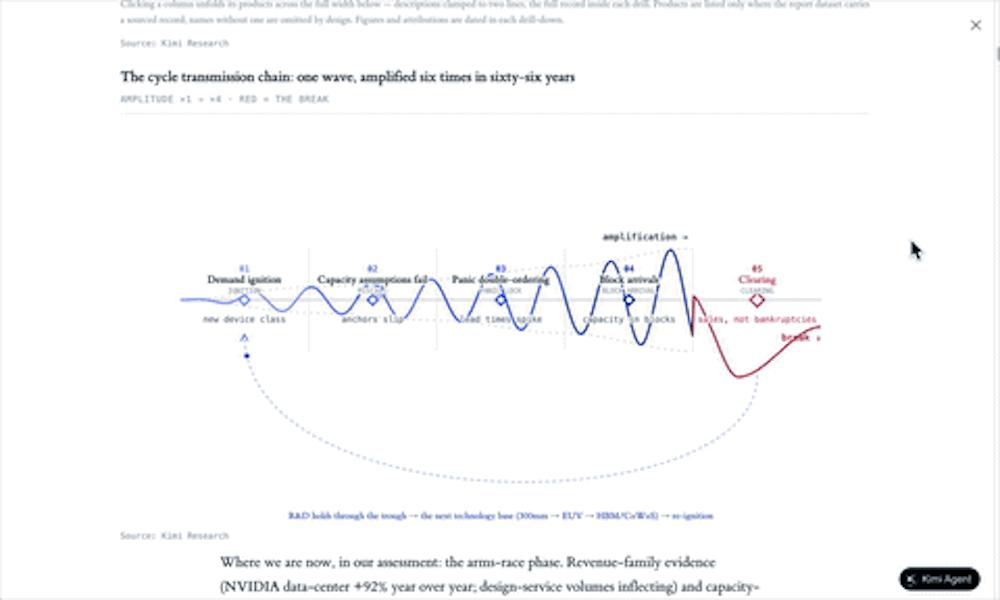
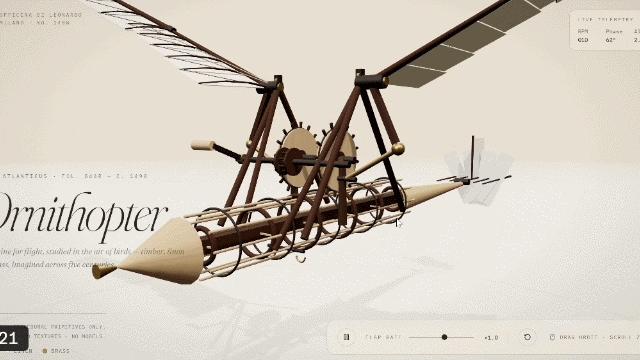
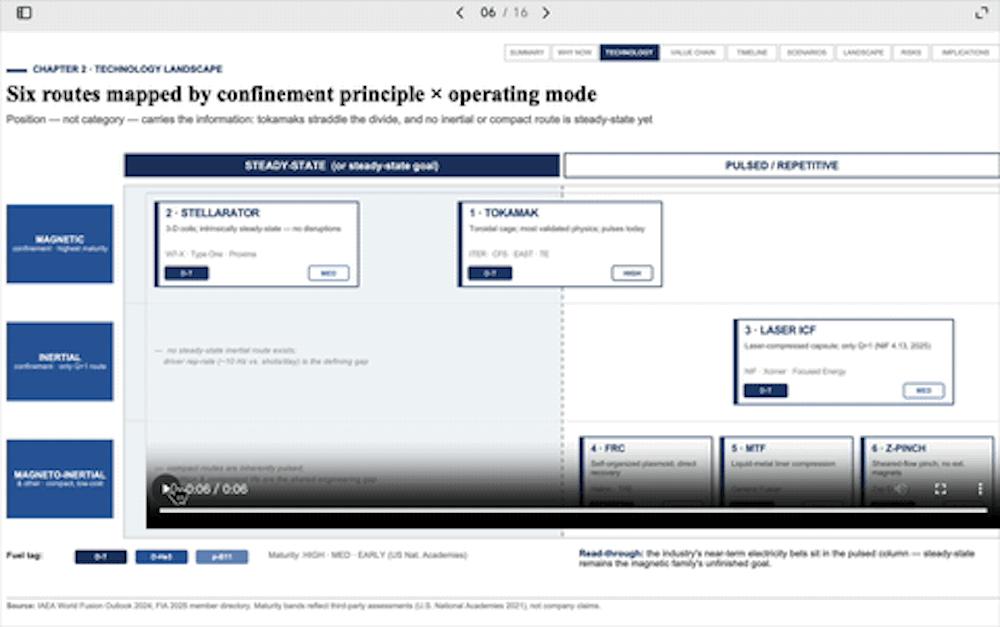
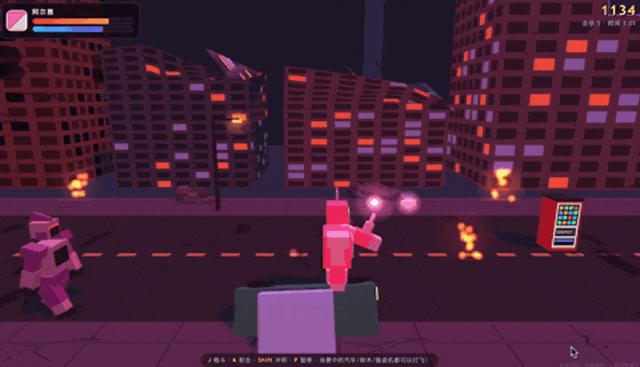
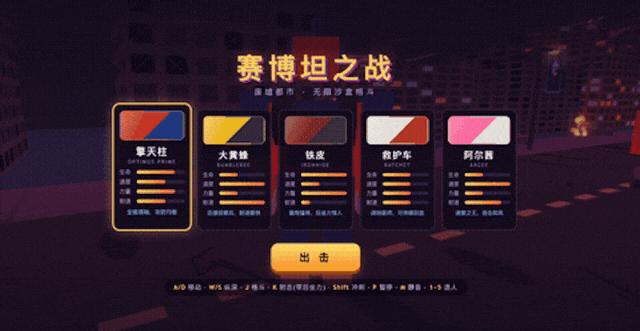
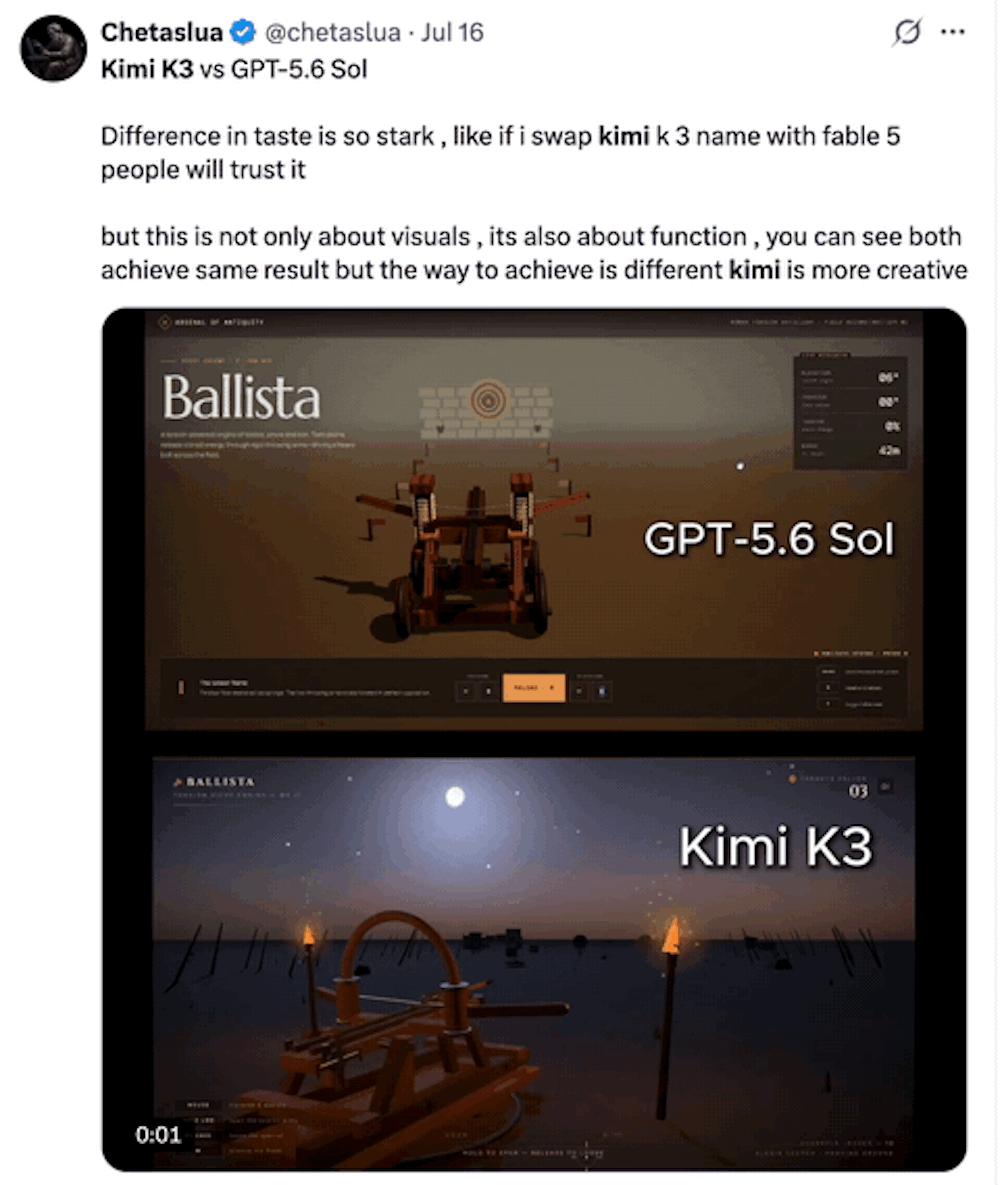
在知识创作与多模态应用方面,Kimi K3同样表现出色。它能够理解并整合跨领域的复杂知识,例如在生成“达芬奇工坊”模拟器时,模型不仅复现了视觉风格,还深入理解了扑翼机的历史背景与空气动力学原理。在科研分析场景中,Kimi K3通过调用20多个并发子智能体,对391个引力波事件进行分析,生成包含交互式可视化图表的科学报告。这种将视觉、编程与知识工作串联起来的完整流程能力,标志着大模型正从单一的“内容生成者”向“复杂任务执行者”转型。
评测透视:优势领域与现存短板
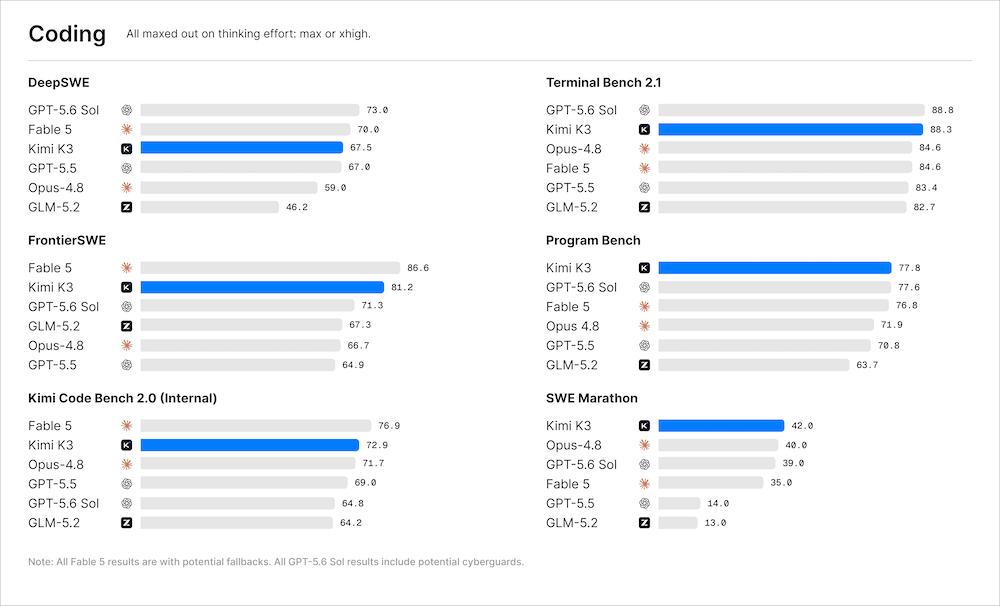
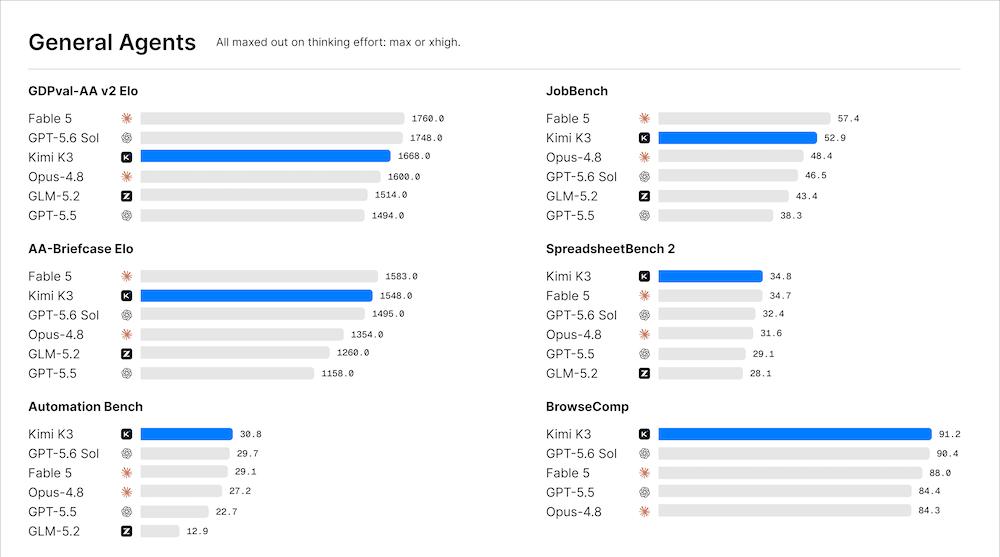
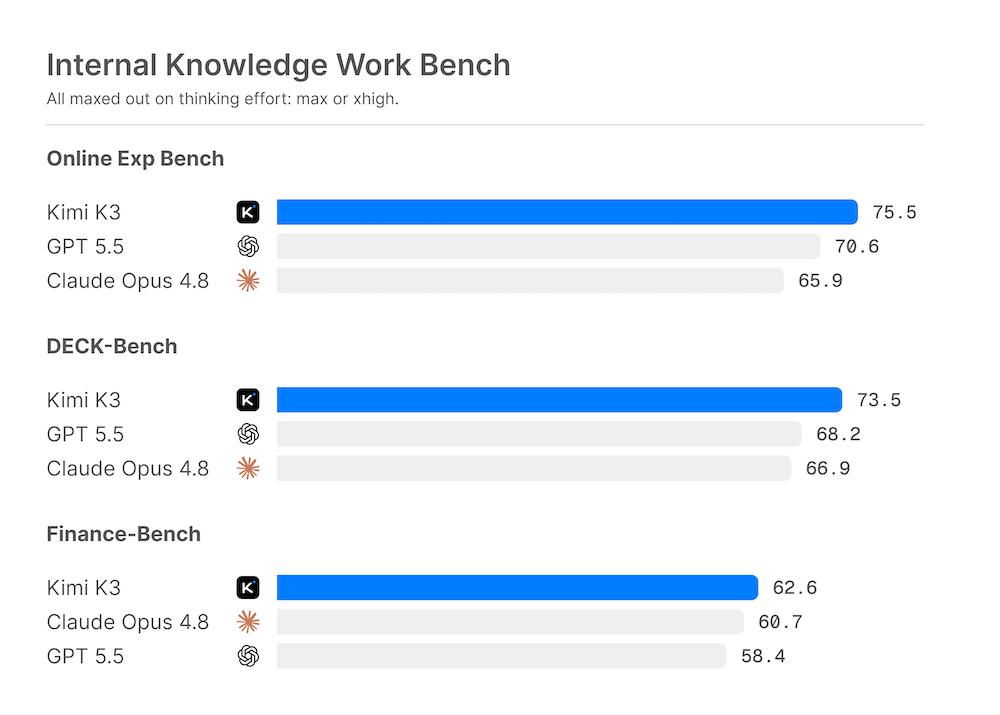
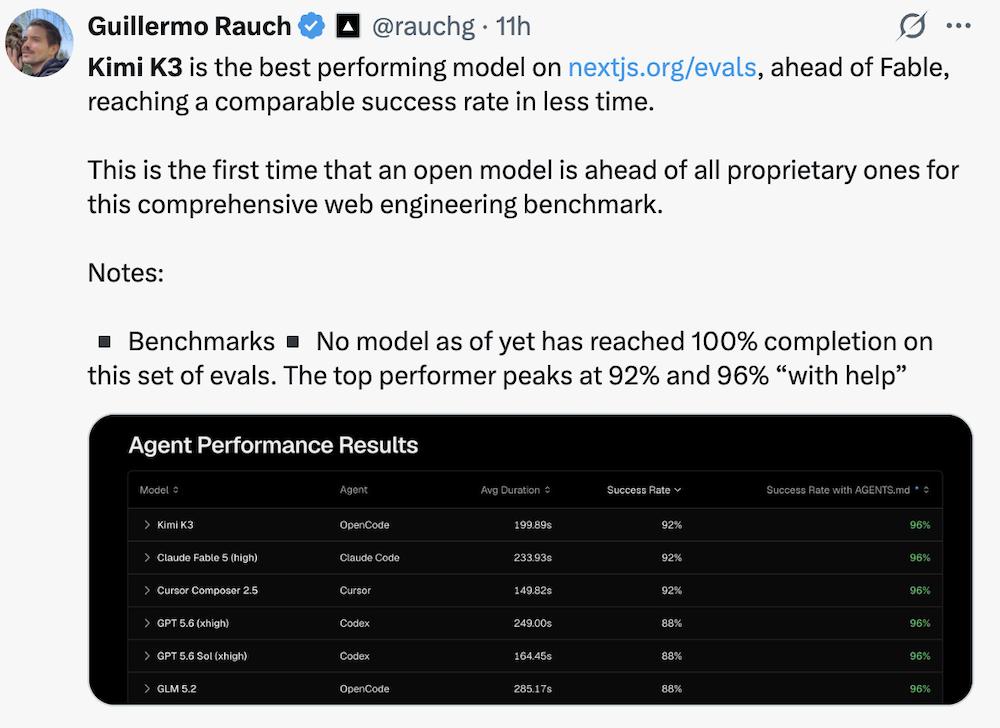
在多维度的评测体系中,Kimi K3展现出了明显的长板效应。在编程任务上,它在SWE Marathon和Program Bench测试中均取得第一名,展现了顶级的代码生成与修复能力。在Agent任务方面,其在网页深度调研(BrowseComp)和办公自动化(Automation Bench)测试中名列前茅,特别是在需要大量网页抓取与数据整合的场景中,表现优于多数竞争对手。
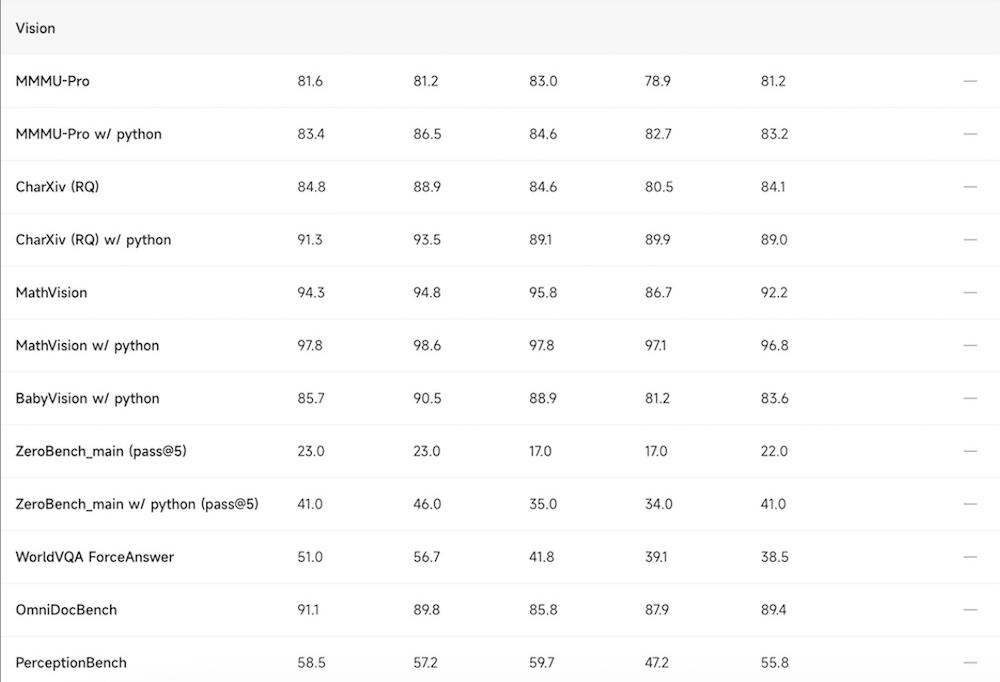
然而,评测结果也揭示了其存在的短板。在综合白领任务(GDPval-AA v2)和贴近真实办公流程的APEX-Agents评测中,Kimi K3的表现仍略逊于Claude Fable 5等顶级闭源模型。此外,在零样本视觉工具任务(Zerobench)中,其视觉推理能力也存在差距。这表明,尽管Kimi K3在特定垂直领域已具备顶尖水平,但在通用性、意图理解的细腻度以及多模态推理的鲁棒性上,仍有提升空间。
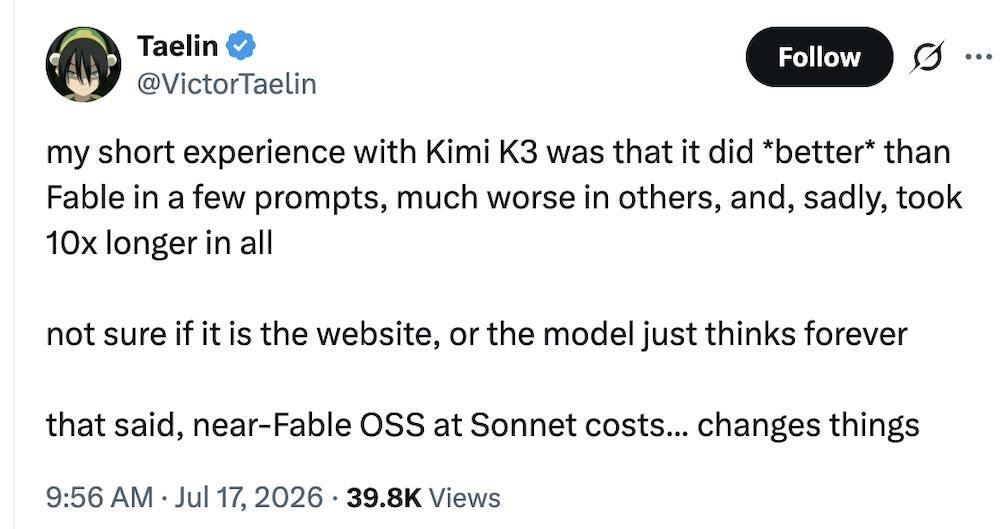
值得注意的是,部分独立测评指出,Kimi K3在生成高质量内容时耗时较长,有时是竞品模型的10倍。这反映了超大参数模型在推理速度上的物理限制。虽然通过架构优化缓解了部分延迟问题,但如何在速度与质量之间找到最佳平衡点,仍是后续迭代的重点。
商业考量:价格战背后的战略意图
Kimi K3的定价策略是其最具杀伤力的武器之一。相比Kimi K2.6,新模型的API价格有所上调,输入价格从6.5元/百万token上涨至20元(未缓存命中),输出价格从27元上涨至100元。这一调整反映了超大参数模型在算力成本上的现实压力。然而,与Claude Fable 5相比,Kimi K3的价格优势依然显著。Claude Fable 5的输入价格高达约67.78元人民币,输出价格约为338.88元人民币,而Kimi K3的输出价格仅为前者的大约三分之一。
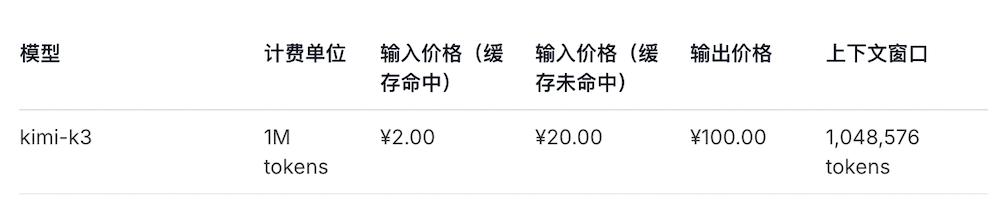
这种定价策略不仅体现了Kimi在成本控制上的技术实力,更是一种明确的市场信号:开源大模型正在具备与闭源巨头同台竞技的经济可行性。对于开发者而言,这意味着可以在不牺牲太多性能的前提下,大幅降低应用开发的边际成本。随着完整模型权重的即将开源,Kimi K3有望在开源社区引发新一轮的二次开发热潮,进一步加速AI应用在各行业的渗透。
未来展望:开源大模型的进化方向
Kimi K3的发布并非终点,而是开源大模型向超大规模迈进的新起点。随着模型参数规模的持续扩大,如何进一步提升推理效率、降低使用成本,并缩小与顶级闭源模型在用户体验上的差距,成为行业共同面临的挑战。
未来的竞争将不再仅仅局限于参数数量的比拼,而是转向架构创新、数据质量以及智能体工作流的深度整合。Kimi K3所展现的长程Agent执行能力,预示着大模型将更多地扮演“员工”而非“工具”的角色。通过自主规划、执行与反思,大模型将能够处理更加复杂、长周期的业务场景。
同时,安全性与可靠性也将成为关键议题。由于Kimi K3在训练时保留了思维历史,且在复杂任务中表现过于主动,官方建议用户在系统提示词中设置更明确的行为边界。这提醒业界,在追求智能提升的同时,必须建立完善的对齐机制与安全护栏,确保模型行为的可控性与可解释性。
总体而言,Kimi K3的出现标志着开源大模型已进入“深水区”。它不仅展示了中国AI团队在基础模型研发上的强劲实力,更为全球人工智能生态提供了另一种高效、低成本的发展路径。随着开源社区的活跃贡献与技术迭代的加速,大模型的应用边界将被进一步拓展,推动人工智能从技术探索迈向全面产业落地的新阶段。