Gemini 3.5 Pro延期背后:谷歌为何陷入AI大模型性能瓶颈?
从狂欢到沉寂:一次发布会背后的信号
就在短短48小时前,人工智能领域还弥漫着一股即将迎来历史时刻的亢奋情绪。社交媒体与科技媒体铺天盖地地流传着关于谷歌下一代旗舰模型Gemini 3.5 Pro(内部代号“Cappuccino”)的传闻。传闻中,这款拥有200万token超长上下文窗口、搭载全新“深度思考”推理模式的模型,不仅在数学和逻辑推理上展现出惊人潜力,更在代码编写、智能体工作流等硬核指标上被传为已经超越了OpenAI的GPT-5.6 Sol和Anthropic的Claude Fable 5。对于外界而言,这似乎标志着谷歌终于准备好亮出终极武器,对竞争对手发起全面反击。
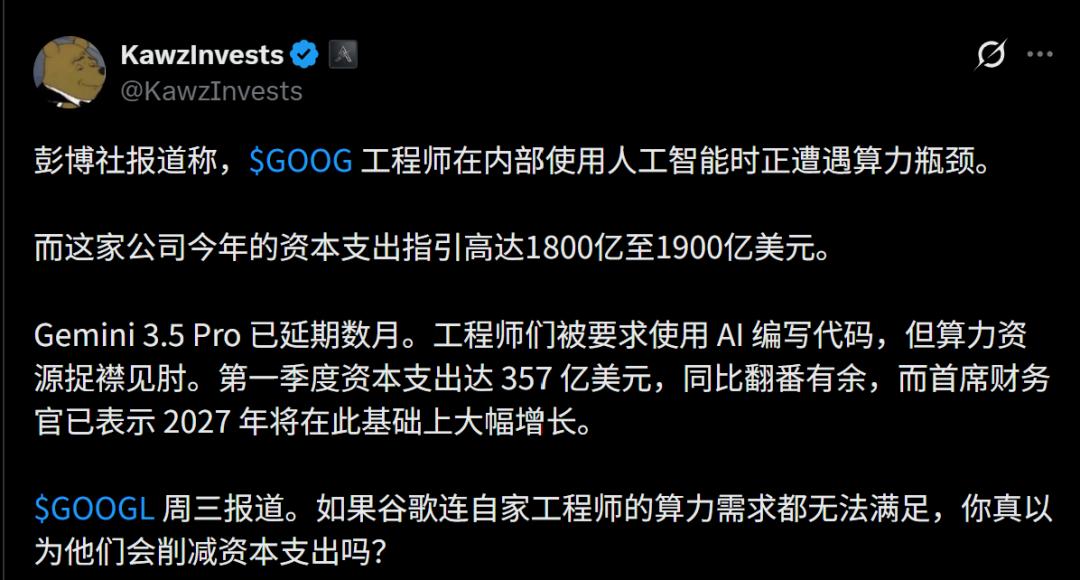
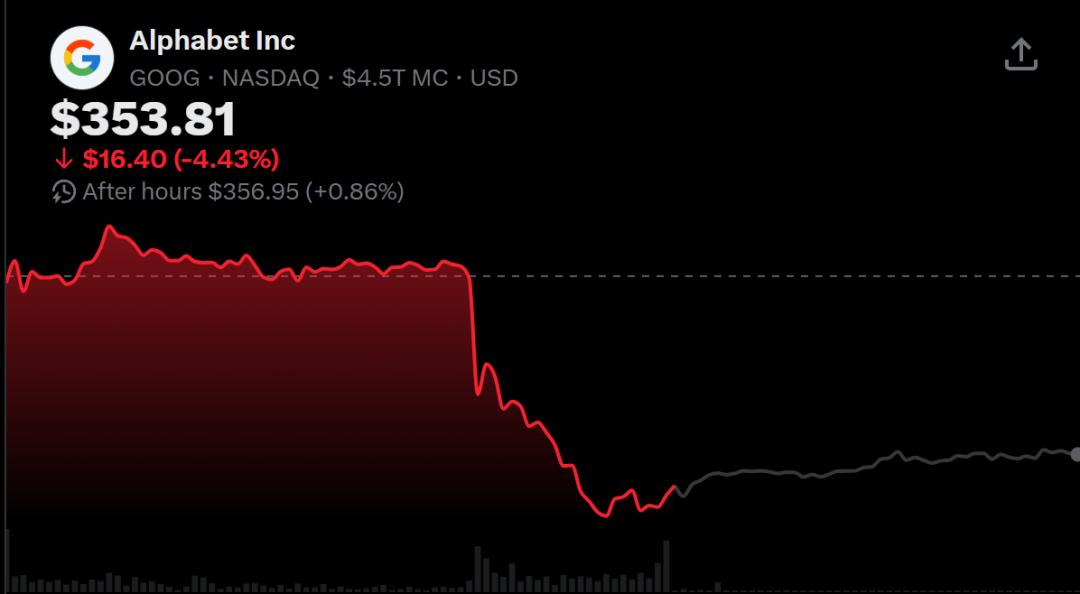
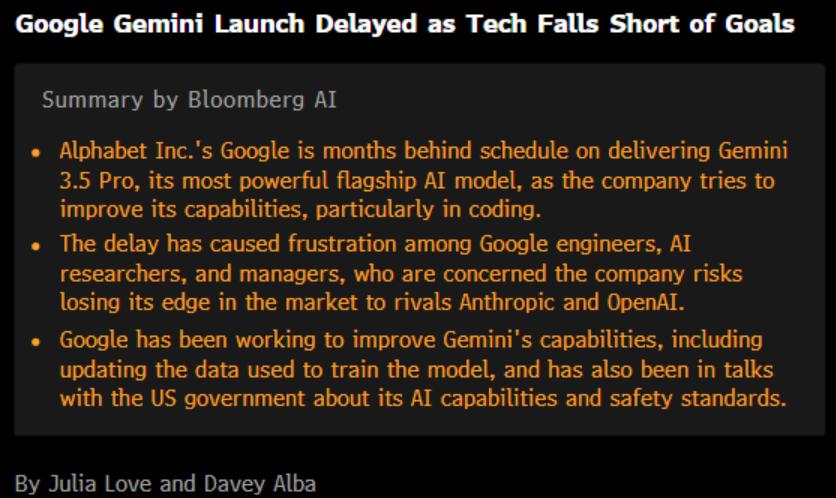
然而,现实给予的热情一盆冰水。彭博社随后发布的独家报道彻底颠覆了前一日的乐观预期:Gemini 3.5 Pro的发布并非推迟几周,而是面临数月的重大延期。内部人士透露,核心症结在于模型的关键能力,尤其是备受关注的AI编码能力,未能达到谷歌内部极其严苛的验收标准。尽管谷歌在临近发布前紧急更新训练数据试图冲刺,但结果依旧“令人失望”。消息传出后,谷歌股价应声下跌超4%,这一波动不仅反映了资本市场对短期预期的修正,更暴露了硅谷巨头在面对技术落地时的脆弱心态。当OpenAI和Meta在代码能力上持续狂飙时,谷歌的停滞显得尤为刺眼,内部工程师与高管的焦虑感正在蔓延。
官僚巨兽的创新困境
Gemini 3.5 Pro的“难产”,表面看是技术指标的未达标,实则是谷歌庞大组织体系在AI时代转型期的结构性阵痛。作为一家拥有搜索、地图、YouTube、Cloud等无数万亿级收入业务线的科技帝国,谷歌的决策链条极度复杂。任何新模型的发布,都不能仅考虑技术本身的优劣,还需兼顾各业务线的需求与利益平衡。这种“既要又要”的决策模式,不可避免地导致了资源的分散和决策的迟缓。
一位前谷歌员工曾形象地比喻,协调这样一个巨头的内部方向,犹如“试图煮沸整个大海”。在快速迭代的AI领域,这种协调成本是致命的。当竞争对手以创业公司般的敏捷速度狂奔时,谷歌这艘巨轮却在内部的层级汇报、部门协调中消耗了大量宝贵的时间窗口。指令的频繁变动、多个部门重复造轮子的现象,使得原本应该合力攻坚的技术突破,变成了内部博弈的牺牲品。业界普遍认为,谷歌急需削减其臃肿的官僚体系,否则在AI竞赛中,这种组织惯性将成为其最大的竞争对手。
AI编码的“滑铁卢”与算力悖论
此次延期的具体导火索是AI编码能力的不足,这背后隐藏着谷歌更深层的技术与文化矛盾。一方面,谷歌拥有全球最顶尖的工程师文化,这种文化有时也演变为一种“纯血统”情结。许多资深工程师深信,关键代码应由人工精心编写,对AI生成代码的信任度较低。这种文化惯性不仅限制了AI工具在内部开发流程中的渗透,还导致了专有代码泄露到训练数据中的担忧,从而在某种程度上阻碍了模型通过内部使用进行自我进化的机会。
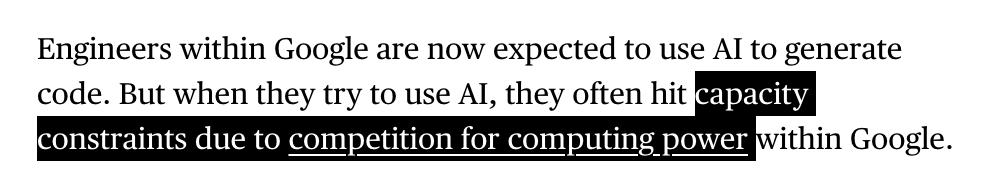
当谷歌意识到必须强制推广AI辅助编程时,另一个严峻的问题浮出水面:算力资源的不合理分配。报道指出,尽管谷歌今年预计的资本支出高达1800亿至1900亿美元,但在第一季度就烧掉了357亿美元用于购买芯片和建设数据中心,然而,其内部工程师在使用自家AI工具时,却频繁遭遇算力容量限制。这种“拥有海量算力却无处可用”的荒诞景象,成为了讽刺性的注脚。首席AI架构师试图通过统一底层架构成立专项团队来解决问题,但在既得利益和技术债的双重拖累下,亡羊补牢的效果尚待观察。
内部赛马与人才流失的恶性循环
谷歌并非没有意识到问题所在,其内部的“赛马机制”曾是创新的重要驱动力。DeepMind、Google Cloud、安卓团队等各自拥有独立的AI研究小组,旨在通过内部竞争激发活力。然而,在AI大模型这一需要巨大协同效应的领域,这种机制逐渐异化为内耗。不同团队之间战略摇摆、产品重叠,导致资源无法集中力量办大事。
更严重的后果体现在人才流失上。由于对谷歌内部效率低下的失望,大量顶尖的研究人员选择离开,跳槽至Anthropic和OpenAI等竞争对手。这形成了一个危险的闭环:官僚主义导致效率低下,效率低下导致产品竞争力下降,产品落后引发人才流失,而人才的进一步流失则加剧了技术的滞后。Gemini 3.5 Pro的延期,正是这一恶性循环在最新项目上的具体体现。当核心骨干不断流失,剩下的组织架构越发僵化,创新能力的枯竭便成了必然结果。
“失望陷阱”:全行业的周期性寒冬
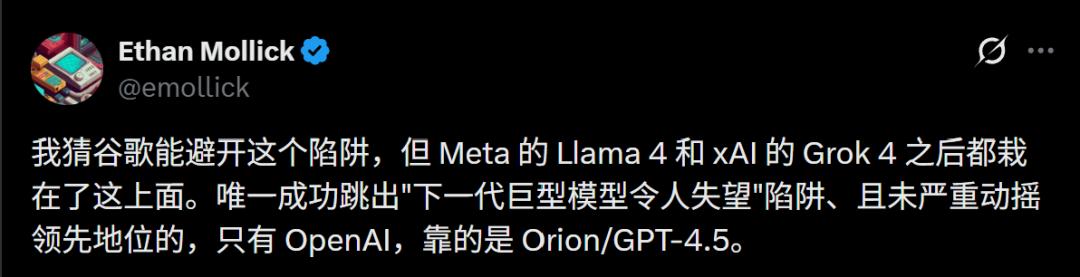
沃顿商学院教授Ethan Mollick指出,谷歌的挫折并非孤立事件,而是整个硅谷正在经历的“周期性技术寒冬”的典型缩影。他将这种现象命名为“下一代巨模型失望陷阱”。过去几年,行业迷信Scaling Law(缩放定律),认为只要不断堆砌算力和数据,模型性能就能线性甚至指数级提升。然而,随着模型规模的扩大,单纯依靠“暴力美学”的边际收益正在急剧递减。
目前,行业正面临双重瓶颈:一是高质量人类文本数据几乎被榨干,合成数据的有效性和安全性仍有待验证;二是现有Transformer架构及其变体可能正在接近性能上限,为了获得微小的性能提升,需要付出指数级增长的算力成本。在这一背景下,除了OpenAI凭借GPT-4.5等系列暂时维持领先外,包括Meta的Llama系列、xAI的Grok系列在内的众多巨头都遭遇了类似的性能提升放缓的困境。
Gemini 3.5 Pro的延期,迫使行业重新审视AI发展的节奏。它表明,我们可能正处于一个平台期,过去那种“AI一天,人间一年”的狂飙突进阶段正在告一段落。对于谷歌而言,市场留给它的耐心和窗口期正在迅速收窄。如果无法从组织机制、技术路径和资源配置上进行根本性的变革,即便推出了下一代模型,也难以重现昔日的辉煌。对于整个AI行业而言,这也意味着投资逻辑的转向:从盲目追求参数规模,转向追求模型的实际效能、垂直领域的深度应用以及更高效的算力利用。喧嚣褪去后,真正的价值创造才刚刚开始。