2004年创办的AI原生企业,如何打破药物研发40%临床失败魔咒?
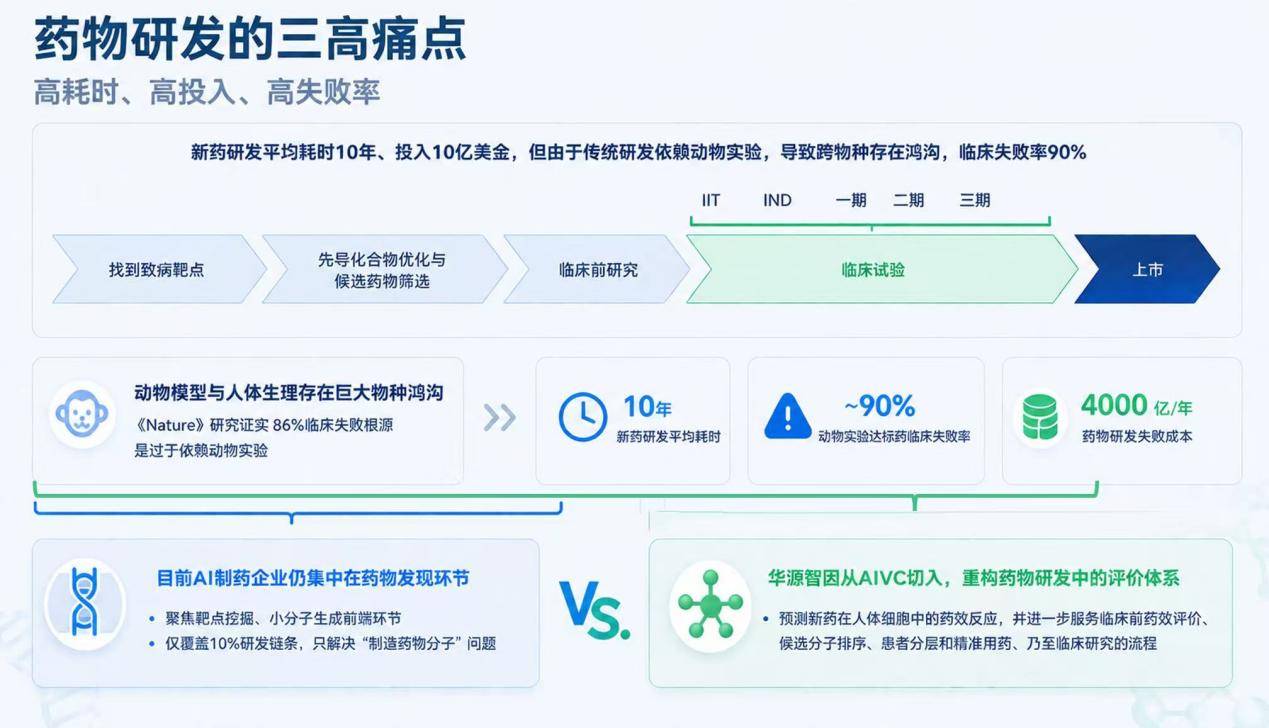
在全球医药研发的宏大版图中,一个令人扼腕的数据长期悬浮:每年超过2万亿元的研发投入中,约有4000亿元消耗在临床阶段的彻底失败。《Nature》的一项公开研究进一步揭示了这一现象的生物学根源——86%的新药在临床试验中折戟,其核心痛点在于小鼠、猴子等动物模型与人类复杂的生理机制之间存在难以逾越的物种鸿沟。在这种背景下,一款新药从发现到上市,平均耗时10年,耗资10亿美元,而最终获得监管批准的概率仅徘徊在10%左右。
面对如此高昂试错成本,当前主流的AI制药企业大多将技术矛头指向药物发现的上游环节,如靶点挖掘、分子结构生成等。这些技术确实将药物发现的效率提升了数倍,但它们仅覆盖了药物研发总成本的约10%。更关键的命题是:即使找到了完美的分子结构,它在人体内是否真的有效?华源智因(GENESIGHT)的创立,正是为了回答这个被行业长期忽视的核心问题。
痛点重构:从“造钥匙”到“测锁芯”
华源智因的逻辑起点,是对传统药物研发评价体系的深刻反思。创始团队认为,药企在早期阶段并不缺乏分子数量,缺乏的是对分子成药性的精准预判。传统的体外细胞实验和动物实验,由于缺乏真实人体的微观环境,往往会产生巨大的偏差。这种偏差导致大量在实验室中表现优异的候选药物,在进入人体临床试验后“原形毕露”。
因此,华源智因选择将AI技术的介入点向后推移,聚焦于药物进入临床前的高风险环节。其核心愿景是成为药物研发行业的“金标准”,不仅预测药物分子的化学结构,更预测其在人体细胞层面的药效反应。这就好比过去的AI制药主要在“制造钥匙”,而华源智因则致力于判断这把钥匙插入真实人体这把“锁芯”时,转动的顺畅程度如何。
与Recursion等海外巨头不同,华源智因并未单纯依赖临床文本或影像数据,而是深耕细胞多组学层面。临床文本和影像数据虽然能展示治疗结果的“果”,却难以解释药物作用的“因”。细胞层面的多组学数据则不同,它能够拆解药物对基因组、转录组、蛋白组的深层影响,为药企提供更具生物学解释力的决策依据。
技术破局:体内外全链路数据闭环
华源智因的技术护城河建立在两大核心支柱之上:多模态虚拟细胞数据底座UniOme,以及药物扰动智能平台Wise-Perturb。
虚拟细胞的构建难点不在于模型参数的大小,而在于训练数据的真实性与多样性。传统的虚拟细胞模型多依赖工程化的细胞系数据,这些数据虽然便于标准化操作,但经过多年传代,往往丢失了真实患者的个体特征和疾病微环境信息。华源智因独创了一套三级递进式数据体系:底层基于单细胞/多模态基础数据,中层整合基因/药物扰动数据,顶层则引入真实患者用药前后的药效反馈数据。这种结构确保了模型既能描述细胞状态,又能预测药物扰动下的动态变化,更能在真实人体场景中校准预测结果。
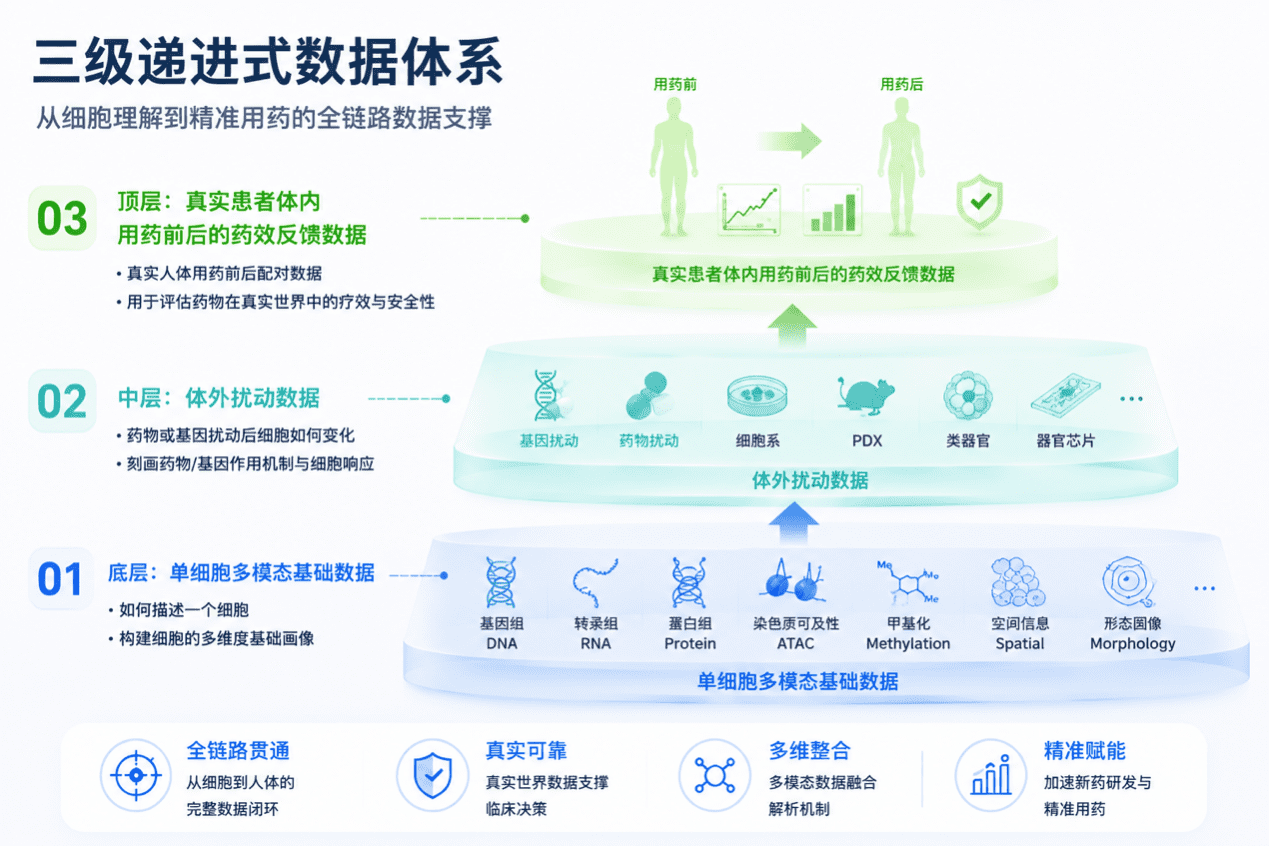
为了实现这一数据体系,华源智因自研了首个高通量单细胞跨模态测序技术UniOme。传统测序技术往往需要破坏细胞结构,导致无法在同一个细胞内同时获取DNA、RNA和蛋白质等多层信息,进而需要通过不同细胞的数据拼接来还原真相,这必然引入巨大的噪声。UniOme技术实现了在同一个细胞内对多层生物信息的严格对齐,相当于不仅记录了人的“体重”,还同步记录了“身高”、“肤色”等维度。这种数据维度的跃升,使得AI模型能够捕捉到更细微的生物学信号。
在Wise-Perturb平台上,药企可以将候选化合物的多维编码与目标细胞的测序数据输入模型,进行虚拟扰动实验。模型能够预测扰动后细胞全转录组层面的表达变化,并据此计算药效评分,对候选药物进行排序。测试数据显示,在私有大规模数据集上,Wise-Perturb的关键预测指标较国际公开模型提升了40%至130%,差异表达基因的预测误差降低了约41.77%。更重要的是,该模型具备强大的零样本泛化能力,能够跨药物、跨细胞、跨患者进行精准预测,极大减少了湿实验的轮次与成本。
临床落地:从理论验证到商业闭环
技术的价值最终需要在临床场景中经受检验。截至目前,华源智因已与多家超一线三甲医院建立了深度合作,围绕真实患者用药前后的组织样本,构建了专病、专模型的数据闭环。
在与医学科学院肿瘤医院的合作案例中,团队利用肺癌患者用药前的样本数据和药物分子结构,对后续药效进行了预测排序。结果显示,模型输出的疗效分层结果与临床医生的实际观察高度吻合。这一成果的意义在于,它验证了模型在真实临床决策前的预测能力,而非仅仅在公开数据集上的指标游戏。在另一项针对DS-8201药物的测试中,模型基于PDX样本的Bulk RNA-seq数据,成功预测了个体样本的药物响应,与新适应症、新人群中的体内药效实验结果高度一致,展现了极强的泛化潜力。
基于这些验证,华源智因目前已在三大场景推进商业化落地:一是临床患者分层,联合三甲GCP临床试验中心,优化试验队列;二是模型能力变现,通过药物重定位、靶点筛选等服务绑定药企;三是数据平台合作,通过自动化测序扩充高质量训练数据,反哺模型迭代。
团队基因与未来展望
华源智因的成功离不开其极具互补性的创始团队。CEO杜润诗虽年轻,但拥有深厚的学术背景与连续创业经验,对AI+生命科学有独到见解;CTO王艺璇作为虚拟细胞领域的Native学者,长期深耕单细胞AI;CFO陈聪则带来了十余年的医药产业资源与资本网络。此外,首席创新官黄诗云在基因扰动生成模型方面的研究,以及首席联络官卓鑫凯的量化商业支撑,共同构成了团队严丝合缝的能力拼图。
展望未来,华源智因并不满足于仅做一名AI CRO服务商。其终极目标是搭建一套生命科学领域的OS(操作系统),即“生命科学世界模型”。这套系统不仅能预测药物反应,未来甚至能模拟人体对咖啡、运动等日常行为的生理响应。这将把AI应用从狭窄的药物研发扩展至广阔的大健康领域,成为AI生命科学的基础设施。
随着数千万元种子轮融资的完成,华源智因将继续加速数据、模型和临床三大核心壁垒的建设。在药物研发从“经验驱动”向“数据驱动”转型的关键节点,华源智因正试图用虚拟细胞技术,填补动物模型与人体真实反应之间的巨大空白,为制药行业提供一条确定性更高的创新路径。