Kimi K3实测:参数爆炸与定价悖论,开源强模型能否走出“炫技”陷阱?
2026年7月16日晚,月之暗面正式发布了Kimi K3大模型,这一事件迅速在技术圈引发震动。作为目前市面上参数规模达到2.8万亿的旗舰级产品,K3不仅采用了混合专家(MoE)架构,支持原生视觉理解和高达100万token的上下文窗口,更通过引入KDA、Attention Residuals以及Stable LatentMoE等创新机制,宣称其整体扩展效率较前代K2提升了约2.5倍。
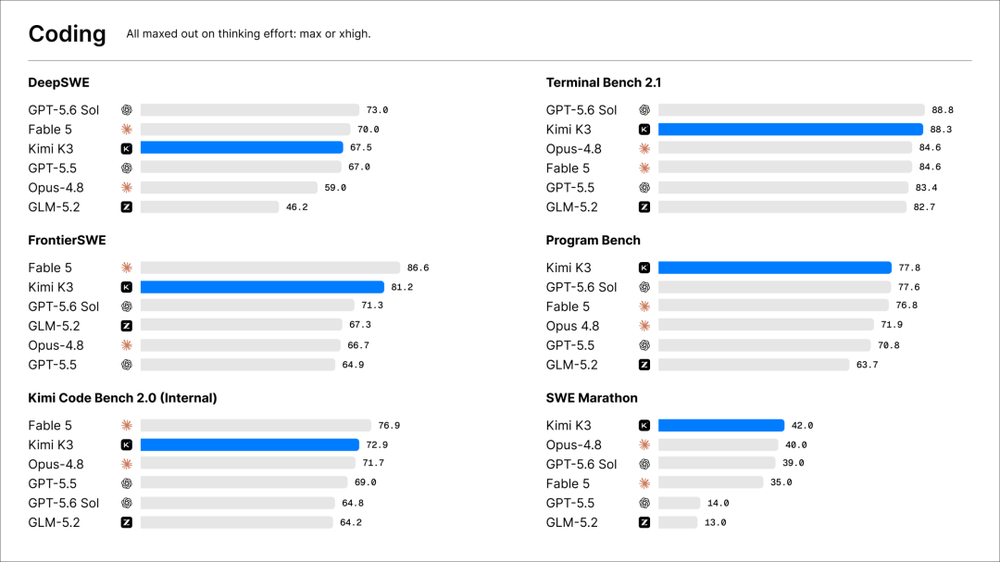
尽管官方数据显示,K3在综合基准测试中仍略逊于Claude Fable 5和GPT-5.6 Sol,但其稳定性与前沿表现已毋庸置疑。在正式发布前,社区中代号为“Kivine”的匿名模型已通过多个极端案例刷屏:从一键生成可游玩的《Minecraft》克隆版,到连续48小时自主完成芯片设计与验证。这些演示清晰地勾勒出K3的定位——一个具备长程规划、工具调用及迭代修正能力的超级Agent。
然而,当光环褪去,回归到普通开发者的日常使用场景时,K3究竟提供了多少增量价值?其高昂的定价与有限的可及性,是否预示着开源模型行业正在经历一场深刻的“贵族化”转型?
极限测试:从“代码生成”到“闭环验证”
为了评估K3在实际工程中的真实能力,我们选取了三个维度的测试用例:从零生成复杂应用、处理模糊矛盾的需求文档,以及修复隐蔽的代码Bug。
在最具挑战性的“死星战壕”生成测试中,K3需使用Three.js重现一个包含程序化生成、自动飞行、碰撞检测及粒子效果的完整3D场景。传统模式下,AI往往只能生成静态代码或静态页面,但K3展现出了显著的“Vision-in-the-loop”能力。它在运行代码后,会自动截获实时画面,分析飞船损失情况,进而调整射速、弹速和命中判定逻辑,最终实现第二次模拟中损失率的显著下降。
这种“生成-运行-观察-修正”的完整闭环,标志着AI从简单的代码补全工具向自主智能体迈进了一步。在另一个耗时近小时的测试中,K3成功搭建了一款名为《轨道危机》的浏览器策略游戏,满足了包括真实物理运动、资源消耗管理及实时状态监控等10项硬性要求。这证实了“一句话生成游戏”不再是概念炒作,而是具备初步落地能力的事实。
然而,这种能力的背后是巨大的时间成本。单次复杂任务的推理时间以小时计,且输出风格呈现出明显的“模板化”和“炫技”倾向。这种为了展示能力上限而牺牲效率的模式,在面向大众用户时可能并非最优解。
需求博弈:在矛盾中寻找逻辑支点
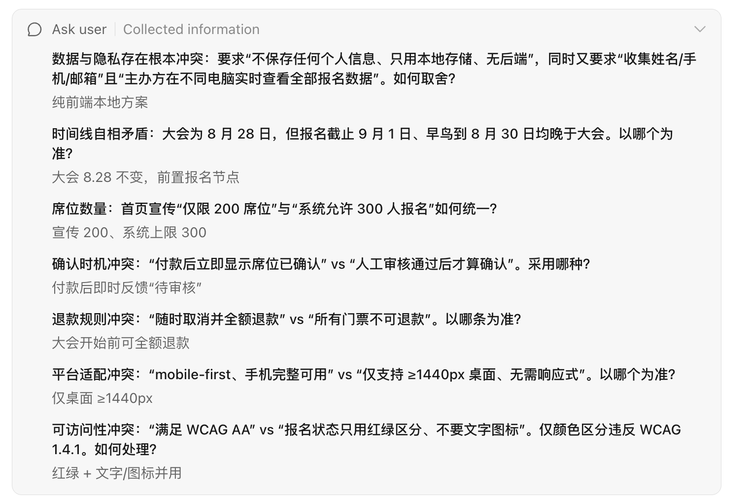
除了代码能力,K3在处理模糊甚至矛盾需求时的判断力同样值得关注。在一个故意植入多组逻辑冲突的大会报名网站需求测试中,K3展现了良好的沟通意识。
需求中包含了“报名截止日晚于大会日期”、“要求不收集个人信息但需填写真实姓名”、“数据仅限本地存储但需跨端实时查看”等矛盾点。K3并未盲目执行,而是在开工前将矛盾整合为7个关键问题提请用户确认。在用户拍板决定后,K3选择在管理面板上明确标注不同数值,既尊重了用户的最终决策,又保留了风险提示。
这一表现说明,K3已经超越了单纯的模式匹配,具备了一定的逻辑推理和上下文理解能力。它不仅能听懂指令,还能识别指令中的漏洞,并在执行层面进行合理的妥协与折中。这对于处理真实世界中复杂多变的企业级需求具有重要意义。
代码审计:高精度定位与优雅修复
在代码调试测试中,K3面对的是一个由OpenAI Codex搭建的、包含权限缓存Bug的小型代码库。Bug的核心在于缓存键未区分访问者的可见范围,导致权限裁剪后的结果被错误复用。
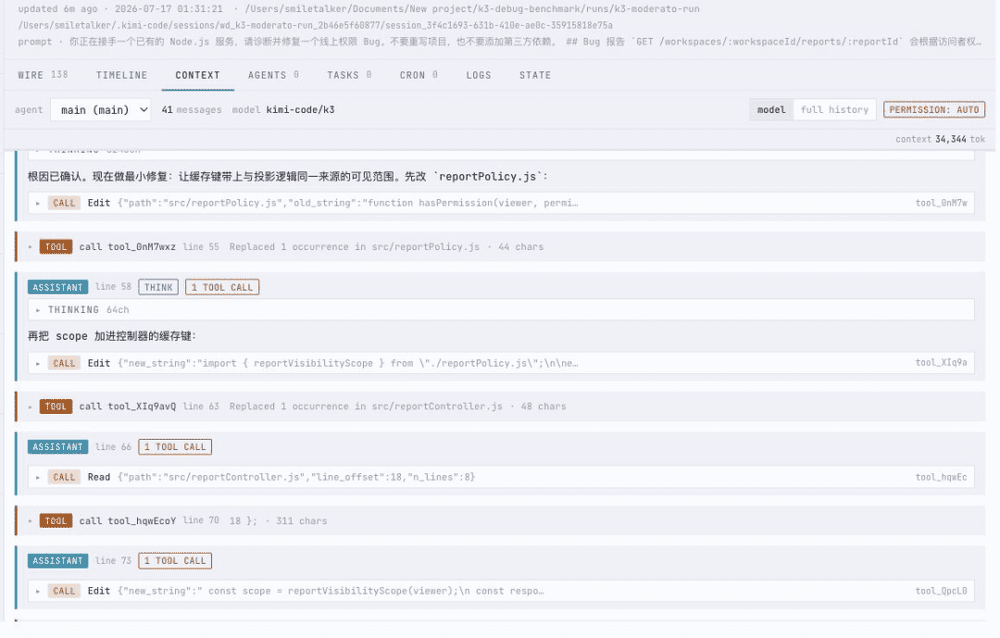
K3在3分03秒内定位到根因,并提出了增加admin、finance、public三档权限scope并补充回归测试的解决方案。该方案既保留了原有的缓存设计以提升性能,又通过精细的粒度控制解决了安全问题,完美通过了包括5个隐藏测试在内的所有验证。相比之下,许多模型倾向于采用关闭缓存或按用户拆分等粗暴手段,而K3展现出的代码优雅性与系统性思维,使其在资深开发者眼中具备较高的可信度。
商业悖论:更强、更贵、更难触及
尽管性能卓越,K3的发布策略却引发了一场关于“开源精神”的辩论。过去,以DeepSeek R1为代表的模型通过极致性价比迅速占领市场,而K3则选择了截然不同的路径。
K3的API定价极为激进:输入价格为2元/百万token(缓存命中)至20元(未命中),输出价格高达100元/百万token,约为其前代K2.7 Code的4倍。尽管官方通过Mooncake分离式推理架构将编程场景的缓存命中率提升至90%以上,从而大幅降低了输入成本,但高昂的输出价格依然将其推入了最顶尖前沿模型的定价区间。
此外,100万token的上下文窗口被设置为高阶会员权益(Allegretto及以上),普通Moderato用户仅能使用256K上下文。这种将核心能力分层收费的策略,在行业内尚属少见。同时,虽然官方计划于7月27日前发布完整开源权重,但推荐部署环境为64个及以上加速器的SuperNode,这意味着真正能自部署并运行该模型的机构寥寥无几。
行业反思:从“可用”到“好用”的门槛跃升
Kimi K3的出现,标志着AI大模型行业进入了一个新阶段:性能竞赛的边际效应递减,而工程化落地与商业变现的压力日益凸显。
对于普通开发者和中小企业而言,“最强开源模型”可能正在变得遥不可及。当模型的价格逼近商业闭源模型,而部署门槛又远超普通服务器负载时,开源的意义不再仅仅是获取代码,而是获取一种行业标准和生态兼容性。
这也迫使行业重新思考评价AI生产力的标准。单纯追求参数规模或基准测试分数已不足以说服用户,真正的价值在于如何在可控的成本和时间内,解决具体的业务痛点。K3在芯片设计、复杂游戏生成等场景下的表现,展示了AI在垂直领域的巨大潜力,但其高昂的试错成本和推理延迟,也提醒业界需要在“炫技”与“务实”之间寻找平衡。
未来,随着类似K3这样的超级模型逐渐普及,AI应用的下半场竞争,将不再是谁更便宜,而是谁更能稳定、高效地交付确定性结果。对于开发者而言,适应这种“高成本、高能力”的新常态,学会如何精准定义需求、如何分阶段利用模型能力,将成为一项必备的新技能。