具身智能数据基建:千亿估值背后的真实泡沫与商业困局
数据鸿沟:具身智能的“上游战场”
在人工智能的版图中,具身智能(Embodied AI)正站在风口浪尖。从春晚舞台上灵动翻跳的机器人,到实验室里精准叠衣、充当售货员的智能体,具身智能的具象化展示令人惊叹。然而,当这些机器人走出聚光灯,进入真实的家庭或复杂的工业场景时,频繁出现的操作失误与“翻车”现象,暴露了行业最核心的痛点:数据短缺。
与语言大模型拥有数十万亿Token的预训练数据、自动驾驶积累百亿小时驾驶数据不同,具身智能目前公开可用的操作数据仅停留在几十万小时级别。这种巨大的数据鸿沟,不仅制约了模型泛化能力的提升,更催生了一条独立且备受资本追捧的新赛道——具身智能数据基建。过去半年间,资本以惊人的速度涌入这一领域,光轮智能在两个月内连续融资并达成20亿美元估值,简智机器人、觅蜂科技等初创企业也纷纷获得大额融资,成为该领域的独角兽。
数据从模型训练的辅助变量,跃升为独立的核心资产,这一转变仅用了一年时间。其背后折射出两个关键信号:一是视觉-语言-动作(VLA)大模型的泛化瓶颈日益显现,数据质量成为决定机器人智能水平的天花板;二是本体厂商的出货节奏超预期,导致数据需求从早期的研发探索阶段,迅速推升至量产必备的刚性阶段。
四大采集路线:成本、质量与规模的博弈
具身智能数据的生产逻辑与互联网文本数据截然不同。机器人需要学习的是“感知-决策-执行”的完整闭环,即“看到什么、做什么、力度多大、关节如何运动”。这种多维度的动作数据在互联网上几乎不存在,必须通过人工或模拟手段“制造”出来。目前行业主要存在四条数据采集路线,各自在成本、保真度和规模化潜力上各有优劣。
真机遥操采集被视为质量最高的方案。通过VR/AR头显,操作员将第一人称视角同步至机器人,直接控制其每一个动作。智元、优必选等头部厂商及部分初创公司如灵御智能均采取此路线。该数据可直接用于VLA模型训练,保真度极高。然而,其成本高昂且效率低下。特斯拉Optimus采集员的时薪高达25-48美元,且操作员需长时间佩戴VR设备,易产生眩晕感,加之空间判断误差,导致废片率居高不下,数据利用率通常在60%-70%之间。此外,为降低门槛设计的“人臂同构”方案,往往牺牲了机器人超越人类的性能,限制了其在狭缝钻探等特殊场景的应用。
无本体采集旨在通过可穿戴设备或动作捕捉技术,记录人类动作并映射到目标机器人本体,成本约为真机采集的一半。觅蜂科技和简智机器人是这一路线的代表。其中,通用操纵接口(UMI)允许操作员佩戴特制夹爪直接操作物体,同步记录轨迹与视觉数据;动作捕捉则通过全身设备记录运动,生成仿真或驱动数据。尽管成本较低,该路线存在两大局限:一是缺乏触觉反馈,难以捕捉拧瓶盖、插USB等需要精细力度控制的动作细节;二是从人动作到机械臂动作的“翻译”过程中,信息损耗严重,导致模型在实际操作中容易“使错劲”。
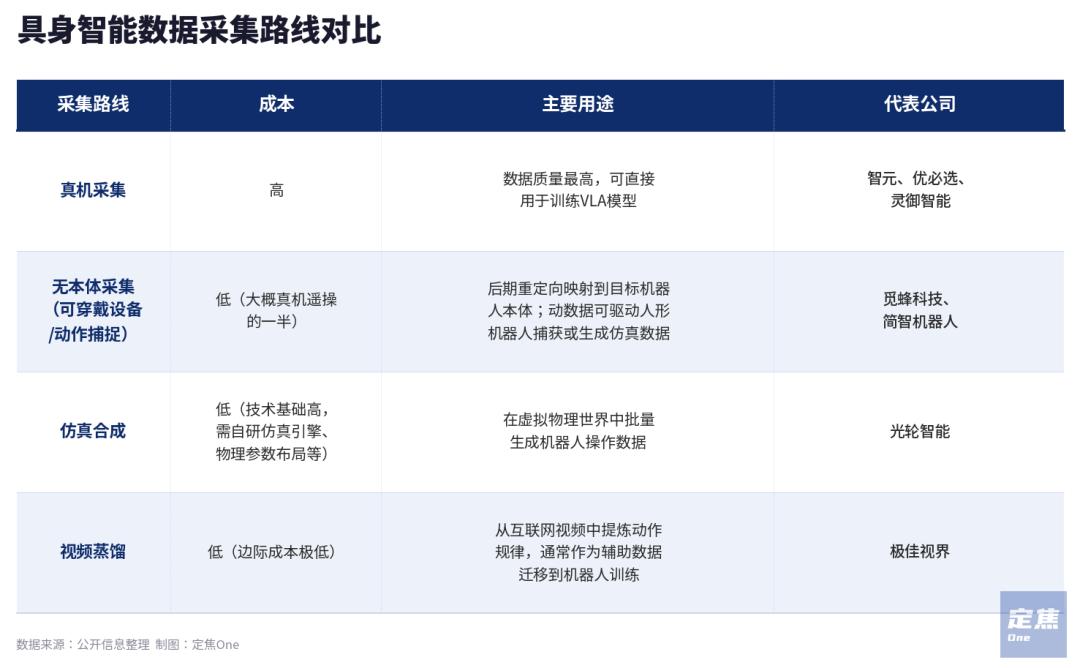
仿真合成数据通过构建虚拟物理世界,批量生成机器人操作数据。光轮智能凭借自研的仿真系统,累计交付超100万小时人类行为数据,是该领域的领军者。仿真数据的优势在于边际成本极低,可无限复制。但其短板在于“辛烷差距”(Sim-to-Real Gap):虚拟环境中物体的物理属性(如重量、摩擦力)往往是固定值,难以模拟真实世界中水杯含水、手部湿润等细微变化,导致仿真数据训练的模型在面对真实场景时容易失败。
视频蒸馏是近期兴起的技术路线。通过提取互联网上庞大的第一人称或第三人称操作视频,利用世界模型反推动作、轨迹及关节信息,生成结构化数据。极佳视界是该路线的典型代表,其凭借极低的边际成本和巨大的数据吞吐量迅速获得资本青睐。视频蒸馏的优势在于数据源无限、成本低廉,但其缺陷在于缺乏关节角度、发力大小等底层动作细节,且人手与机械臂的结构差异导致数据无法直接用于端到端训练,目前主要作为辅助数据源。
商业困局:高估值下的冷现实
尽管技术路线纷繁复杂,但数据商业化的现实却远比想象骨感。据行业调研,国内具备持续采购能力的客户寥寥无几,主要集中在头部机器人本体厂商、具身模型团队及科研机构。考虑到多数客户仍处于验证阶段,真正具备规模化采购能力的可能仅有几十家。
更严峻的是客户付费意愿的不稳定性。许多本体厂商采购外部数据仅是因为内部采集能力不足,一旦其自建数据采集体系跑通,外部采购需求便可能大幅萎缩。面对这一风险,数据厂商不得不通过提供专属采集工具、场景工艺及持续迭代方案来绑定客户,试图构建护城河。
目前的变现模式主要有三种,但均面临挑战:一是一次性买断数据集,这是最主流但也最卷的模式。由于硬件门槛低,小团队可轻易搭建采集工位,导致数据质量参差不齐,壁垒极低。二是售卖硬件,如可穿戴设备或遥操工作站,虽有一定硬件壁垒,但客户购买后可自行组织采集,长期价值存疑。三是售卖平台与订阅服务,这是壁垒最高、想象空间最大的模式,但前提是市场形成规模化数据消耗习惯,目前仅处于早期试探阶段。
一家头部数据厂商透露,其收入主要依赖标准化数据集和定制项目,毛利率不高,人力成本占比极高。在资本视角下,具身数据公司的估值逻辑并非传统的PE或PS,而是基于“单客户价值×潜在客户数×数据壁垒系数”。这种逻辑推动了估值的短期暴涨,却也埋下了泡沫隐患。
标准之争与行业洗牌
当前,行业对“何为高价值数据”尚未达成共识。是仿真还是真机?是第一视角还是第三视角?缺乏统一标准导致数据格式碎片化,模型被锁定在单一本体上,跨品牌迁移成本极高。尽管海外的Skild AI和蚂蚁灵波等公司推出了号称可适配多种机器人的跨本体模型,但在实际落地中,仍需针对具体机型进行微调,技术门槛依然高耸。
在此背景下,光轮智能、觅蜂科技、简智机器人等头部企业纷纷尝试“定规则”。光轮推出工业级评测平台,觅蜂探索跨本体数据格式,简智聚焦工业级数据规范。然而,标准制定本质上是利益分配。若由本体厂商主导,竞争对手难以接受;若由第三方主导,本体厂商则担忧沦为“收费站”。
与自动驾驶不同,具身智能面对的场景极度分散,从工厂到家庭,数据分布差异巨大,稀缺性更为持久。此外,自动驾驶的数据飞轮由车企出货量驱动,而机器人本体出货量尚不足,这意味着独立数据公司的窗口期更长,但商业化节奏也更慢。
行业泡沫的信号已逐渐清晰:三重错位现象显现——行业高喊数据核心,但客户压低预算;玩家扎堆同质化仿真数据,陷入低价内卷;资本疯狂追捧,但复购率低,多数团队依赖融资生存。未来一年,具身智能数据行业将经历从“拼融资”到“拼客户”的关键切换。唯有那些真正掌握数据生产核心技术、具备规模化交付能力并绑定长期客户的公司,才能穿越泡沫,成为物理AI时代的基础设施提供者。