端侧AI破局:高通收购12人团队背后的NPU First战略与产业真相
在人工智能的下半场竞赛中,算力分布的重心正经历一场静默却深刻的转移。过去几年,行业焦点几乎完全集中在云端大模型的参数规模竞赛上,然而,当模型规模逼近物理极限,且数据隐私、网络延迟、传输成本等问题日益凸显时,端侧AI(On-Device AI)的价值被重新审视。近期,高通正式收购了硅谷初创公司Nexa AI,这一事件不仅是资本层面的动作,更折射出芯片巨头对端侧AI落地路径的重新定义。这家仅12人的团队,如何在三年内将端侧AI技术植入全球领先的骁龙芯片平台?其背后的技术逻辑与商业考量,为整个行业提供了极具参考价值的样本。
从“通用适配”到“NPU First”的技术范式转移
许多开发者曾抱有天真幻想,认为将云端大模型迁移至终端设备,类似于下载一个应用程序般简单。然而,现实远比这复杂。手机、PC及各类智能硬件的芯片架构各异,即便同一模型,更换设备也需重新适配。在云端,CUDA等成熟框架已解决大部分底层异构计算问题,但在终端设备,尤其是专为AI设计的神经处理单元(NPU)上,软件生态依然是一片荒芜。新模型发布后,往往需要数周甚至数月才能完成适配,这种滞后严重阻碍了端侧AI的快速迭代。
Nexa AI的联合创始人Alex Chen指出,端侧AI的核心痛点在于软件与硬件的解耦。高通虽然早在2024年就将端侧AI定为核心战略,但其软件栈相较于英伟达的CUDA生态仍有差距。Nexa AI的切入点并非泛泛而谈,而是提出了“NPU First”的战略主张。NPU作为专为神经网络运算设计的单元,去除了通用计算的冗余,专注于整数等推理常用数据类型,因此在能效比上具有显著优势。然而,这也导致其软件支持滞后。Nexa AI通过深入理解NPU硬件特性,从软件层面实现了“硬件感知设计”(Hardware-aware Software Design),这在速度和模型质量之间取得了罕见的平衡。
这种技术路径的选择,使得Nexa AI能够在高通内部迅速获得关注。当其他团队还在摸索通用适配方案时,Nexa AI已能将NPU推理作为产品重点。这种对特定硬件架构的深度优化,构成了其最初的技术护城河,也为其后续与高通的深度绑定奠定了基石。
Day-0支持:重新定义模型部署的行业标准
在芯片行业的竞争格局中,对新模型的支持速度是一项隐形但至关重要的指标。传统模式下,一款新模型从发布到在特定芯片上稳定运行,周期长达两三个月。对于手机和PC制造商(OEM)而言,这意味着他们在产品发布时,无法预装最新的AI功能,从而在市场竞争中处于劣势。
Nexa AI最令高通管理层印象深刻的能力,是实现了“Day-0 Support”。即在新模型发布的当天,其软件框架就能完成支持。这一能力的实现,得益于其高度自动化的模型导入流程和成熟的量化技术。对于开发者而言,这意味着零等待;对于芯片厂商高通而言,这意味着能向OEM客户展示更强的平台生命力。在消费电子市场,首发优势往往能直接转化为销量优势。高通收购Nexa AI,本质上是购买了一套能够持续为骁龙平台注入最新AI能力的“引擎”,从而巩固其在移动AI领域的领导地位。
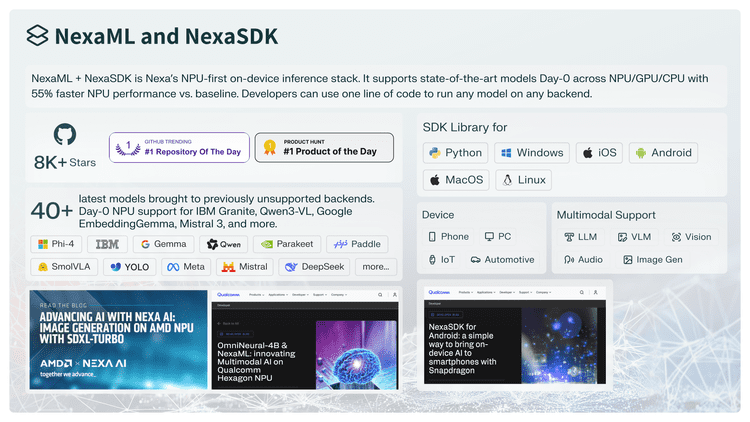
此外,Nexa SDK在开源社区的表现也印证了其技术实力。接近8000个GitHub Star、多次登顶Trending榜首以及Product Hunt第一名的成绩,使其在相对垂直的端侧AI社区建立了品牌认知。这种早期积累的开发者生态,是纯技术公司难以在短期内复制的资产。对于高通而言,收购Nexa AI不仅获得了代码,更获得了一个成熟的开发者社群,这将极大降低其后续推广端侧AI框架的成本。
端云协同:未来计算的理性回归
尽管端侧AI潜力巨大,但行业对“本地计算”的期待往往存在误区。Alex Chen通过具体案例澄清了端侧AI的真实定位。例如,在一个20B参数的本地模型充当AI Agent进行发票报销的场景中,虽然涉及敏感数据和本地操作权限,本地模型能完美胜任,但其生成速度远不及云端采用A100、H100等工业级GPU的方案。
这里的核心矛盾在于算力密度与延迟成本的权衡。本地设备的算力是固定的,且受限于散热和功耗,而云端拥有无限扩充的集群算力。因此,对于计算密集型任务,云端依然占据绝对优势。端侧AI的真正价值,在于那些对实时性要求极高、但计算量相对有限的任务,如视频会议中的背景虚化、实时翻译,或涉及隐私数据的本地信息提取。
未来更合理的架构并非“去云端化”,而是“端云协同”。简单、高频、隐私敏感的任务下沉至端侧,以毫秒级延迟处理;复杂、长尾、需深度推理的任务上传至云端。这种混合架构既能利用端侧的即时响应和隐私保护优势,又能借助云端的强大算力突破本地性能瓶颈。Nexa AI被收购后更名为GenieX,其愿景从“Any Model, Any Backend”聚焦为“Optimized for Qualcomm”,正是为了在单一生态内深耕,实现端云协同中的“端”侧极致优化。
商业逻辑:软件依附于硬件的终极归宿
Nexa AI选择被收购而非独立上市,是基于对端侧AI商业模式的深刻洞察。与云端AI不同,端侧AI难以独立变现。开发者通常不愿意为在手机上运行一个模型支付额外费用,因为终端硬件本身已经包含了必要的计算单元。端侧AI软件的付费方,主要是芯片制造商和OEM厂商。
对于芯片巨头而言,优秀的端侧AI框架是卖出更多芯片的催化剂。如果骁龙芯片能最顺畅地运行最新的大模型,手机厂商就更倾向于采用骁龙方案。因此,端侧AI软件的终极价值,是服务于芯片的销售。独立存在的端侧AI软件公司,面临着难以规模化(Scale)和变现路径狭窄的困境。相反,融入头部芯片平台,通过提升芯片平台的整体竞争力来获得价值回报,是更现实的商业路径。
这一逻辑解释了为何包括Qualcomm Ventures在内的投资机构迅速介入。他们看中的不是Nexa AI作为一家独立SaaS公司的未来,而是其技术如何转化为高通芯片的市场竞争力。团队全部并入高通后,创始人得以从繁琐的市场推广中解脱,专注于产品和技术迭代。这种“大平台+精干团队”的模式,避免了创业公司在资源分散中的内耗,能够更专注地解决技术深水区的问题。
展望:被收购后的生态重构与挑战
并入高通后,GenieX面临着新的机遇与挑战。最大的变化在于支持范围的收窄,从跨平台转向专攻高通芯片。这看似是退步,实则是聚焦。在竞争激烈的端侧AI赛道,多平台支持往往意味着在每个平台上都只能做到“够用”,而单平台深耕则能追求“极致”。通过统一硬件后端,GenieX可以更高效地利用高通的新指令集和NPU架构,推出更具竞争力的特性。
未来12个月,GenieX的核心目标是覆盖绝大多数Qualcomm芯片开发者,并将其融入开发者的工作流。这意味着高通需要构建更完善的文档、更便捷的调试工具以及更活跃的社区支持。对于开发者而言,这意味着更低的迁移成本和更高的运行效率。然而,挑战依然存在:如何确保在快速迭代的芯片架构中保持软件栈的稳定性?如何应对不同OEM厂商对底层定制的差异化需求?
从Nexa AI的故事中,我们可以窥见端侧AI行业的一个趋势:技术落地不再仅仅依赖于算法创新,更依赖于对底层硬件的极致优化以及与平台生态的深度融合。随着终端算力的持续提升和模型效率的不断优化,端侧AI将从“可用”走向“好用”,并在隐私保护、实时交互等场景中发挥不可替代的作用。对于整个行业而言,高通收购Nexa AI不仅是一次商业并购,更是端侧AI从边缘走向中心、从实验走向量产的重要里程碑。它标志着端侧AI的竞争已从单纯的模型大小比拼,转向了软硬协同效率与生态构建能力的综合较量。