打破同步瓶颈:清华单Rollout异步优化如何重塑强化学习训练效率与稳定性
突破同步桎梏:大模型强化学习的新范式探索
在大型语言模型(LLM)向智能体(Agent)演进的过程中,强化学习(RL)被视为提升逻辑推理、代码生成及复杂任务规划能力的核心驱动力。然而,当前主流的RL训练流水线普遍存在一个系统性痛点:同步等待。
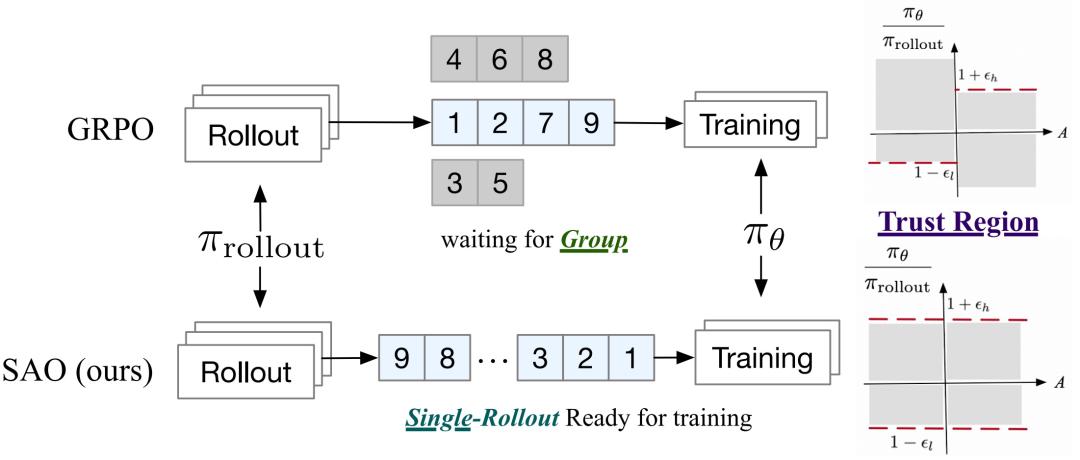
传统的基于组采样(Group Sampling)的方法,如GRPO(Group Relative Policy Optimization),通常需要收集整批rollout数据后才能进行参数更新。这种同步机制不仅导致计算资源在等待期间闲置,限制了系统的吞吐量,还因组式采样的特性使得模型难以灵活适应异步或动态的训练环境。虽然现有的异步RL方法在一定程度上缓解了系统吞吐问题,但往往以牺牲训练稳定性为代价,且难以直接兼容GRPO依赖的组式对比机制。
面对这一行业共性难题,清华大学KEG实验室提出了一种名为“单Rollout异步优化”(Single-rollout Asynchronous Optimization, SAO)的全新框架。该方法的核心突破在于摒弃了传统的批量同步策略,转而采用单条轨迹即时更新的异步机制。这一转变不仅降低了离策略分布的影响,更在长程Agent任务和代码生成场景中,实现了训练效率与模型泛化能力的双重提升。
SAO核心机制解析:从采样到更新的精细化重构
SAO之所以能够稳定支持长达1000步以上的异步训练,关键在于其对强化学习流程中多个关键环节进行了精细化的重构。这并非简单的并行化改造,而是从统计学习理论层面解决了异步环境下的偏差与方差问题。
直接双边重要性采样(DIS)
在异步训练中,生成器(Generator)与优化器(Optimizer)往往处于不同的时间步,这导致了严重的离策略偏差(Off-policy Bias)。SAO引入的直接双边重要性采样机制,通过利用rollout阶段记录的token对数概率直接计算重要性采样比,避免了保存大量历史模型快照带来的存储与计算开销。
更为关键的是,DIS机制设定了一个严格的阈值区间。只有当采样比处于该区间内的token才会被纳入梯度更新计算,超出区间的噪声数据则被直接过滤。这种“软截断”策略有效地抑制了极端异常值对模型参数的破坏性更新,从而在异步流中保持了策略更新的平滑性。
价值模型的解耦与强化
单Rollout训练面临的最大挑战之一是梯度估计方差的高企。由于缺乏组内对比,优势函数(Advantage)的估计精度大幅下降。SAO通过解耦策略模型与价值模型(Critic Model)的更新频率来应对这一挑战。具体而言,每进行一次策略更新,SAO会执行两次价值模型更新。这种高频的价值校正确保了优势信号估计的实时性与准确性,从而显著降低了单步优化的方差。
固定注意力模块以稳定价值估计
进一步的研究发现,价值模型训练过程中的波动主要源于全注意力机制(Full Attention Layers)的参数更新。相比之下,混合专家层(MoE)的参数更新相对稳定。鉴于此,SAO在训练价值模型时采取了冻结注意力模块参数、仅优化MoE投影层的策略。这一设计巧妙地隔离了价值估计中的不稳定因素,使得价值模型能够更专注于拟合回报分布,而非陷入局部震荡。
多轮轨迹中的噪声抑制
在Agent的多轮交互中,动作与环境的观察信息交替出现。如果直接将环境反馈的观察信息token纳入优势计算,会引入巨大的环境噪声。SAO采用了一种基于序列分割的策略,跳过环境观察信息的token级广义优势估计(GAE),仅在模型生成的动作序列之间传播优势信号。这种设计确保了梯度更新仅反映模型自身策略改进的效果,而非环境随机性的干扰。
实证评估:在复杂基准上的性能跃升
为了验证SAO的有效性,研究团队在数学推理、代码修复及模拟在线学习等多个维度进行了广泛的基准测试。实验结果不仅展示了SAO在绝对性能上的优势,更揭示了其在训练动态过程中的稳定性。
数学推理与代码任务的性能碾压
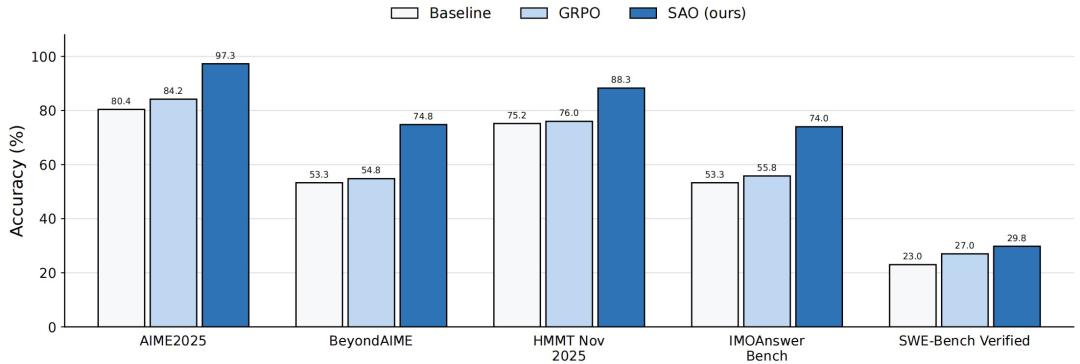
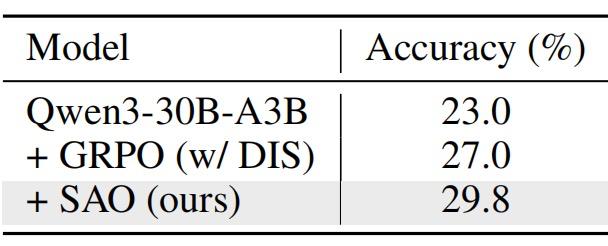
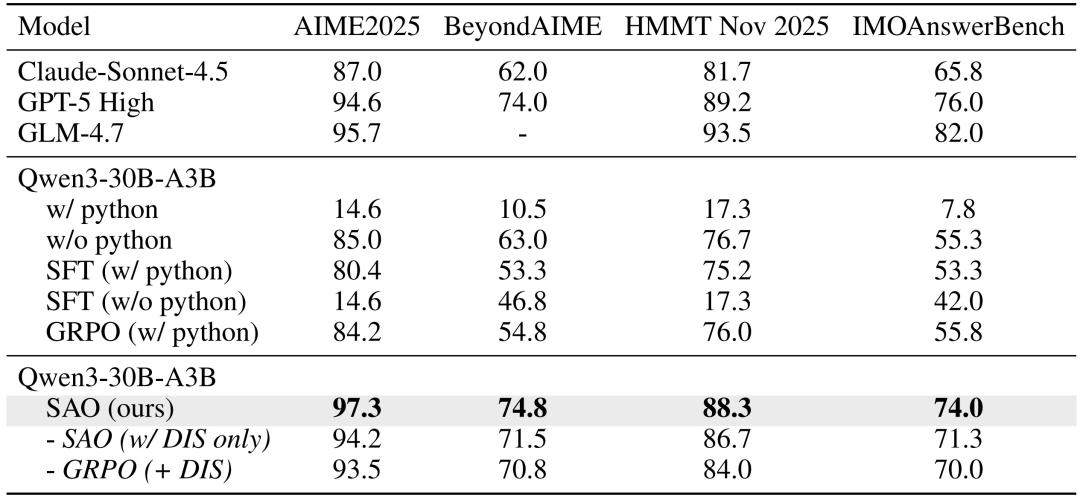
在AIME 2025这一高难度数学推理基准上,SAO取得了97.3%的准确率,相较于GRPO的84.2%实现了显著超越。这一差距在复杂逻辑链条的推理任务中被进一步放大。此外,在SWE-Bench Verified代码修复基准中,SAO达到了29.8%的准确率,明显高于基线模型的23.0%以及引入DIS后的GRPO变体(27.0%)。
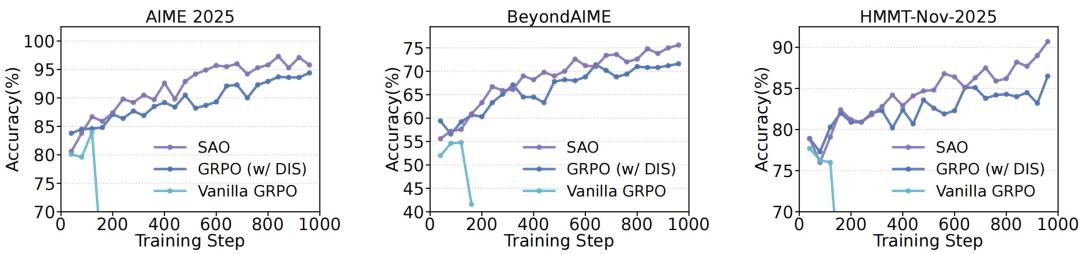
这表明,单Rollout异步优化不仅能提升训练效率,还能通过更精准的梯度方向搜索,帮助模型收敛到更优的策略分布。在真实世界的代码修复场景中,这种精度提升意味着更强的自动化错误修复能力。
训练稳定性的纵向对比
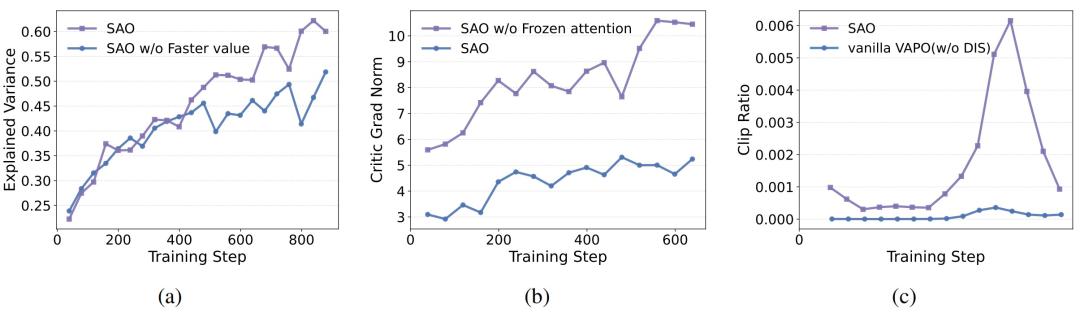
通过对比训练曲线可以发现,普通GRPO在训练初期容易因探索过度而导致性能崩溃。引入DIS后,GRPO虽然能稳定下来,但其性能提升曲线往往在中后期趋于平缓。相比之下,SAO在整个训练过程中始终保持领先,且在训练的中后期仍能观察到评估指标的持续上升。
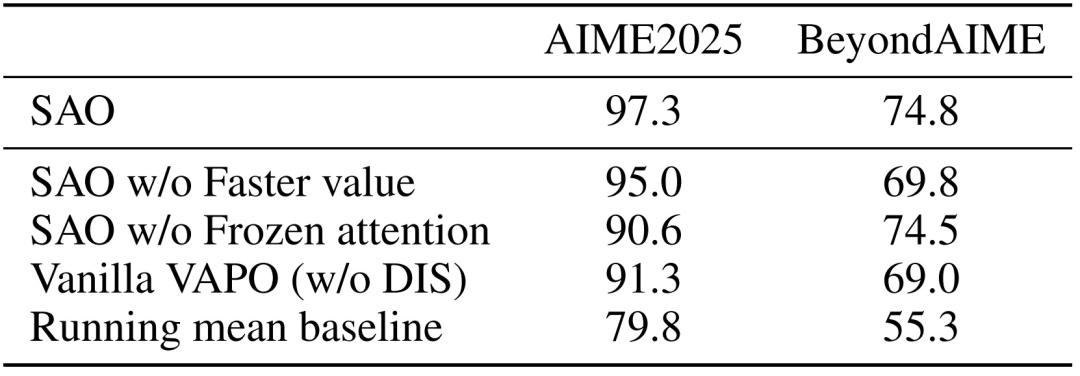
这种稳定性来源于SAO对离策略偏差的严格控制。消融实验显示,若移除更快的价值模型更新机制,SAO在BeyondAIME基准上的准确率会从74.8%降至69.8%;若采用全参数价值模型训练而不固定注意力层,训练过程也会出现明显的波动。这些结果有力证明了SAO各组件的必要性与协同效应。
动态环境下的自适应能力
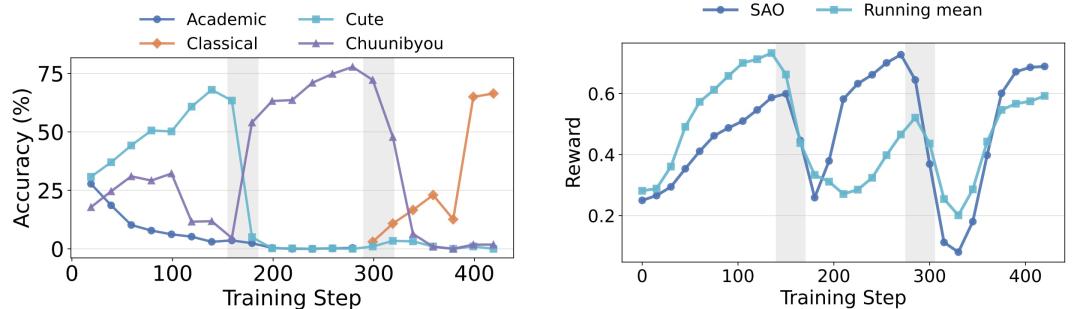
SAO的另一个亮点体现在对非平稳环境的适应能力。在模拟在线写作任务中,研究团队设置了奖励偏好的动态切换(如从可爱风格切换至古典风格)。结果显示,SAO能够在偏好切换后迅速对齐新的目标风格,并在训练奖励上保持高位。
相比之下,基于滑动平均的基线方法存在明显的适应滞后,且最终的收敛水平较低。这一特性对于需要实时响应用户偏好变化的Agent应用至关重要,证明了SAO在在线学习场景下的潜在价值。
局限性与未来演进方向
尽管SAO在多项指标上表现优异,但其实际应用仍面临基础设施与适用范围的限制。首先,当前实验主要集中在Qwen3-30B-A3B规模的模型上,SAO在小参数模型或奖励信号更密集的任务中是否依然有效,尚待进一步验证。
其次,SAO高度依赖对rollout对数概率的可靠保存。在大规模分布式部署中,如何在异步生成过程中低延迟、高可靠地传输和存储这些概率信息,是工程落地的一大挑战。此外,随着SAO被部署到GLM-5.2等大模型的生产环境中,如何构建针对异步在线学习的安全防护、监控机制及隐私审查框架,将是学术界与工业界共同关注的伦理与安全议题。
SAO的提出,为大模型强化学习提供了一种摆脱同步枷锁、追求高效稳定训练的新思路。随着基础设施的完善及算法的进一步迭代,异步单Rollout优化有望成为下一代智能体训练的标准配置。