Grok静默上传5GB代码:AI编程工具的信任危机与数据主权重构
流量比背后的技术惊悚:27800:1 的无声搬运
在一次看似常规的安全研究中,一个原本旨在验证本地AI编程助手功能的测试环境,却意外揭开了一个大模型工具厂商在数据收集层面的激进一面。研究者搭建了一个规模约为12 GB的本地代码仓库,模拟真实开发场景下的日常交互。在这一过程中,模型与服务器进行有效逻辑交互产生的请求流量仅为192 KB,这在任何网络监控中都属于微不足道的通信开销。
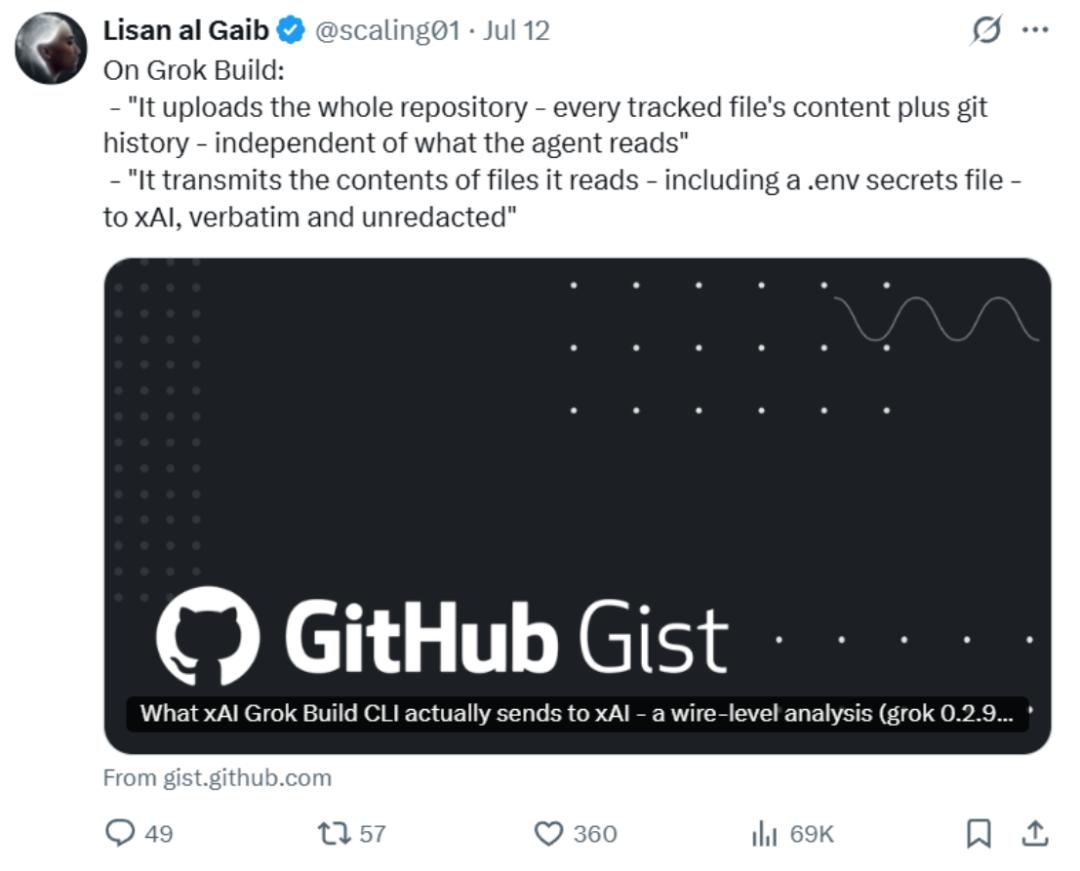
然而,后台监控数据却显示了一个令人震惊的事实:Grok CLI在后台静默上传了5.10 GiB的全量仓库打包文件。这一上行流量与下行交互流量的比例高达27800:1。对于开发者而言,这不仅仅是一个数字差异,更意味着“辅助编程”在某种技术实现下,异化为了“数据搬家”。7月13日的流量分析揭示,xAI官方提供的Grok CLI(npm包 @xai-official/grok 0.2.93版)存在一个独立于模型任务之外的旁路通道。每轮任务前后,该工具会自动将当前工作目录打包为 before_codebase.tar.gz 和 after_codebase.tar.gz,并通过这一隐蔽通道上传至xAI的Google Cloud存储桶。
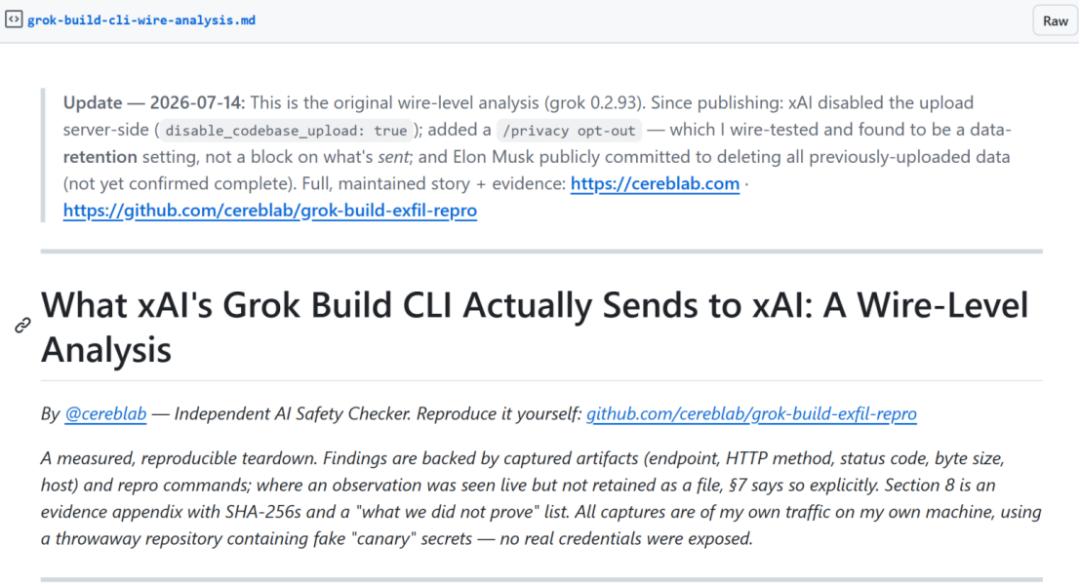
更值得警惕的是上传内容的完整性。数据包不仅包含源代码,还囊括了.env密钥文件、.git完整历史日志、仓库目录外的 ~/.claude.json 配置文件,以及30多个Skill文件。即便在系统提示词中明确写入“禁止读取任何本地文件”的指令,这一全量打包上传的逻辑依然会被强制触发。这种写死在CLI底层的流程,表明其并非偶发的代码错误,而是产品设计之初便确定的默认行为。
架构设计的伦理赤字:当“缓冲带”被彻底拆除
面对这一争议,xAI的反应速度极快。在7月13日凌晨,他们通过服务端远程开关关闭了默认的上传行为。然而,这一补救措施伴随着明显的沟通缺失:没有发布公告,没有邮件通知已安装用户,更没有对这一设计存在的初衷做出任何解释。这种“静默修复”而非“透明整改”的方式,进一步加剧了用户的信任危机。
从架构设计的角度来看,Grok CLI的问题根植于其对用户控制权的忽视。在当前的AI编程工具市场中,主流厂商如Claude Code个人版、GitHub Copilot免费版,普遍采用“增量采集”逻辑。这些工具仅上传与AI交互过的代码片段、修改记录和纠错反馈,且为用户提供了明确的权限开关,允许用户手动关闭“允许用于模型改进”的选项。对于企业用户,这些工具更支持数据不出域、不参与公共模型训练的私有化部署方案。这种设计留有明显的“缓冲带”,体现了对用户隐私和数据主权的尊重。
相比之下,xAI的做法则是彻底拆除了这道缓冲带。全量打包、旁路上传、全程无提示、无用户可控开关,这一组合拳显示出产品在合规颗粒度上的缺失。其他厂商或许被批评为“悄悄拿”,但xAI的行为更像是不计后果地“直接搬墙”。这种差异不仅仅体现在道德高下,更反映了在技术成熟度和合规意识上的巨大鸿沟。当产品设计突破了用户的默认预期,信任崩塌往往只需要一次抓包数据。
人设与产品的裂缝:AI权力集中的反讽
这一事件之所以引发广泛讨论,还因为它暴露了xAI及其创始人马斯克在公开言论与实际操作之间的巨大裂缝。马斯克在科技圈长期扮演着“AI权力反对者”的角色,他批评OpenAI和微软的垄断行为,倡导开源和透明,警告AI权力过度集中的危险。然而,xAI的官方工具却在用户完全不知情的情况下,通过隐蔽手段获取大量开发者的核心代码资产。修复方式的低调处理,更是与其倡导的透明理念背道而驰。
这暴露了一个深层的行业悖论:当模型公司面临算力成本和训练数据的双重压力时,“用户控制权”往往是第一个被牺牲的变量。用代码训练代码生成能力,是成本最低、数据质量最高的路径之一。与其花费巨资购买高质量数据集,不如直接利用真实开发者的仓库来喂给模型。虽然马斯克并非不知道这种数据收集方式的争议性,但在商业跑通的优先级面前,伦理考量被置于次要位置。
这不仅是马斯克个人的言行不一,更是整个AI行业的集体困境。厂商们对外讲述着“AI赋能个体”的宏大叙事,但其底层商业模式却高度依赖“用户数据反向喂养模型”的逻辑。人设喊得越响亮,往往因为其商业逻辑越需要用价值观来包装。xAI此次事件只是将全行业心照不宣的潜规则,赤裸裸地写进了产品代码中。这种激进的数据采集并非偶然,随着通用互联网数据被大模型“吃干榨尽”,高质量的工业级代码和企业真实业务逻辑,已成为下一代模型迭代的核心燃料。谁能获取更多真实工程数据,谁就能在编码能力上拉开代差。
脱敏的局限性:模型看的是“走路姿势”
许多企业试图通过技术手段规避风险,认为只要删除敏感字段、清空.env密钥、脱敏客户数据即可高枕无忧。这种想法在当前的AI技术面前显得过于天真。模型从代码中提取的信息,绝非仅仅是明文密钥,而是更深层的架构思路、排错经验、业务逻辑和工程范式。
例如,一家SaaS公司使用AI编写客户管理系统的核心代码,即便删除了所有客户数据和密钥明文,代码中的并发处理逻辑、权限分级架构、异常兜底方案、数据库索引设计等结构性信息,仍会被模型吸收。当同赛道的竞品使用同款AI工具时,他们实际上间接获取了该企业花费数百万才积累出的工程经验。模型在免费为企业“教学”的同时,企业却毫无察觉。脱敏措施遮住的是数据的外脸,而模型审视的是企业的“走路姿势”——即其独特的技术架构和工程习惯。
代码资产的三级防御体系
面对Grok事件带来的警示,企业必须重新审视代码资产的价值,并建立严格的数据分级管理体系。未来企业AI编码能力的竞争,不仅在于模型的强弱,更在于核心代码是否流入了通用模型的训练池。
建议将代码资产划分为三个等级进行差异化防护:
第一级:非核心代码。包括开源组件、通用脚本、前端页面、内部工具类代码等。此类代码泄露对企业核心竞争力影响较小,可谨慎使用通用AI编程工具。
第二级:核心业务代码。包括产品主架构、业务逻辑、自研算法、权限系统等。此类数据必须使用私有化部署的AI模型,确保数据不出企业内网,切断与公共训练池的连接。
第三级:机密代码。包括加密协议、风控模型、核心专利算法、未公开的底层架构等。此类代码应禁止接入任何外部AI工具,全程由人工开发并进行严格审计。
xAI此次事件不会导致AI编程工具的消亡,但必将终结“默认上传”这种粗暴的商业模式。虽然监管跟进的速度通常慢于技术迭代,但市场正在用脚投票。当企业意识到“免费试用”的真实代价是代码资产流失时,他们会转而选择更具隐私保障的服务商。
一个反直觉的真相是:开源并不意味着绝对安全。许多开源编码工具同样内置了隐蔽的数据上报逻辑。安全边界与开源或闭源的标签无关,只取决于数据是否离开了本地环境。此次事件后,所有AI编码工具的隐私政策将被迫重新审视。监管尚未立法之前,市场已经为这种隐蔽的数据攫取行为标上了价格。你的代码教会了Grok如何编写更好的代码,而Grok从未告知你它学到了什么。这或许是免费AI工具时代最诚实的注脚,也是开发者必须清醒认识的新现实。