耗时2小时生成3D世界?GPT-5.6如何用多智能体重构内容生产逻辑
在人工智能内容创作的版图中,3D场景生成一直被视为一座难以逾越的高山。过去,大语言模型(LLM)的竞技往往局限于文本续写或简单代码片段,但随着多模态技术的演进,生成可交互、具有物理规律且视觉高保真的3D网页成为检验模型智能程度的新标尺。近日,一系列被称为“地狱级”的3D提示词测试将各大模型推向了风口浪尖。在这场涉及63个高难度场景的实测中,OpenAI的GPT-5.6凭借Sol架构下的多智能体协作能力,展现出了与其他主流模型显著不同的技术路径与交付水准。
3D生成的“终极挑战”:从视觉奇观到物理法则
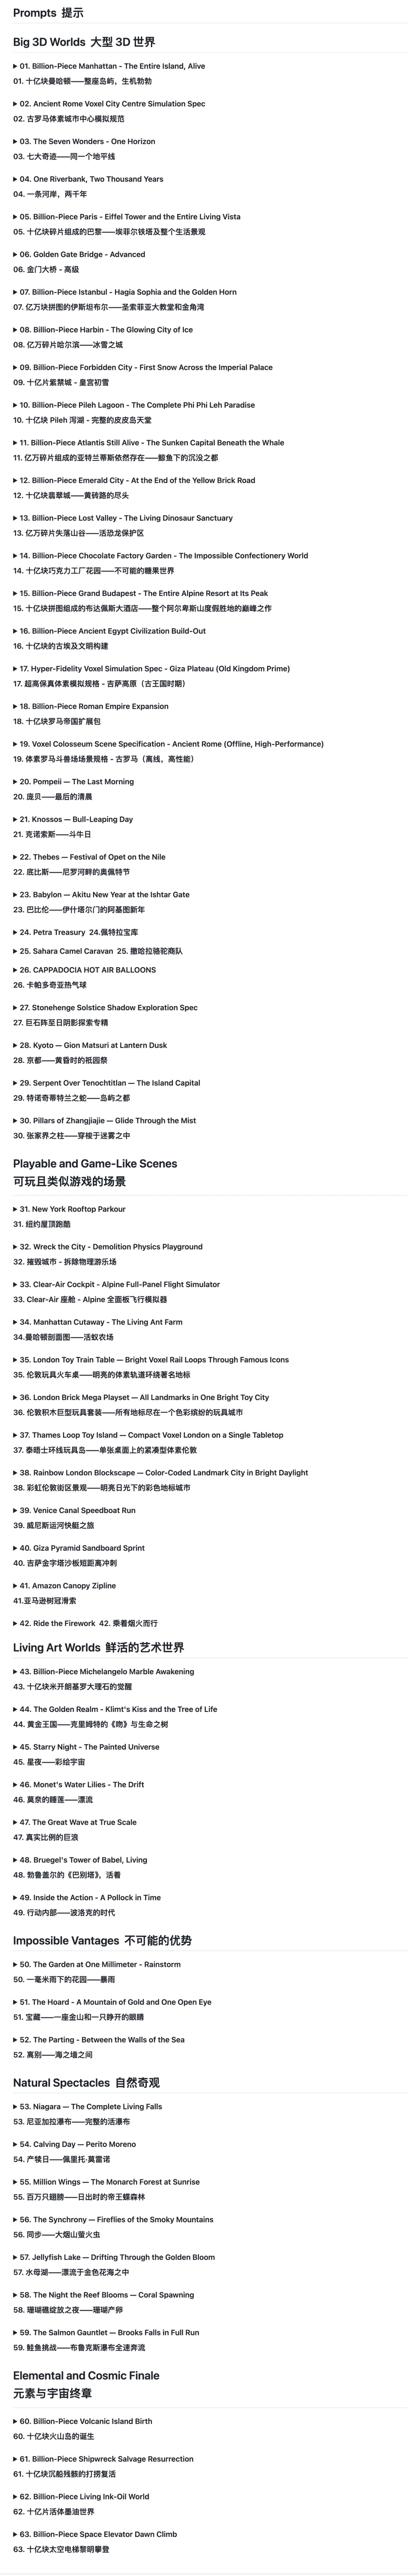
这次测试的核心并非简单的图像生成,而是要求模型通过代码(主要是Three.js)构建完整的3D世界。这些提示词涵盖了从宏观的城市景观到微观的粒子特效,从静态的光影渲染到动态的物理交互。例如,测试要求模型构建一个完整的曼哈顿场景,不仅要有整体视角的无缝缩放,还需包含车流、渡轮、屋顶水塔等细节,并在视角切换时保持逻辑连贯。
另一类极具挑战性的题目涉及自然奇观与艺术重构。比如,将梵高的《星月夜》转化为可进入的3D空间,不仅要还原颜料的厚度感,还要让画面中的旋涡产生动态流动效果;或者模拟尼亚加拉瀑布的水雾、彩虹与游船的动态交互。更有甚者,要求在海面上实时生成一座火山岛,岩浆、海浪、蒸汽、闪电等多重元素必须在第一秒起协同运转。
这些题目对AI提出了极高的要求:它不仅要理解自然界的物理规律(如重力、流体动力学、光照反弹),还要具备将抽象艺术概念转化为几何结构、动画序列和交互逻辑的能力。这不再仅仅是概率预测的游戏,而是对世界模型的深度模拟。
GPT-5.6 Sol:多智能体协作的工程化胜利
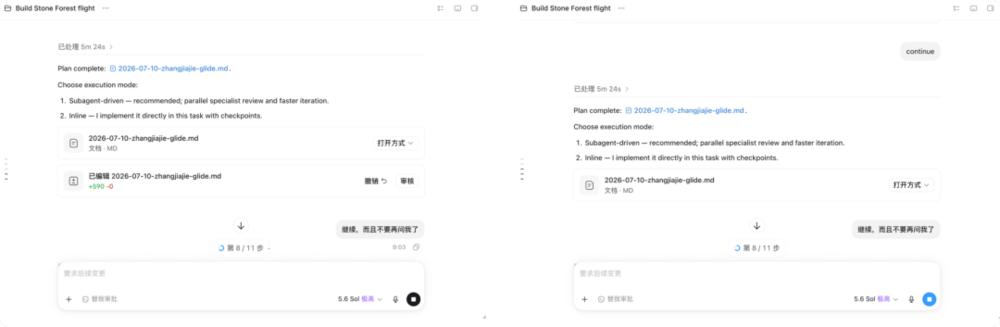
在本次实测中,GPT-5.6 Sol(尤其是开启Ultra模式)的表现令人瞩目。与以往单线程生成代码不同,Sol架构引入了深度的推理与多智能体并行处理机制。当用户提交一个复杂提示词时,系统并非直接输出代码,而是首先启动一个规划阶段。在Ultra模式下,默认会派出4个子智能体并行工作,最多可扩展至16个智能体同时处理任务。
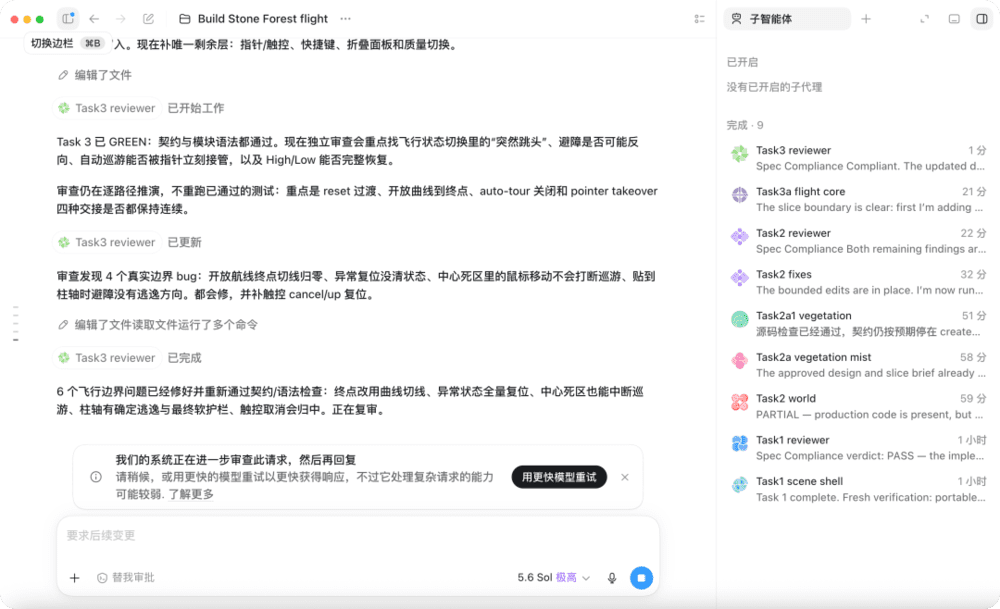
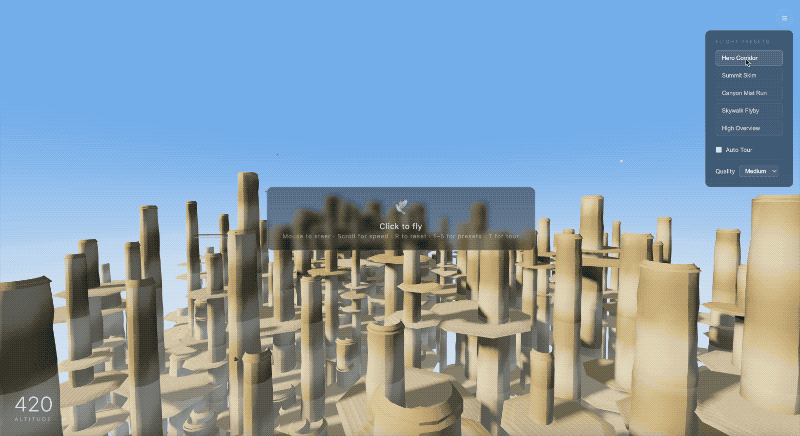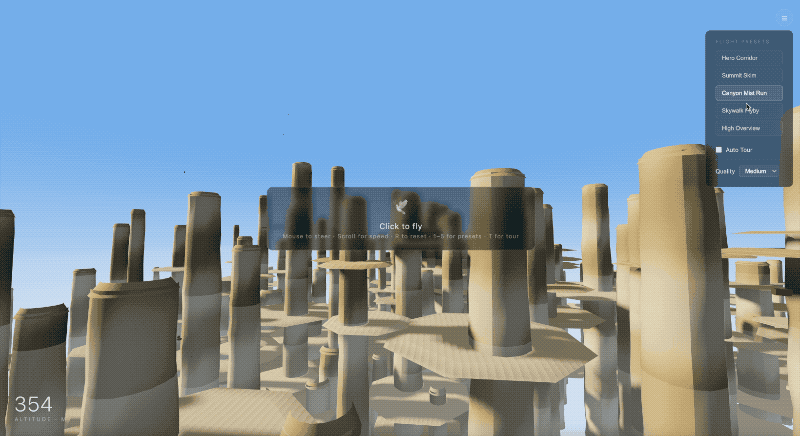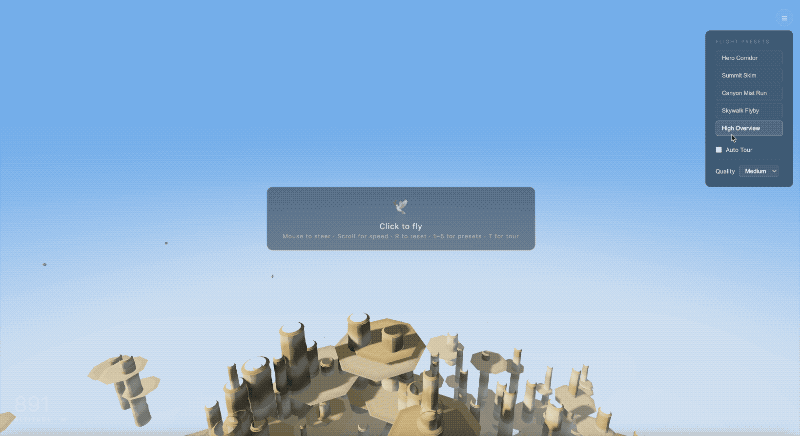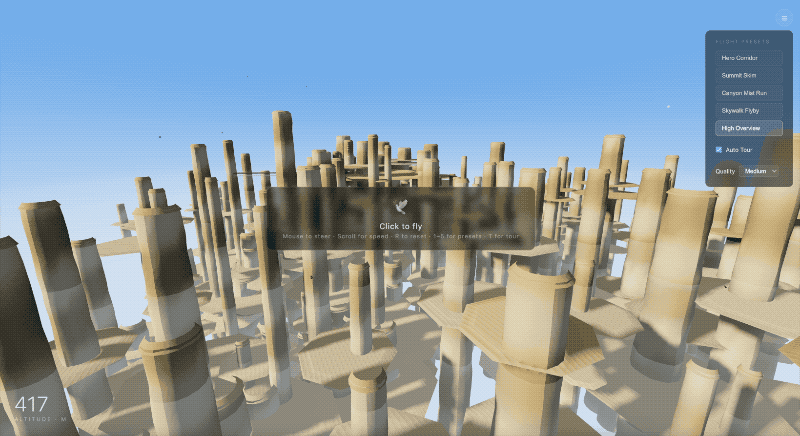
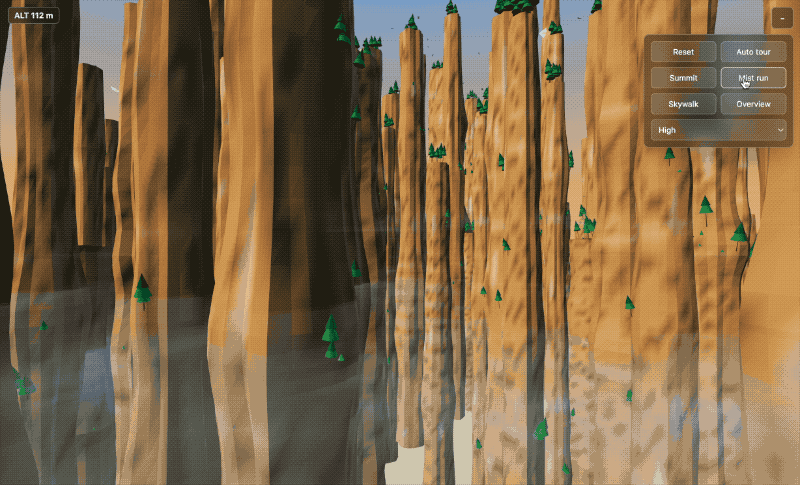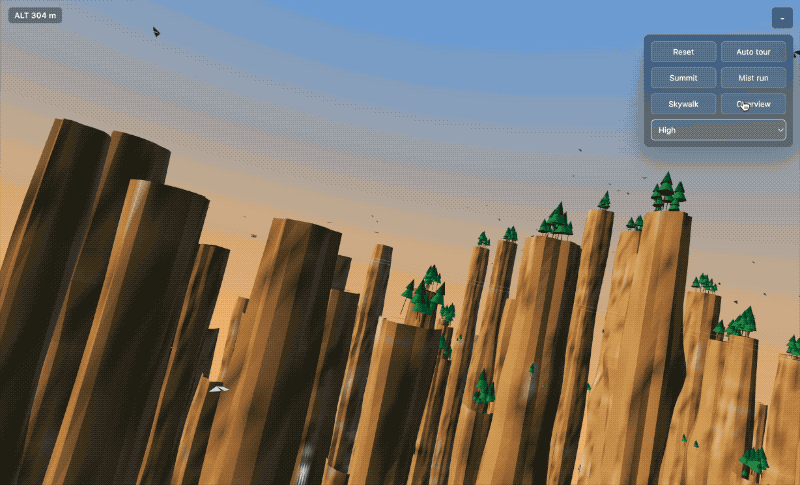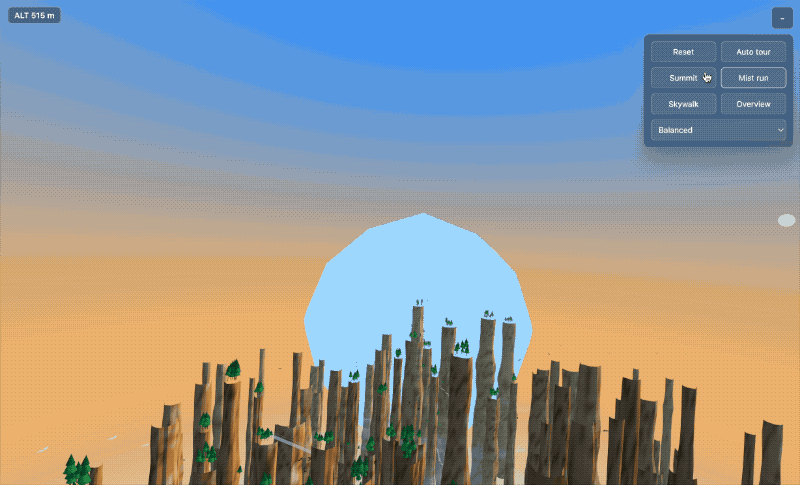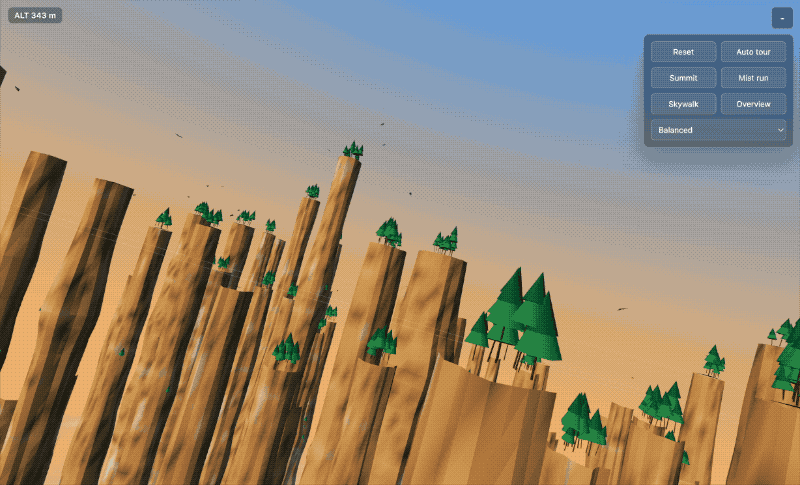
以“穿越张家界石林”这一测试为例,GPT-5.6 Sol Ultra模式耗时2小时41分35秒才完成交付。这段时间并非闲置,而是被细分为多个阶段:Task 1到Task N的场景构建、控制逻辑编写、Shell脚本生成等。每个子智能体负责不同的模块,并在完成后进行自我审查与修正。这种“先规划、再分工、后整合”的工作流,使得最终生成的代码结构严谨,细节丰富。
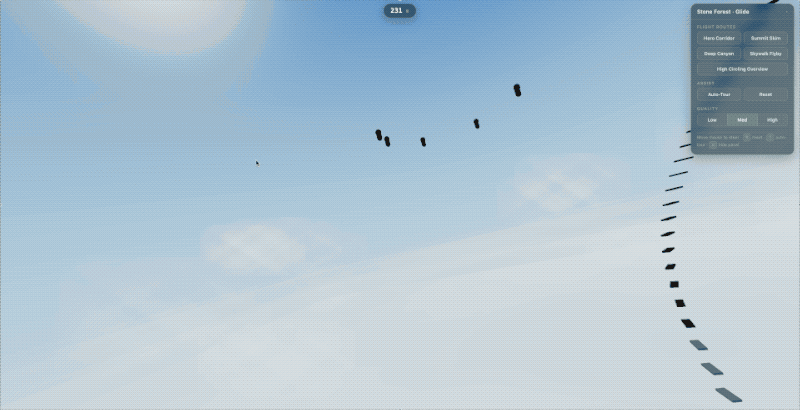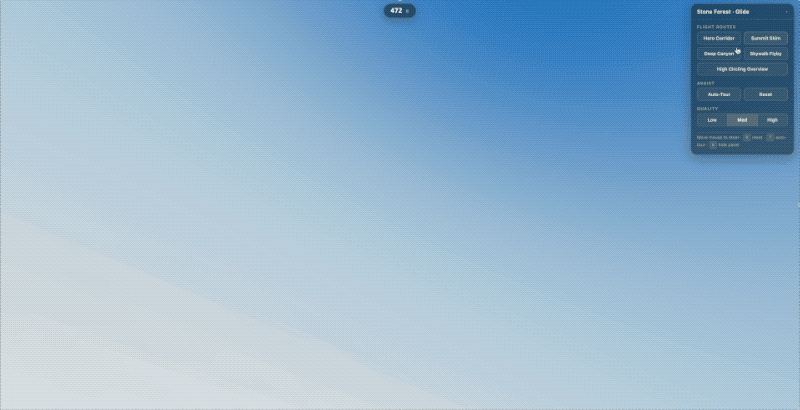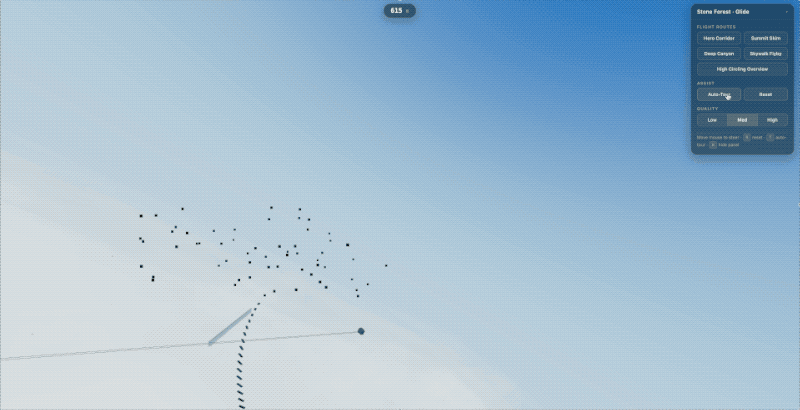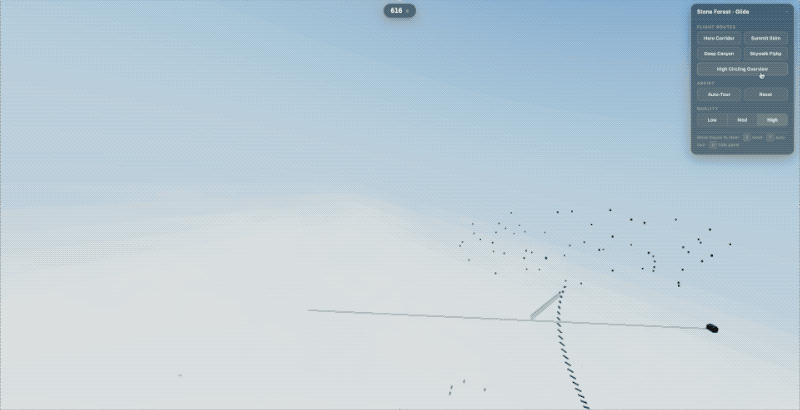
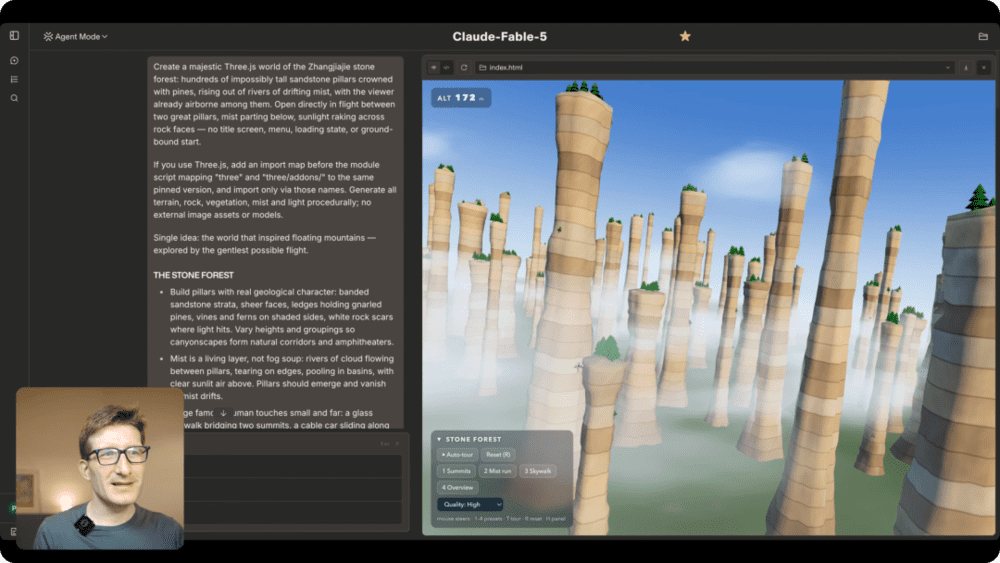
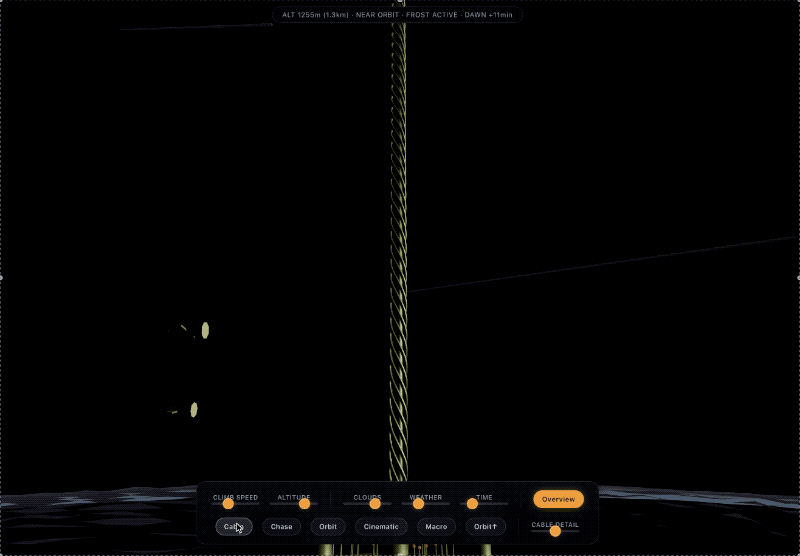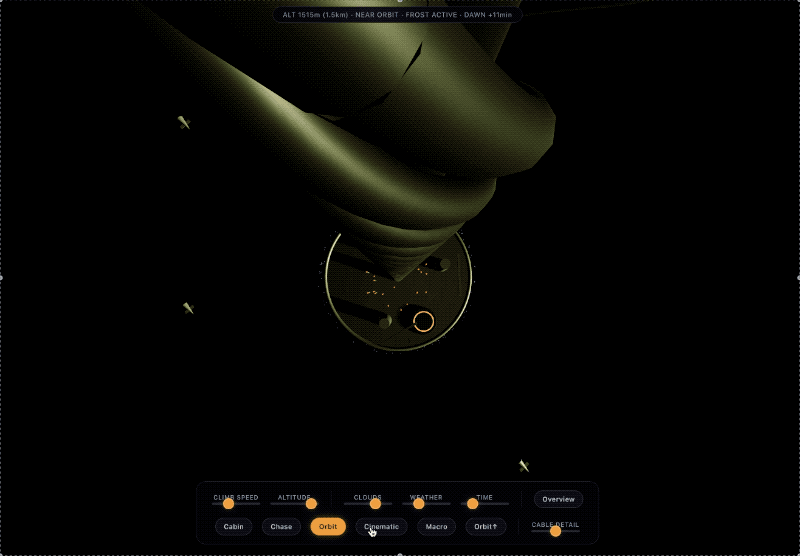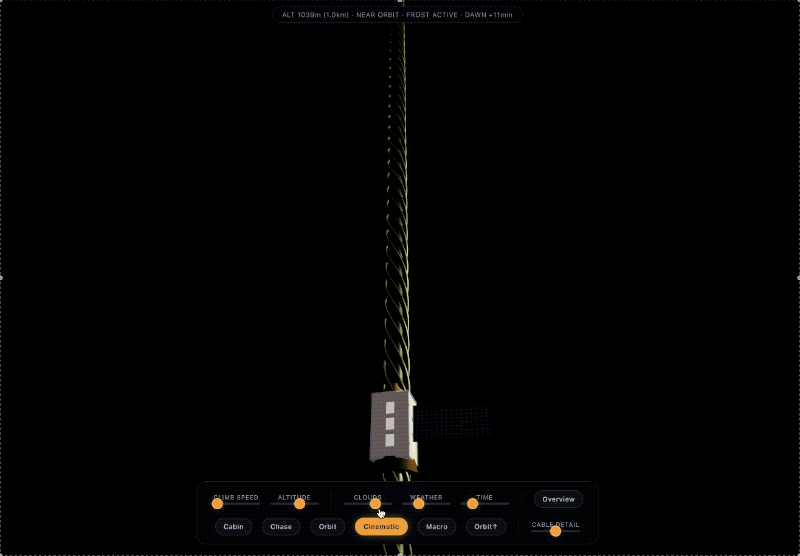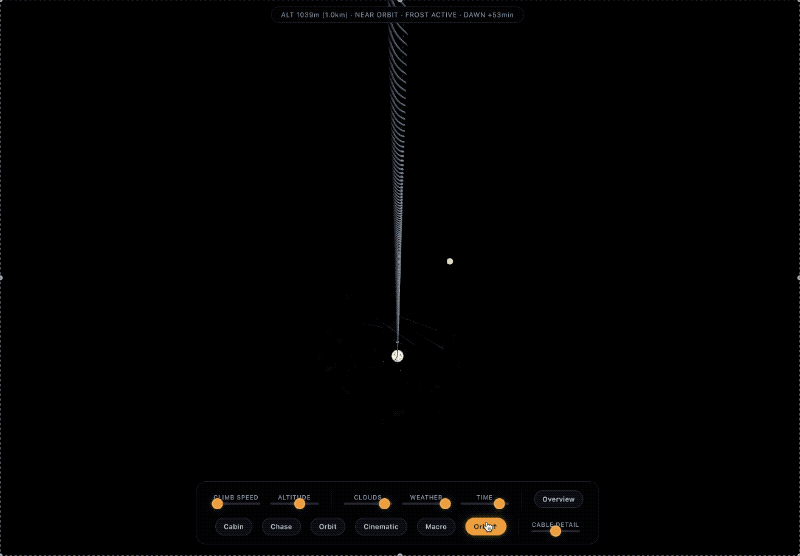
生成的张家界场景中,数百根砂岩石柱带有真实的地质层理,阳光照射下的阴影变化符合物理规律,飞鸟、瀑布、玻璃栈桥等元素并非简单的贴图,而是通过程序化几何生成的动态实体。与之相比,同属OpenAI家族的GPT-5.5即便调高渲染等级,其石柱与植被的细节仍显得单薄,缺乏那种“呼吸感”。

竞品对比:性能与细节的鸿沟
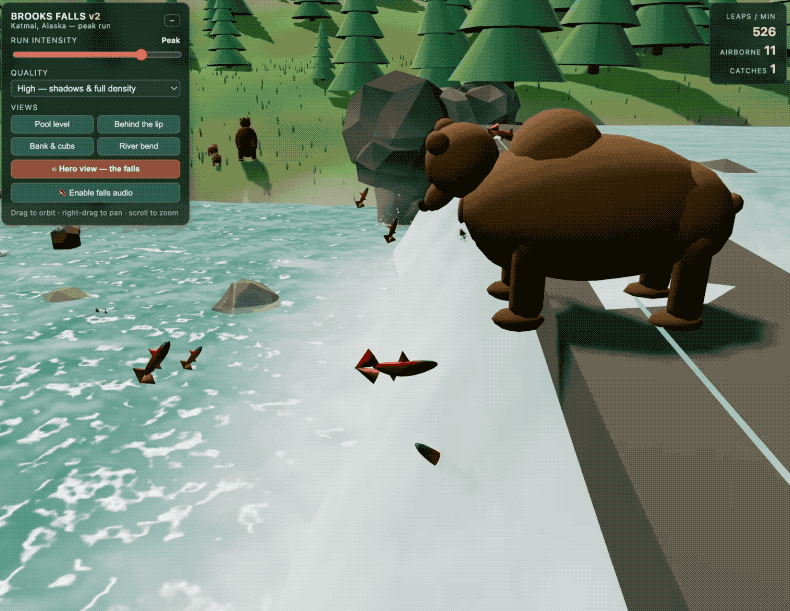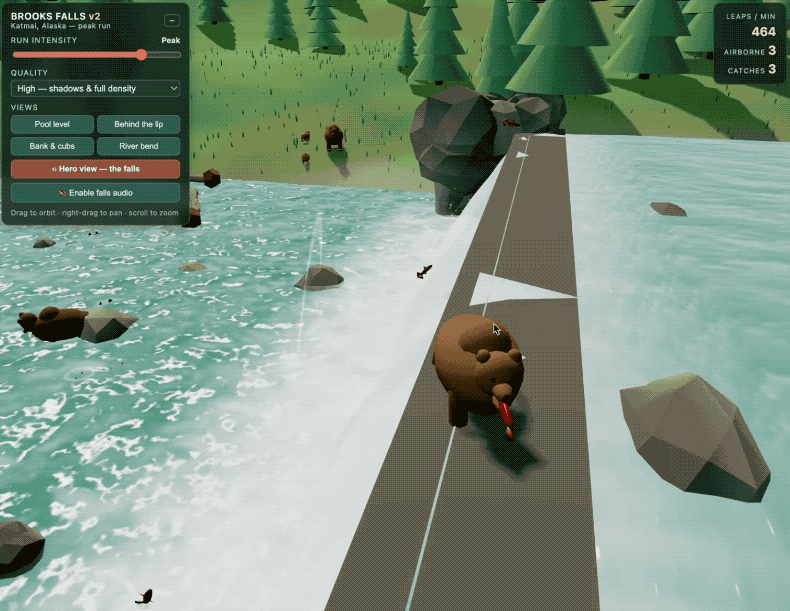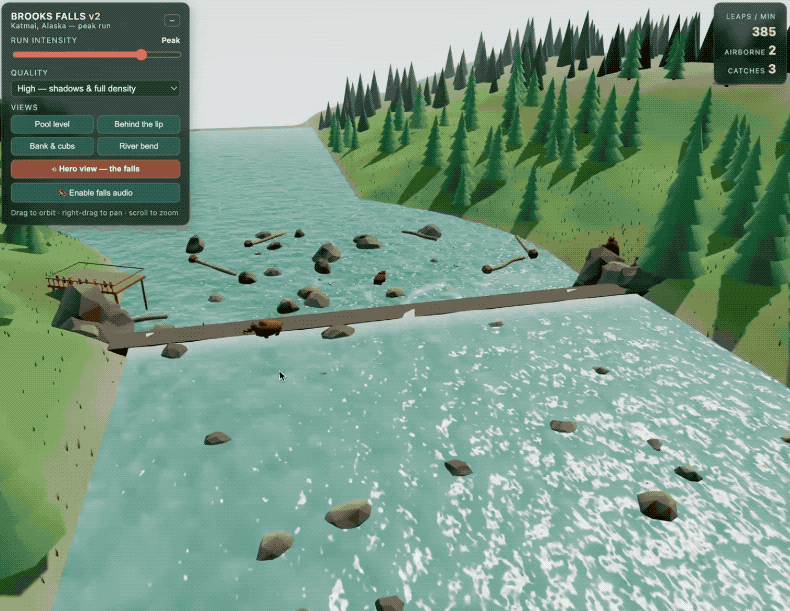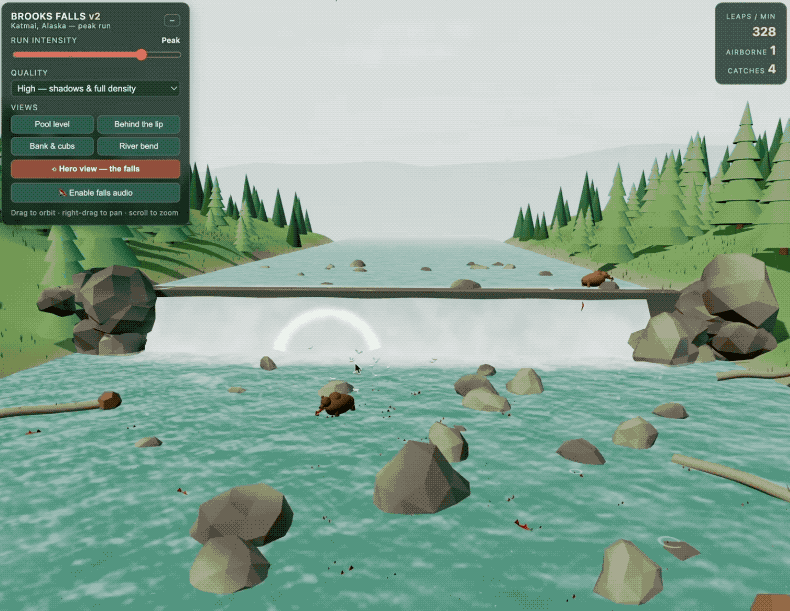
为了验证GPT-5.6的优势,测试团队将相同的提示词输入给了Gemini 3.5 Thinking、DeepSeek V4 Pro、GLM-5.2以及Hy3等主流模型。结果呈现出明显的梯队差异。
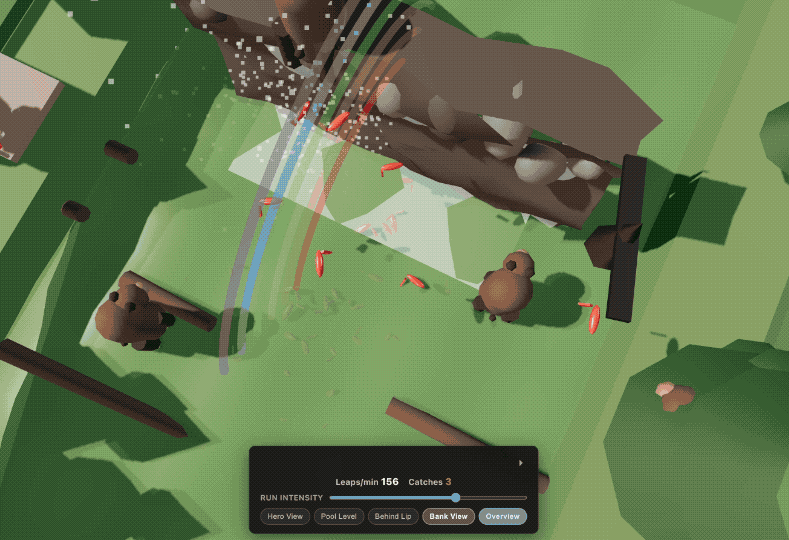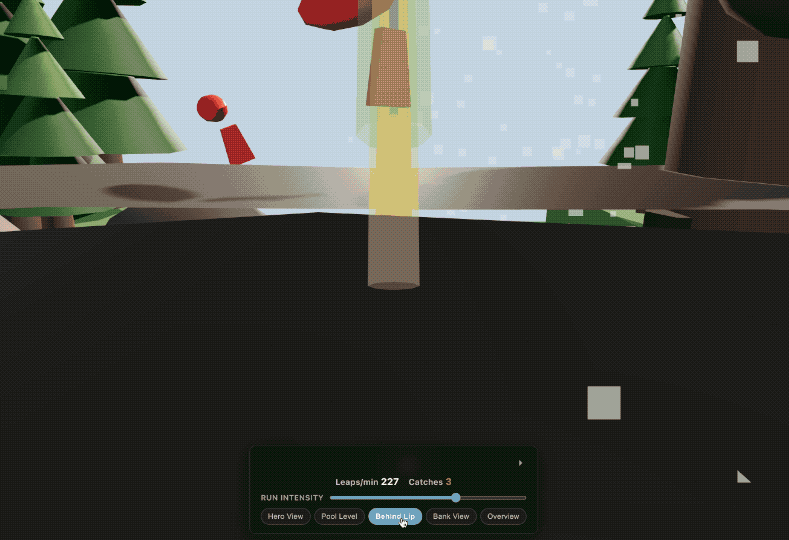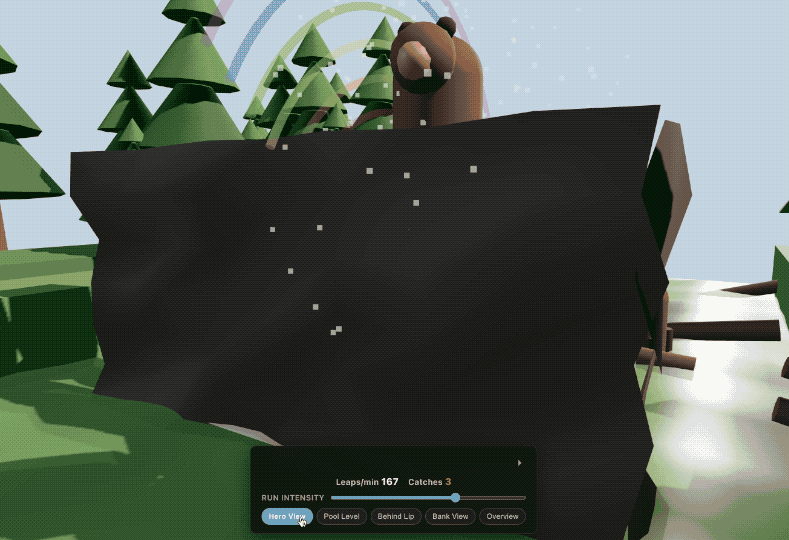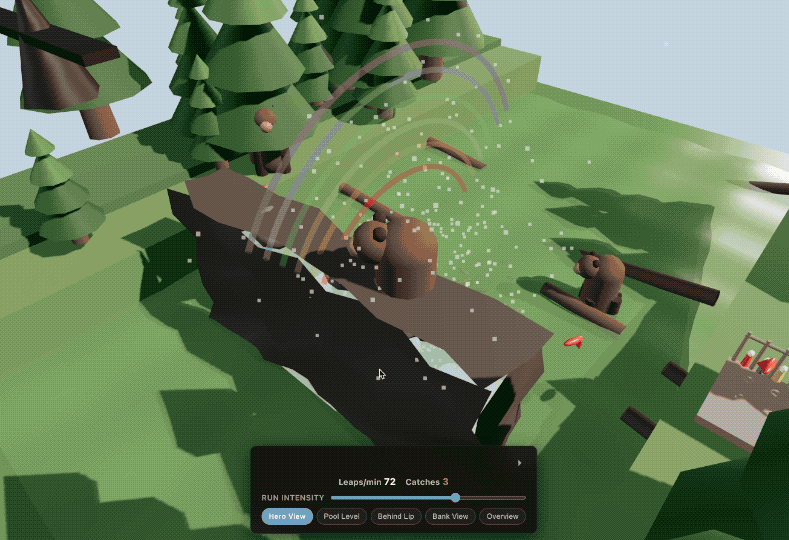
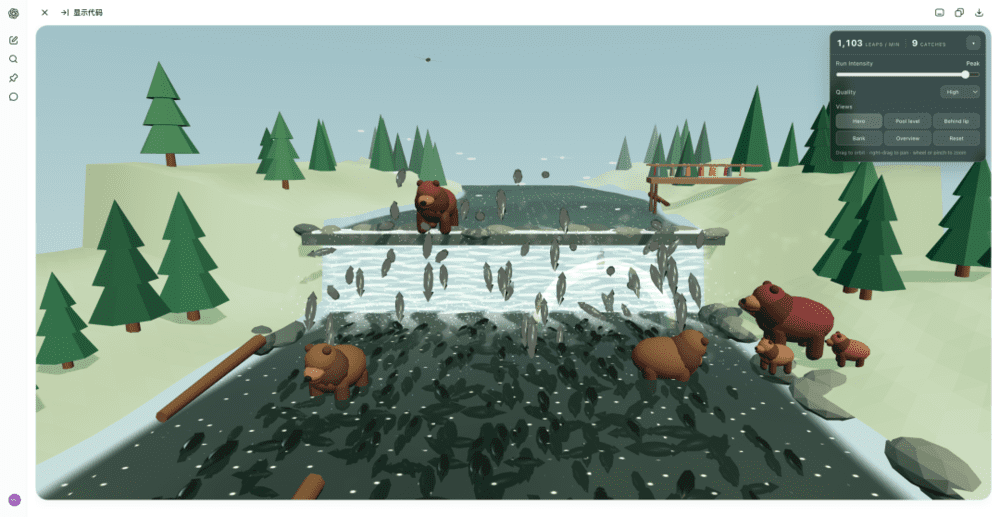
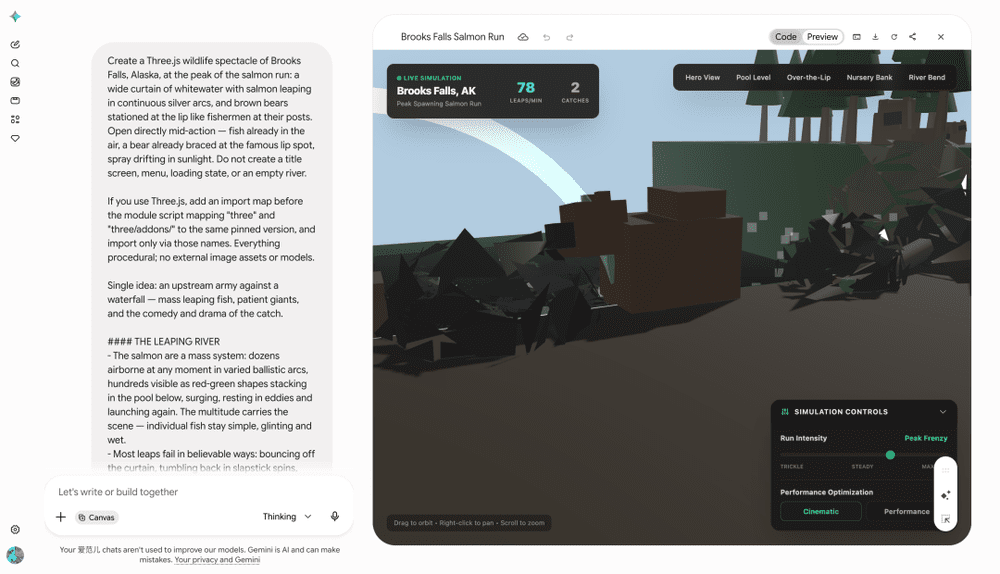
Gemini 3.5 Thinking在生成“熊捕获鲑鱼”场景时,出现了严重的语义理解偏差。原本应有的立体熊模型被简化为四四方方的像素物体,鲑鱼也退化为简单的红色方块,彩虹仅表现为六根直线。尽管基础交互功能可用,但视觉表现与提示词意图相去甚远。
DeepSeek V4 Pro虽然在生成速度上具有优势,但在复杂场景的逻辑一致性上存在短板。在同样的3D网页生成中,出现了较多Bug,物理碰撞检测失效,视觉元素拼凑感强。GLM-5.2的表现则更为抽象,仅实现了视角的简单切换,完全未能还原张家界石林的地理特征。
这些数据佐证了一个观点:在极长尾、高复杂度的3D生成任务中,模型的推理深度决定了最终交付物的质量。GPT-5.6之所以能甩开竞品,关键在于其具备将复杂问题拆解为可执行子任务,并维持全局一致性的能力。
时间与算力的权衡:AI生产方式的范式转移
尽管GPT-5.6在质量上取得了突破,但其高昂的时间与算力成本也不容忽视。同样是生成张家界石林,DeepSeek在10分钟内即可交付结果,而GPT-5.6则需等待近三个小时。在ChatGPT普通对话模式中,即使是中等强度的GPT-5.6 Sol,生成一个简单的“熊捕鲑”场景也耗时40分钟,远超DeepSeek等竞争对手的快速迭代周期。
这引发了一个核心问题:我们究竟在评测什么?是模型的绝对智能上限,还是其在工程落地中的效率平衡?
目前的AI应用生态中,存在两种截然不同的生产方式。一种是“快速原型”模式,追求极速响应,适合创意发散、初步验证和简单Demo制作。DeepSeek等以速度见长的模型在此场景下更具优势。另一种是“高保真交付”模式,通过漫长的推理、多轮自检和大规模算力投入,生成可直接用于生产环境的复杂代码。GPT-5.6 Sol代表的正是后者。
这种差异类似于传统软件开发中“敏捷开发”与“瀑布流工程”的区别。多智能体协作虽然耗时,但它通过引入类似人类项目组中的“审核”、“返工”和“分工”机制,极大地降低了代码出错率,提升了系统的鲁棒性。当模型能够自动规划、自我批评并修正错误时,一次生成便不再是简单的文本输出,而是一次微型的项目管理过程。
未来展望:从“最强模型”到“最佳工作流”
随着AI能力的不断提升,单一的“基准测试得分”已不足以衡量模型的价值。未来的模型评测可能需要引入更维度的指标,如“单位Token的交付价值”、“复杂任务的成功率”以及“资源投入产出比”。
对于开发者和创作者而言,选择哪款模型,实际上是在选择一种工作流。如果你需要在10分钟内验证一个创意想法,速度优先的模型是更好的伙伴;如果你追求极致的视觉表现和复杂的交互逻辑,愿意用时间换取质量,那么具备深度推理和多智能体协作能力的模型则是不可或缺的资产。
GPT-5.6在3D场景生成上的突破,标志着AI正从“内容生成器”向“工程协作者”进化。它不再仅仅是一个填空的工具,而是一个能够理解宏大叙事、拆解复杂任务并执行精细操作的智能体。尽管目前还存在成本高、速度慢的瓶颈,但随着算力的优化和算法的迭代,这种“延迟满足”的生产方式有望成为高质量数字内容创作的标准范式。
在这场技术竞赛中,胜负的关键或许不在于谁跑得最快,而在于谁能在保证质量的前提下,将复杂问题的解决成本降到最低。GPT-5.6展示了这种可能性的边界,也为未来的AI应用开辟了新的想象空间。