GPT-5.6重塑AI竞争格局:从性能炫技到成本为王,大模型如何成为iPhone式生产力工具?
大模型行业的叙事逻辑正在发生剧烈且不可逆的转向。
长期以来,科技巨头们的军备竞赛主要聚焦于参数量级的扩张和智商分数的攀升。然而,随着OpenAI正式发布GPT-5.6系列模型,这一局面被彻底打破。这不仅仅是版本号的迭代,更是大模型从“技术展示品”向“生产力工具”进化的关键里程碑。OpenAI这次没有单纯炫技,而是选择了一条更为务实、甚至略显冷酷的商业化路径:将大模型打造成类似iPhone那样,拥有清晰层级、明确分工且具备极高普及率的标准化产品。
产品分层哲学:从“最好”到“最合适”
OpenAI此次发布的核心策略之一,是彻底重构了GPT系列的命名与分级体系。
过去,用户面对单一的旗舰模型,往往需要在性能与成本之间做非黑即白的选择。而GPT-5.6引入了Sol(太阳)、Terra(地球)、Luna(月亮)三个子版本。这种命名方式虽然富有诗意,但其背后的商业逻辑极其硬核:它标志着大模型产品线的全面分层。
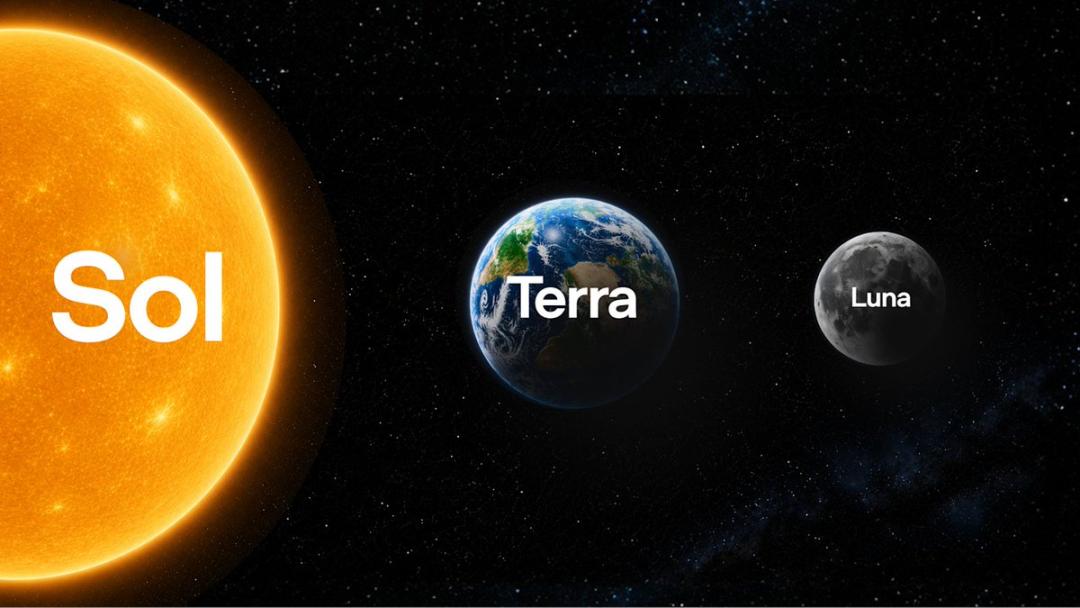
Sol作为旗舰,代表了当前算力的极致上限;Terra定位于日常高频使用,追求性能与成本的平衡;Luna则主打极致性价比,旨在降低使用门槛。这种分级策略借鉴了消费电子行业的成熟经验。正如智能手机市场区分Pro Max、Pro、Standard甚至SE版本一样,大模型不再是一个通用的“超级大脑”,而是需要根据具体场景进行精准匹配的服务组件。
对于企业用户而言,这种分层意味着采购逻辑的根本性变化。开发者不再需要为每一个简单任务调用最强算力,从而大幅优化了整体预算结构。这种“代际+能力层级”的命名法,有望成为未来大模型产品的常态,它有效降低了用户的选择门槛,也让AI基础设施的部署变得更加精细化。
价值评估重构:ALE基准测试的经济意义
如果说产品分层是表象,那么评估体系的变革则是GPT-5.6最核心的创新。
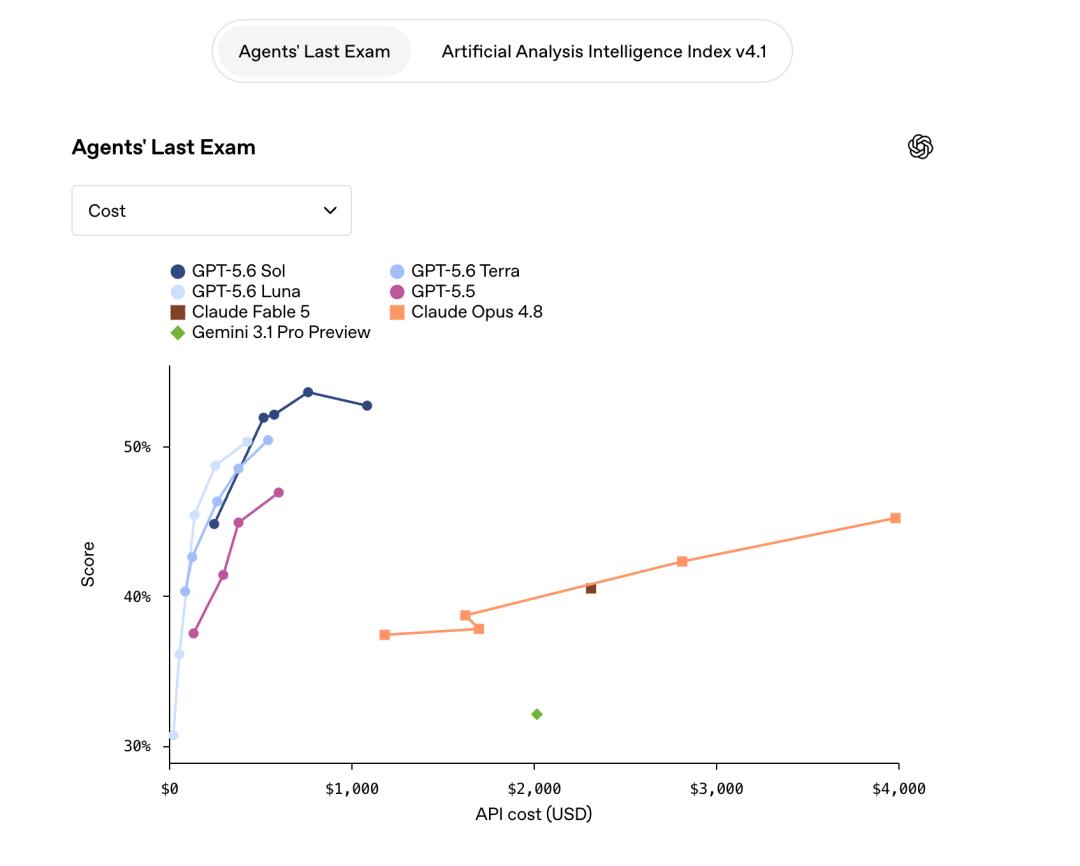
OpenAI推出了全新的基准测试——Agent's Last Exam(ALE)。这项测试的意义在于,它彻底抛弃了传统的代码编写准确率或理论逻辑推理分数,转而衡量AI能否像真实职场员工一样,独立、端到端地完成具有实际经济价值的数字化工作。
ALE测试涵盖了55个行业,包含1500多个真实任务。在这种高压测试下,GPT-5.6 Sol取得了56.3分的历史新高。值得注意的是,这个分数不仅高于竞品Claude Fable 5(自适应推理)13.1分,更关键的是,即使在中等推理水平下,GPT-5.6 Sol依然比Fable 5高出11.4分,而成本仅为后者的四分之一。
这种对比极具震撼力。它表明,大模型的竞争力已经不再仅仅取决于“能不能做”,而是“能不能便宜且高效地做完”。在更小的Terra和Luna模型上,OpenAI宣称其性能依然优于Fable 5,但成本仅为十六分之一。这种“杀人诛心”般的性能价格比,直接击中了当前企业应用AI的最大痛点:高昂的算力成本。
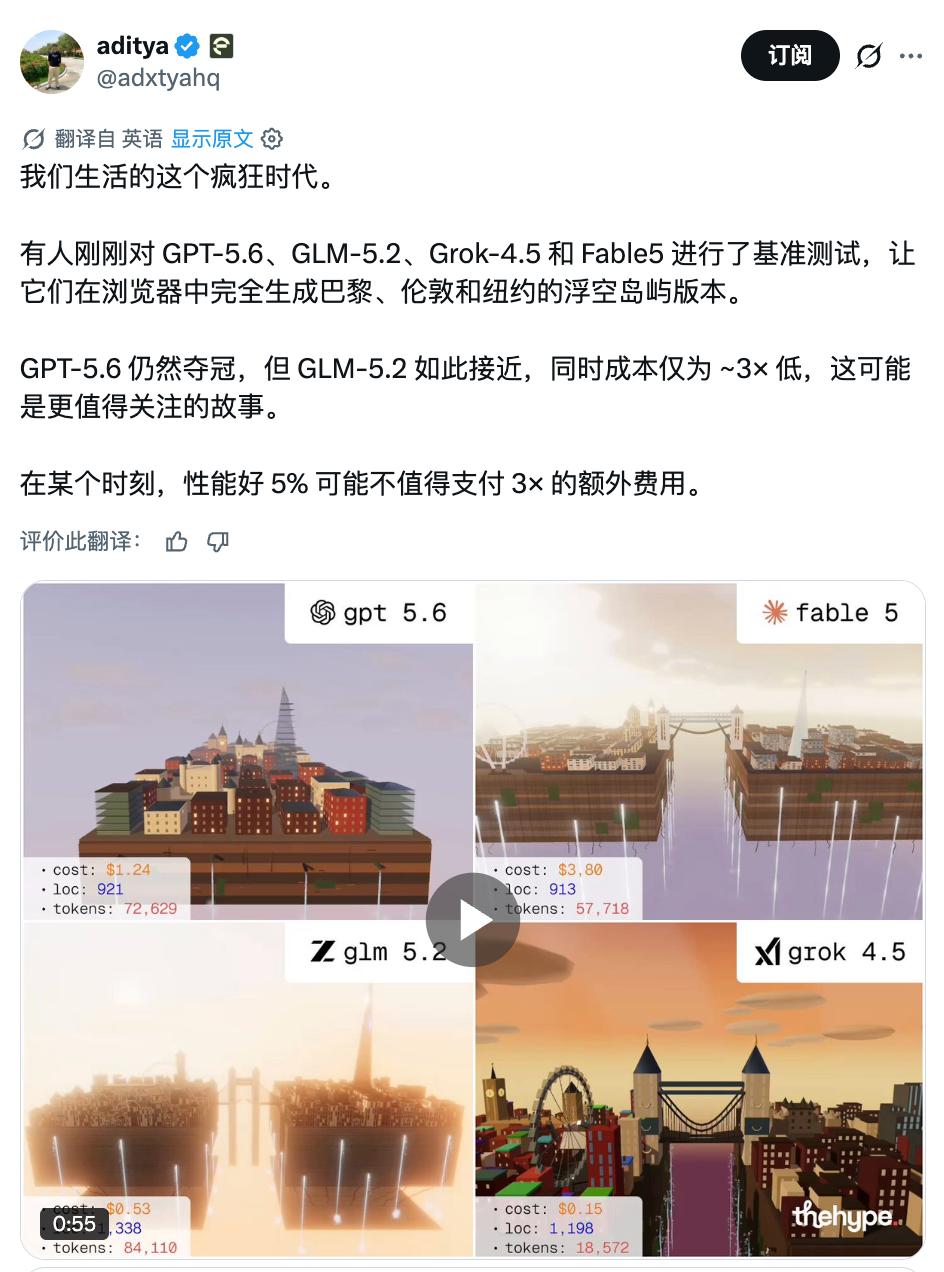
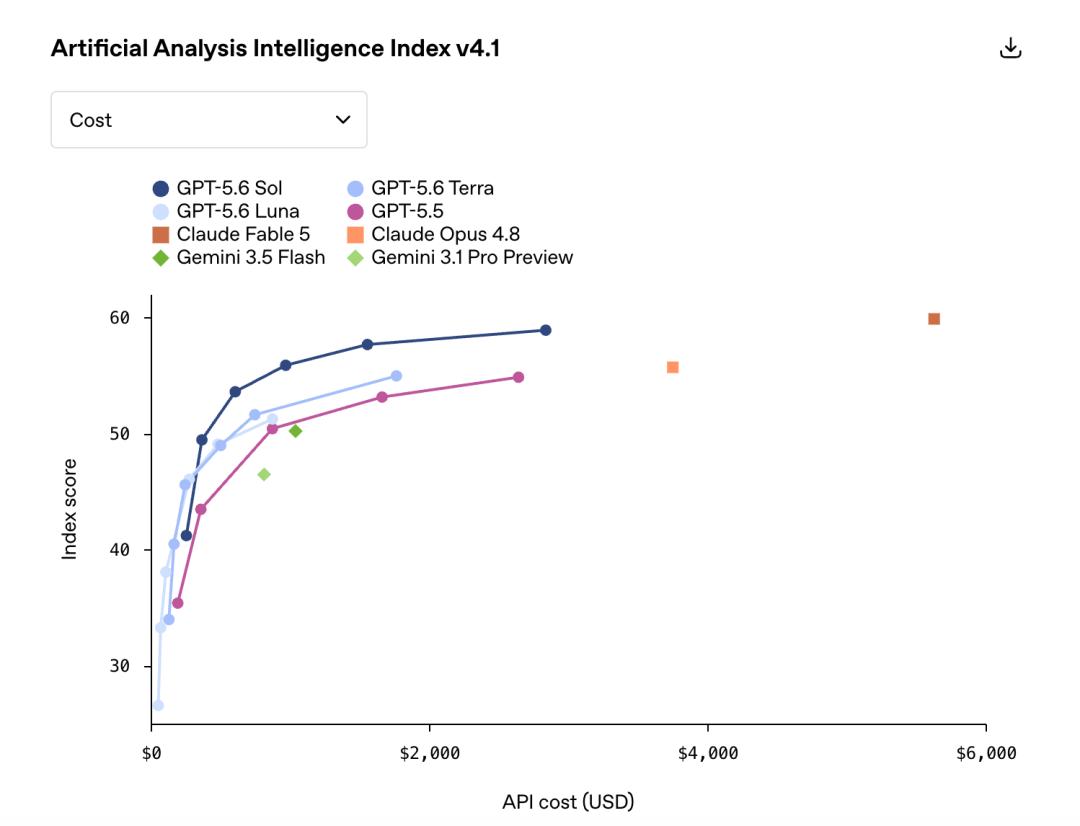
在Artificial Analysis Intelligence Index中,GPT-5.6 Sol虽然在纯智力得分上与Fable 5差距极小(仅低1分),但在完成任务的时间上缩短了61%,成本降低了一半。这意味着,在大多数实际业务场景中,用户可能根本不需要追求绝对的理论智商,而是需要的是更快、更便宜的解决方案。
推理机制升级:Max与Ultra的双轮驱动
为了支撑这种复杂任务的处理能力,GPT-5.6在底层推理机制上引入了两项重大革新:Max推理模式和Ultra并行模式。
Max推理模式允许模型在面对数学证明、复杂规划或科研分析等高难度任务时,投入更多计算资源进行更深度的思考。这类似于人类的“深思熟虑”,通过延长思考时间来换取更高的准确率。而在Terminal-Bench 2.1这类衡量项目综合能力的测试中,这种深度思考显著提升了复杂任务的完成率。
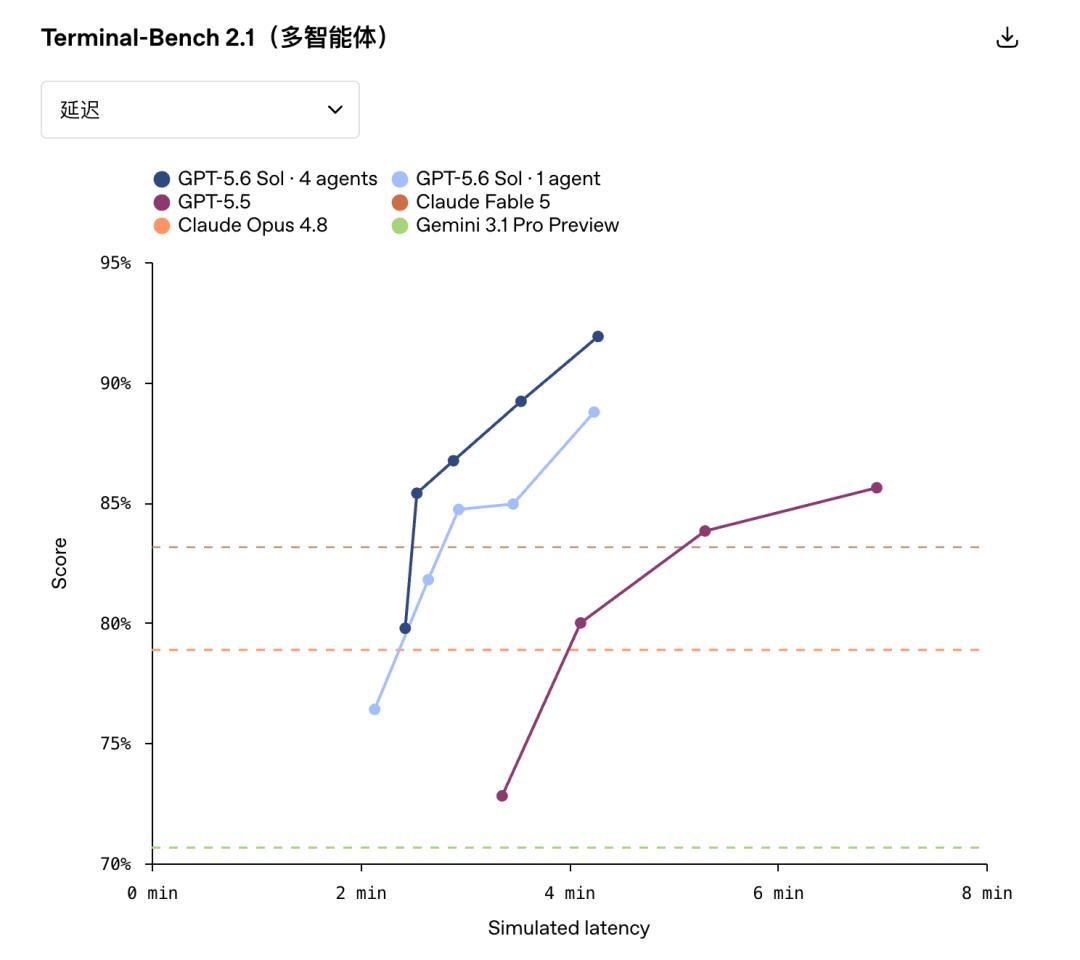
相比之下,Ultra模式则引入了多智能体协作的概念。该模式能够并行协调四个子智能体,分别处理任务的不同模块。这种设计模仿了真实企业中的团队协作模式,通过分工合作来超越单个智能体的能力边界。在处理高要求任务时,虽然Token消耗增加,但响应速度和最终结果的质量得到了显著提升。
这种双模式设计,使得GPT-5.6既具备了处理单一复杂逻辑的深度,又具备了应对多任务并发的广度。对于开发者而言,这意味着可以根据任务特性灵活切换推理策略,从而在性能和成本之间找到最佳平衡点。
垂直场景突破:从办公辅助到科研前沿
除了通用能力的提升,GPT-5.6在垂直领域的应用能力也呈现出质的飞跃。
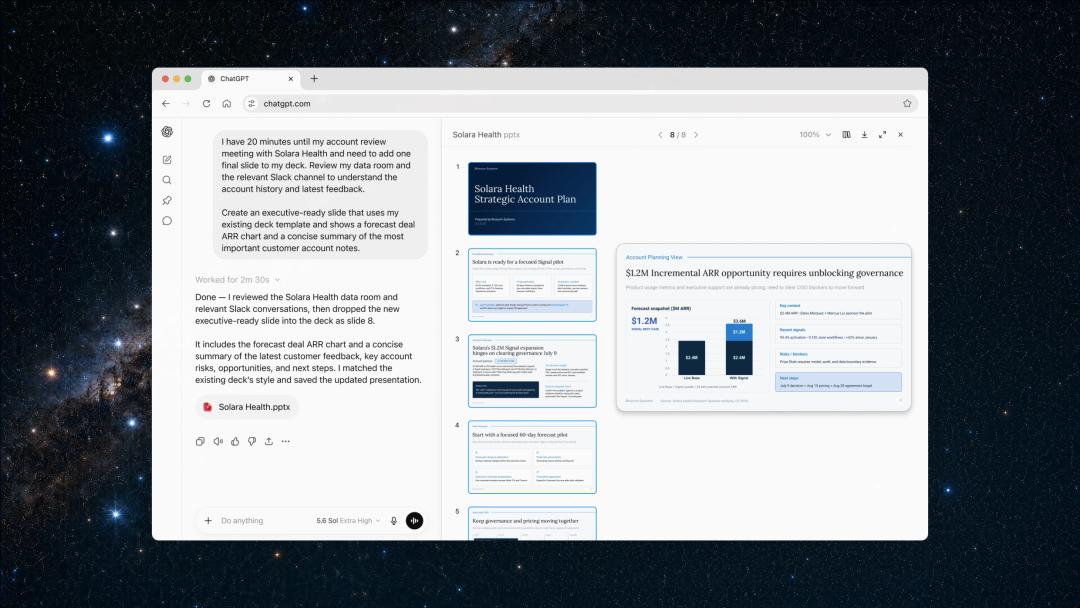
在办公场景方面,GPT-5.6能够生成更加精美、准确的PPT、Word文档和Excel表格。更重要的是,当提供参考模板时,其生成内容的风格还原度极高。在多个办公场景基准测试中,GPT-5.6系列模型在保持高质量输出的同时,显著降低了Token消耗。
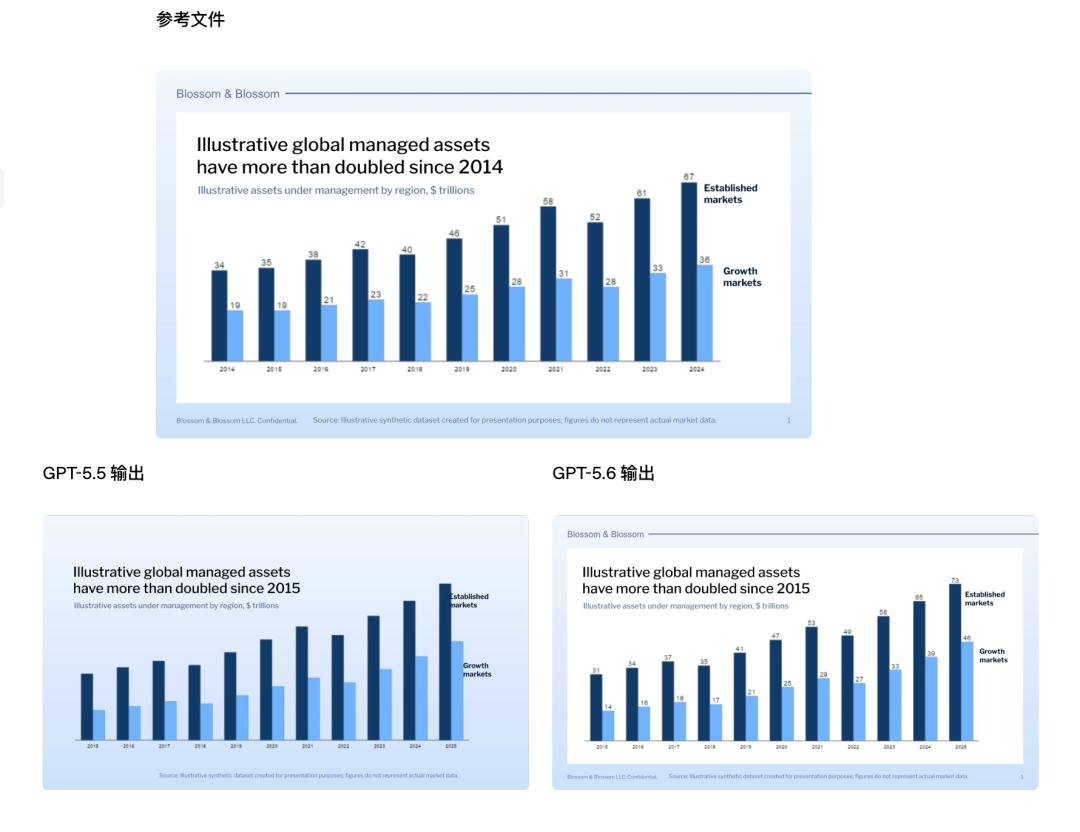
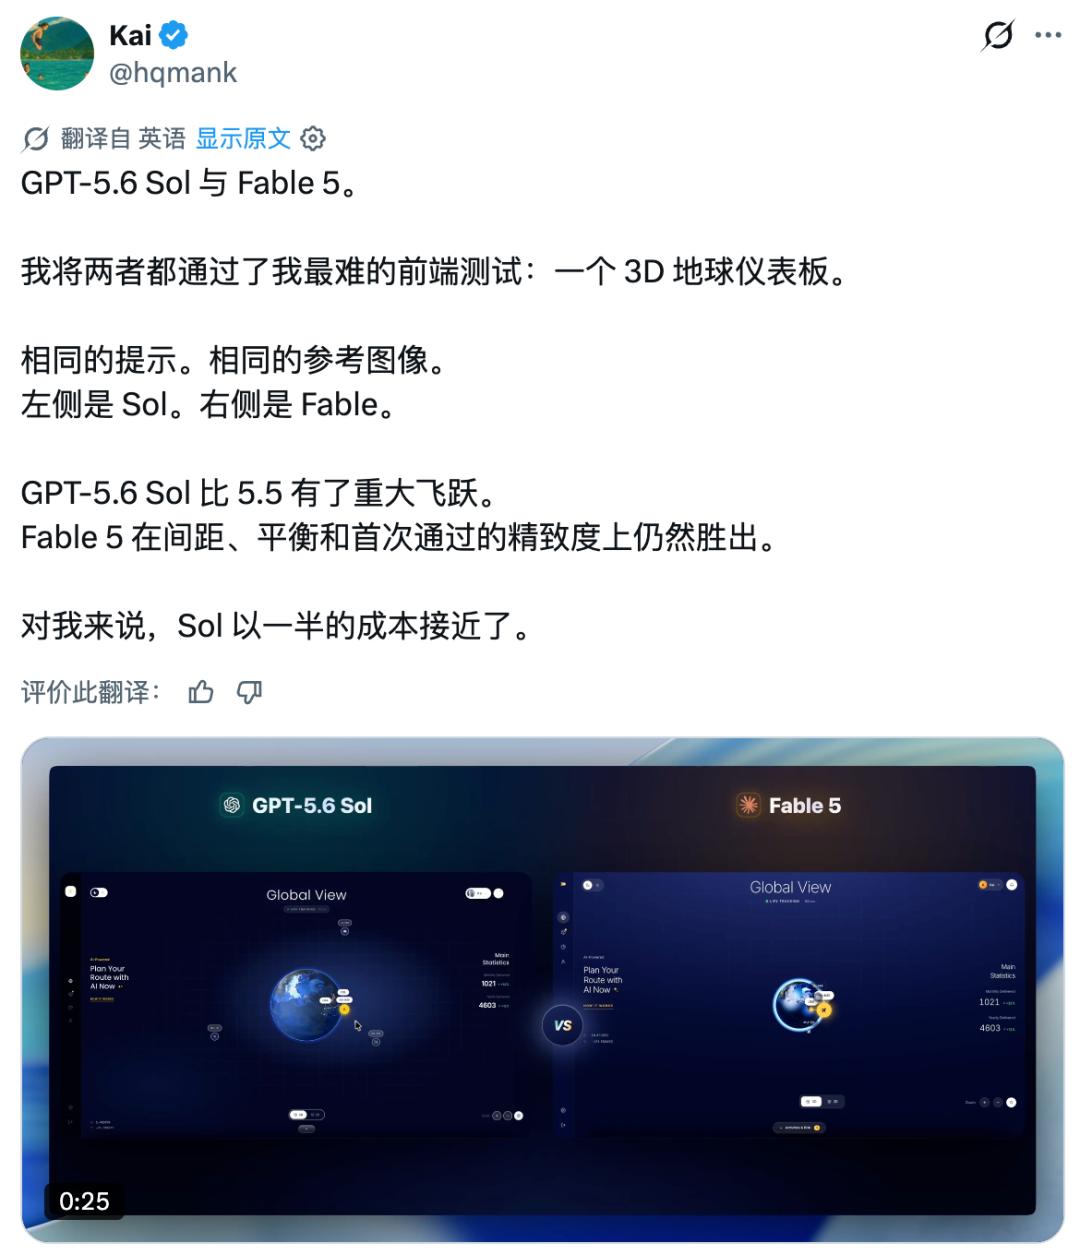
在视觉设计领域,无论是游戏页面布局、室内方案展示,还是前端网页动画,GPT-5.6都具备自我检查和优化的能力。它不仅能生成代码,还能从视觉和功能双重维度进行迭代优化,这极大地降低了前端开发的设计门槛。
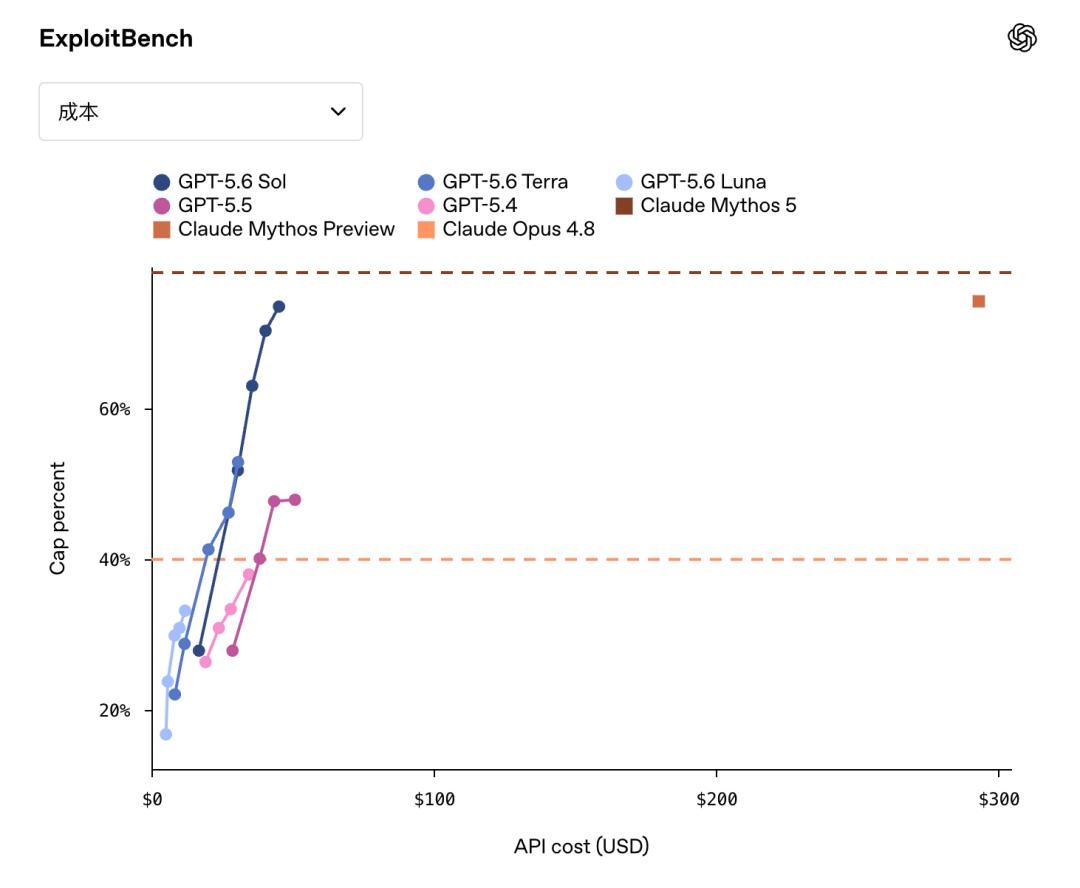
尤为值得关注的是网络安全领域。OpenAI在更新说明中用近一半篇幅强调了其在安全方面的进步。在漏洞挖掘和利用攻击能力的基准测试中,GPT-5.6系列产品能够在消耗更少Token的情况下,达到与Anthropic竞品相同的得分。这表明,随着AI能力的增强,安全防御与攻击技术的对抗也在升级,而GPT-5.6在保持高性价比的同时,具备了更强的安全博弈能力。
此外,在生物学、生命科学研究以及化学实验模拟等科研领域,GPT-5.6 Sol在成本和速度上的优势,使其成为科研人员有力的辅助工具。它不仅加速了数据处理过程,还能在实验设计阶段提供多维度的假设验证,从而缩短科研周期。
生态整合与竞争格局:ChatGPT-Work的野心
伴随模型发布,OpenAI还推出了ChatGPT-Work,这是一个由GPT-5.6驱动的全新应用形态。它将Chat、Work文档处理和Codex代码解释器整合在一起,试图打造一个一站式的生产力平台。
与此同时,OpenAI宣布下线独立的Codex平台。这一举动引发了行业广泛讨论。这是否意味着未来大模型行业将趋向于“超级应用”模式?类似于字节跳动整合豆包、TRAE和即梦,OpenAI试图通过内部整合,减少用户在不同工具间的切换成本,提供更流畅的体验。
然而,这种封闭生态的策略也面临着挑战。国外用户反馈显示,虽然GPT-5.6在前端动画设计和成本上优于GPT-5.5,但在某些创意细节上仍不及Anthropic的Fable 5。这说明,尽管整体性能强大,但在特定垂直领域的极致体验上,竞品依然拥有护城河。
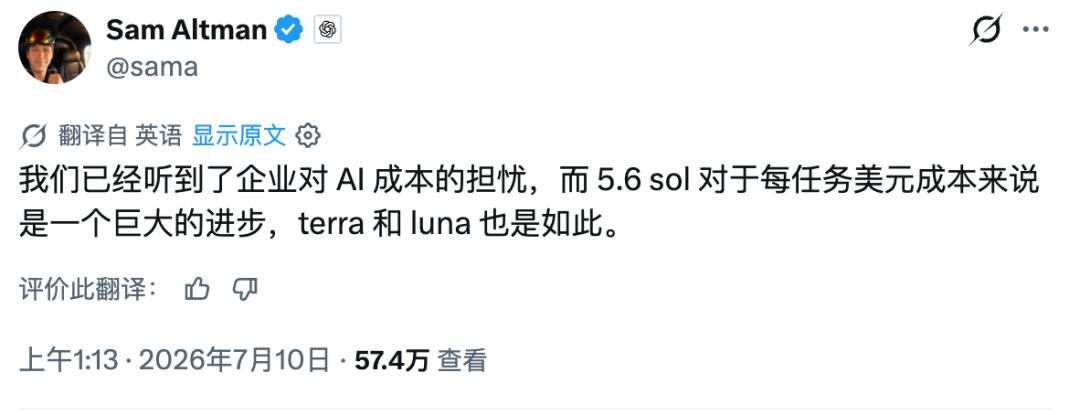
CEO萨姆·奥特曼在社交媒体上明确表示,OpenAI已充分意识到企业对AI成本的担忧,GPT-5.6正是在这一维度上实现了重大突破。在全球Token消耗量暴涨的背景下,如何降低使用成本,已成为衡量产品竞争力的核心指标。
成本之战:全球视野下的定价策略
价格是企业采用AI技术的最后一道门槛。GPT-5.6系列的定价策略显示了OpenAI的决心:
- Sol版本:输入5美元/百万Token,输出30美元/百万Token。
- Terra版本:输入2.50美元/百万Token,输出15美元/百万Token。
- Luna版本:输入1美元/百万Token,输出6美元/百万Token。
作为对比,竞品Claude Fable 5的价格高达输入10美元、输出50美元。相比之下,GPT-5.6的性价比优势显而易见。然而,若将视野拓展至全球市场,尤其是面对中国大模型阵营,这一价格依然显得“奢侈”。
例如,DeepSeek V4的输入价格仅为3元(约0.44美元),输出6元(约0.88美元);豆包2.1 Pro的输入价格为6元,输出30元。即使是马斯克旗下的Grok 4.5,也主打低成本路线,输入2美元,输出6美元。
这种价格落差揭示了全球AI市场的分层现实。在欧美企业市场,OpenAI凭借先发优势、生态完善度和品牌信任度,依然拥有定价权。但在对价格敏感的新兴市场或大规模部署场景中,国产模型凭借极致的成本控制和快速迭代能力,构成了强有力的竞争威胁。
未来展望:谁将定义AI的“iPhone时刻”?
马斯克曾反复强调,能力、速度和更低的使用成本,三者结合才是大模型真正的产品力。GPT-5.6的出现,正是OpenAI对这一理念的践行。它不再盲目追求参数的无限膨胀,而是试图在智力、速度和成本之间找到最优解。
然而,大模型战争的终局,或许并不属于最聪明的那个模型,而是属于能让大多数人低成本解决真实需求的那个平台。
OpenAI通过GPT-5.6试图确立类似智能手机时代的行业标准,但这一过程并非坦途。一方面,Anthropic等竞品在特定垂直领域依然保持优势;另一方面,中国大模型厂商在成本控制和场景落地上的迅猛发展,正在压缩全球市场的利润空间。
未来,大模型行业的竞争将从“技术单点突破”转向“生态综合较量”。谁能更好地整合工具链,谁能提供更稳定的API服务,谁能以更低的边际成本服务于海量用户,谁才能最终胜出。
GPT-5.6是OpenAI迈向这一目标的重要一步,但它也暴露了当前AI行业面临的共同难题:在算力成本尚未完全大幅下降之前,如何在保持高性能的同时,持续压低价格,将是所有玩家必须面对的商业命题。这场关于Token消耗量的战争,才刚刚开始。