具身智能数据独角兽崛起:44亿融资背后的商业逻辑与盈利困局
资本狂热下的冷静观察:具身数据赛道的冷与热
在具身智能(Embodied AI)的风口中,当“大脑派”的模型公司动辄斩获数十亿融资时,处于产业链上游的“数据派”似乎显得有些边缘。然而,数据是具身智能的燃料,没有高质量的数据,再强大的模型也只是空中楼阁。2025年7月至2026年7月这一年间,具身数据行业呈现出一种独特的两极分化景象:一方面,近百家玩家涌入,15家独立具身数据服务商累计融资高达44.7亿元人民币;另一方面,行业整体估值逻辑尚未完全理顺,盈利模式仍在探索中。
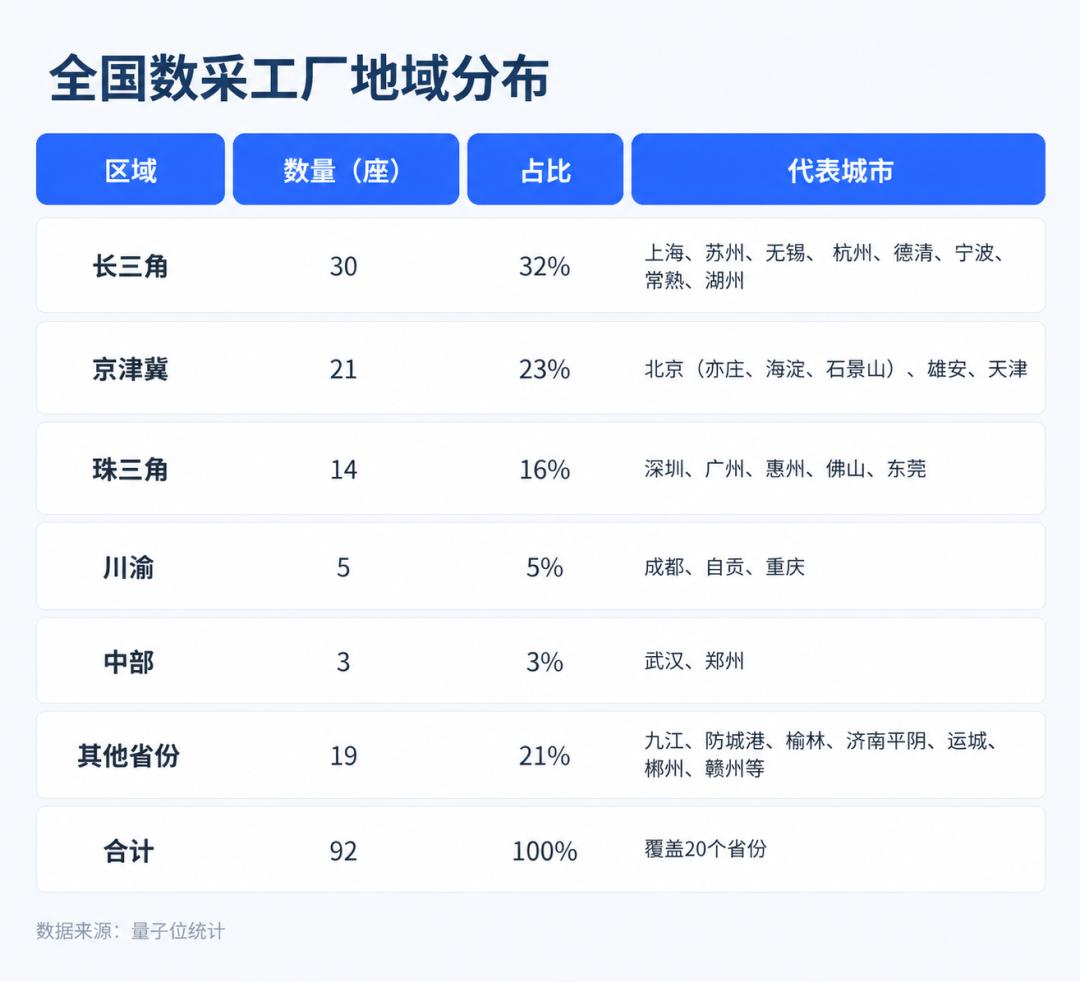
这种现象背后,是机器人行业对物理世界交互数据的极度渴求。从湖南郴州的“具身数据采集5S店”到无锡的“全域数据采集”实验,数据采集的形式正在从传统的工厂流水线向家庭、公共场所甚至云端延伸。这不仅是一个技术问题,更是一个涉及劳动力分配、资产重配和商业模式重构的系统工程。
技术路线的分野:没有唯一的真理
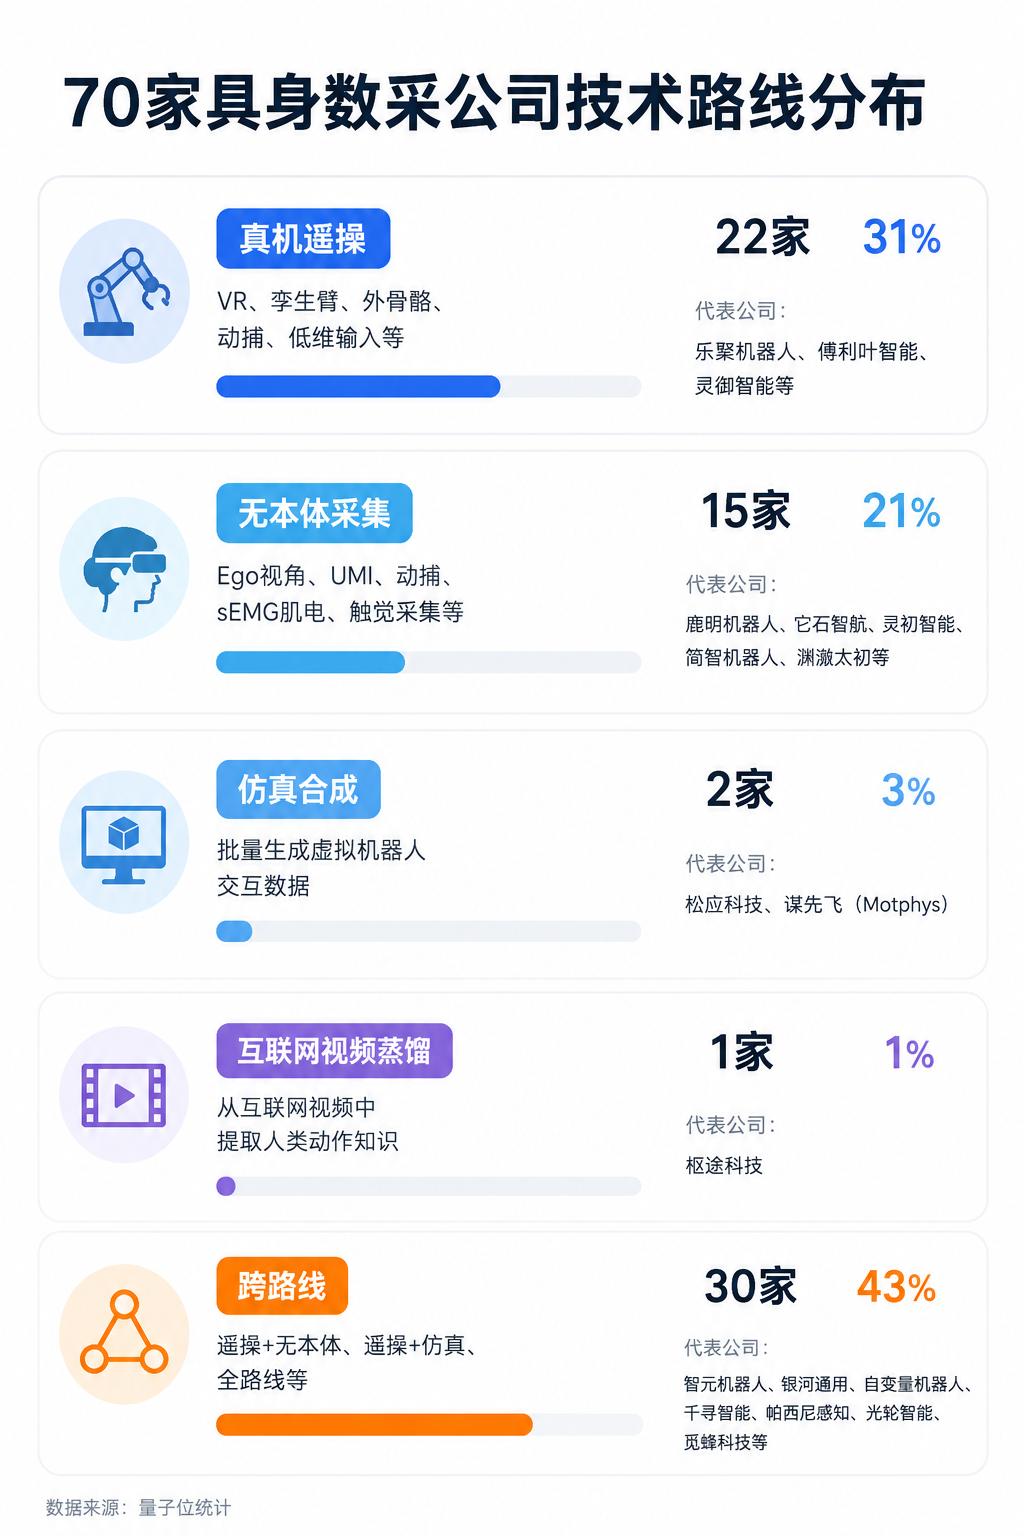
具身数据采集的核心痛点在于:如何低成本、高保真地获取机器人在复杂物理环境中的操作数据。目前,行业内的技术路线并未形成统一标准,而是呈现出多元化的竞争格局。
真机遥操(Teleoperation)是目前资本认可度较高的路线。通过人类操作员远程操控真实机器人,同步采集动作、力觉和视觉数据,这种方法获取的数据质量最高,最接近真实场景。然而,这是一条重资产、重人力的路线。需要租赁场地、购买机器人本体、雇佣大量操作员。因此,这条赛道主要由具备资金优势的国资平台和拥有硬件资源的机器人公司主导。
相比之下,无本体采集(No-Embodiment)则更加轻量化。它不依赖机器人实体,而是通过动捕设备、肌电传感器(sEMG)或第一视角相机,记录人类的操作动作。这种方法成本低、部署灵活,适合快速规模化。但问题在于,如何将这些人类动作映射到不同构型的机器人上,以及如何模拟真实的物理反馈(如摩擦力、形变),仍是技术难点。
此外,仿真合成(Simulation)和互联网视频蒸馏(Video Distillation)作为补充路线,也在加速发展。仿真数据虽然成本极低,但存在Sim2Real Gap(仿真到现实的差距),难以完全替代真实数据。视频蒸馏则试图从海量互联网视频中提取知识,但其在三维空间理解和精细操作上的精度仍待验证。
值得注意的是,跨路线采集成为主流趋势。约43%的玩家同时采用多种采集方式,这表明单一技术路线难以满足具身大模型对数据多样性、多样性和高质量的要求。行业正从“单点突破”走向“混合采集”。
玩家图谱:独立服务商的崛起与分化
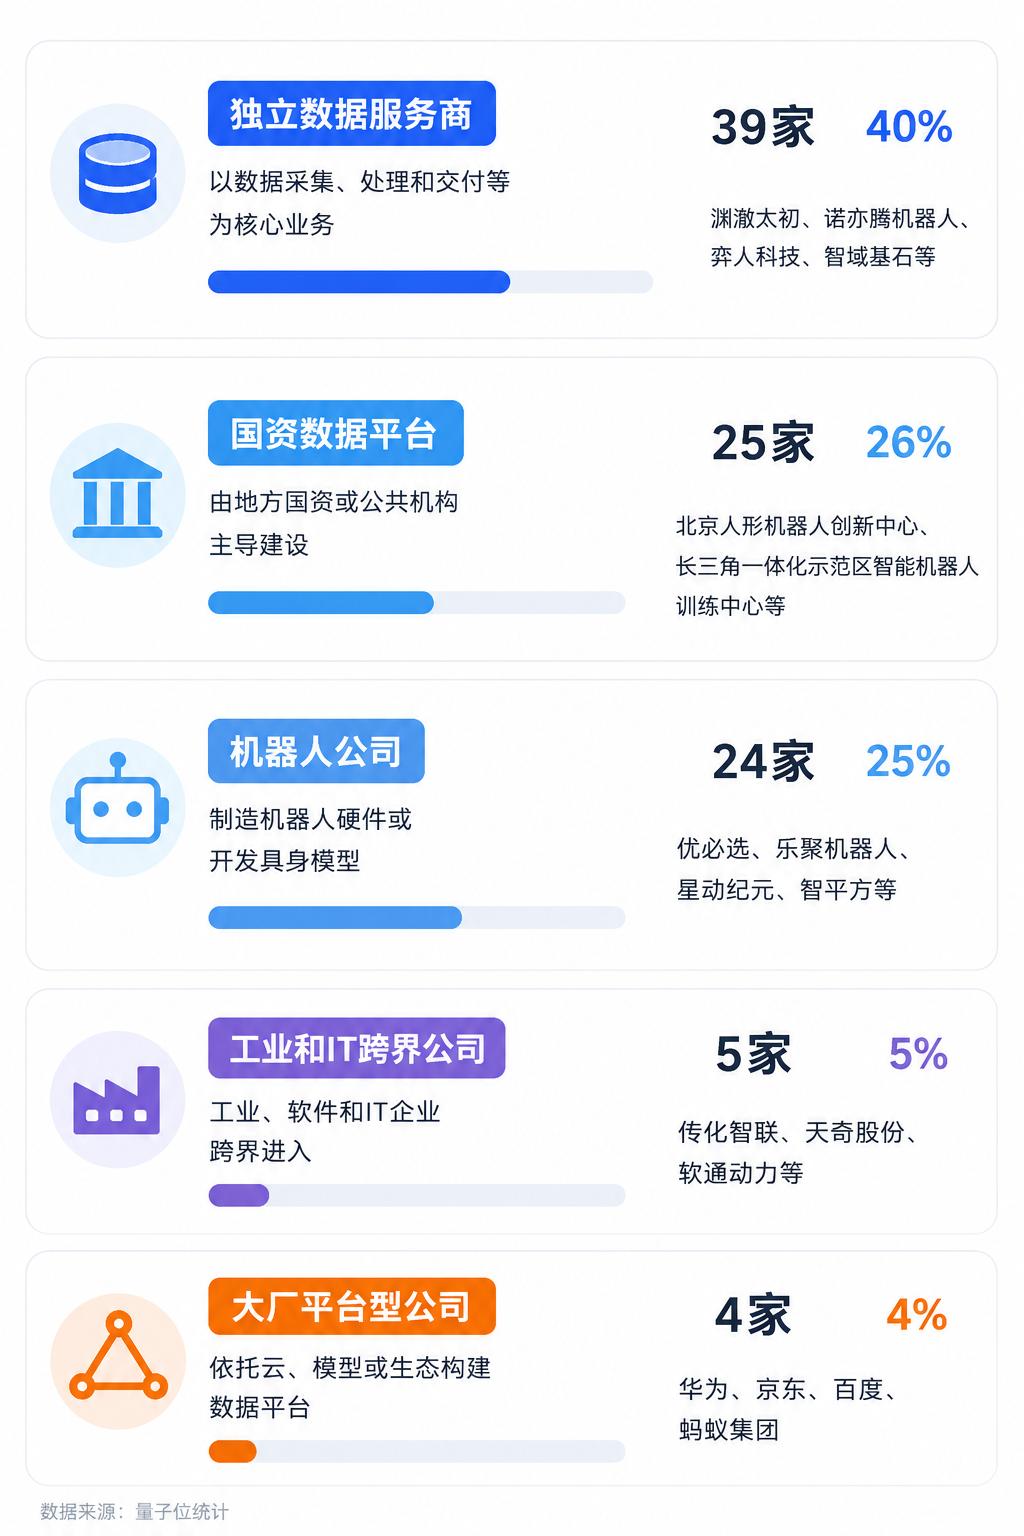
如果将视角从技术路线转向市场主体,会发现一个有趣的现象:具身数据已经成长为一个独立的赛道。在统计的97家玩家中,39家是独立数据服务商,占比40%,成为最大的玩家群体。这意味着数据服务正从机器人本体公司的附属部门中剥离,形成专业化的供应链。
独立数据服务商内部也呈现出明显的梯队分化。
第一梯队以光轮智能为代表,过去一年完成6轮融资,总额约31亿元,最新估值超20亿美元,成为全球首个具身数据独角兽。其核心优势在于建立了规模化、标准化的数据生产体系,并打通了从采集、标注到清洗的全链路。
第二梯队包括简智机器人、诺亦腾等十余家公司,累计融资在数千万至数亿元之间。这些公司多在细分技术点(如动作捕捉、肌电采集)具有优势,正在寻求规模化落地。
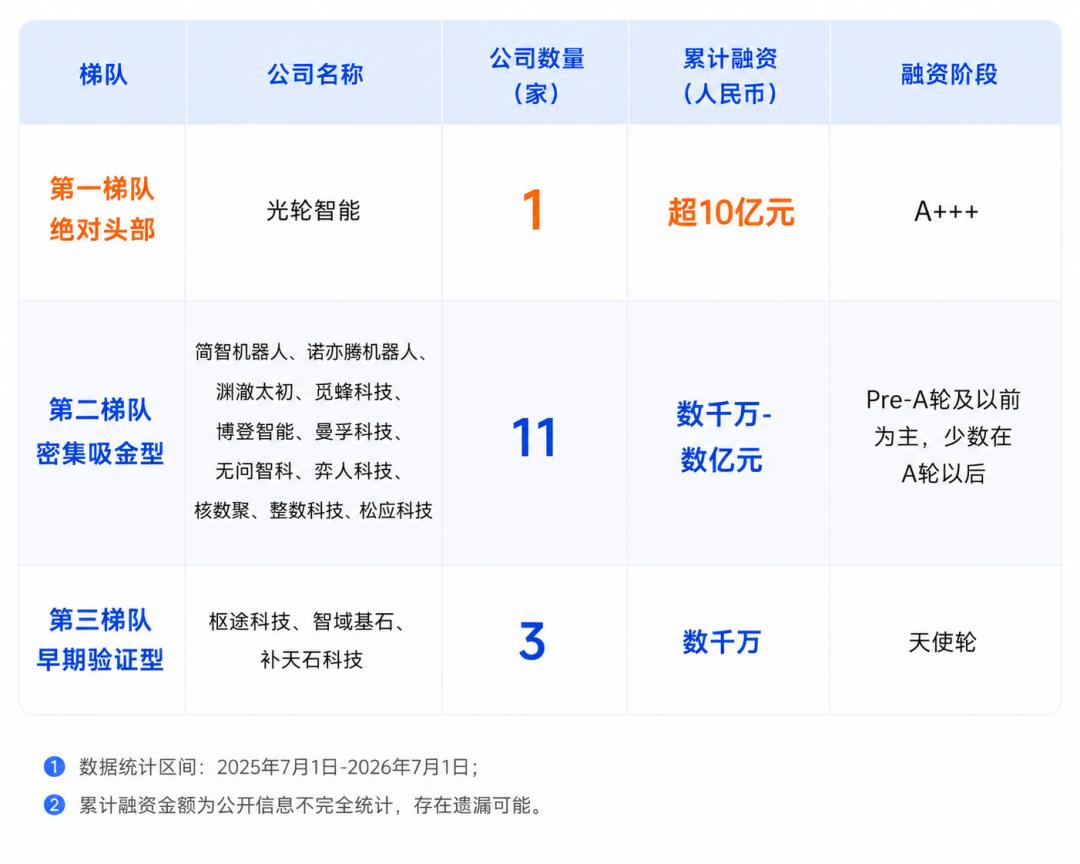
第三梯队则多为早期创业公司,融资规模在数千万元,业务尚处于验证阶段。
此外,国资数据平台(25家)和机器人公司(24家)也是重要力量。国资平台凭借“不怕重”的特点,在真机遥操基地建设中占据主导;机器人公司则出于自身训练需求,构建内部数据闭环。
产能焦虑:15-20倍的供给缺口
尽管融资火热,但具身数据行业面临的最大挑战是巨大的产能缺口。
据统计,当前行业年产能约为160万至180万小时(真机与无本体数据),以及7000万至8000万条其他类型数据。而行业的短期目标(1-3年)是产出2500万至3500万小时数据。这意味着,现有产能需要扩大15到20倍才能满足未来的需求。
相比之下,大语言模型(LLM)的训练数据可以来自整个互联网,量级是以PB计的。而具身智能的数据需要“一条一条采”,且要求高保真的物理交互信息。截至2026年初,全球高质量真实物理交互数据总量仅约50万小时,不足LLM训练数据量的两万分之一。
这种供给与需求的巨大落差,导致数据价格居高不下,同时也催生了各种“花活”。例如,将数据采集嵌入VR游戏、免费上门保洁等场景,试图通过降低边际成本来扩大数据获取规模。但这些尝试能否真正产生商业价值,仍有待观察。
资本逻辑:谨慎撒网,未见重仓
与具身智能全行业半年融资438亿元的狂热相比,具身数据赛道一年的44.7亿元融资显得相对克制。更值得注意的是资本的结构:69家投资机构出手,但没有一家机构对某一家公司进行重仓加注。
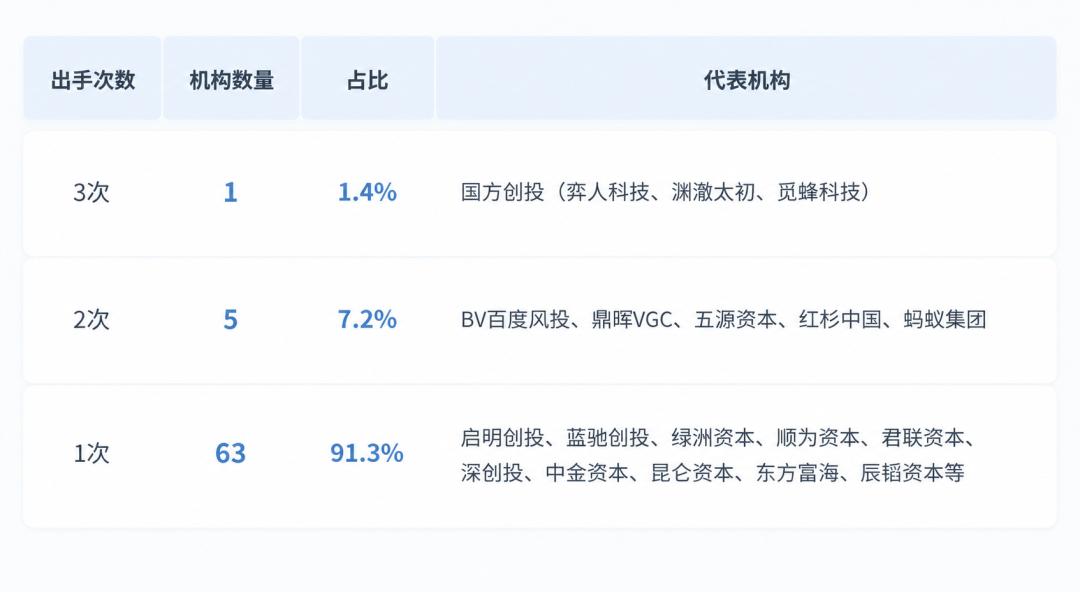
这种谨慎态度反映了资本对行业本质的判断:
- 劳动力密集型属性:真机遥操等主流采集方式本质上是劳动力密集型产业。随着数据需求的增加,人力成本将线性甚至指数级上升,难以享受纯粹的指数级增长红利。
- 价格竞争预期:随着产能扩大,数据价格必然面临下行压力。
- 天花板可见:相对于具身大模型无限的想象空间,数据采集的市场规模相对有限,主要受限于机器人出货量。
因此,资本目前采取“撒网”策略,试图在早期阶段捕捉潜在的赢家。但直到目前,还没有一家公司公开证明“纯卖数据”是一门高利润、可规模化的好生意。
未来展望:从“卖苦力”到“卖能力”
具身数据行业正处于从“0到1”向“1到10”过渡的关键阶段。未来两年将是商业模式验证的决定性窗口期。
首先,产能兑现与成本控制将是首要任务。谁能率先解决Sim2Real Gap,大幅提升仿真数据的可用性,或者通过自动化技术降低真机采集的人力依赖,谁就能获得成本优势。
其次,数据标准化与评估体系的建立至关重要。目前各家机构披露口径不一,缺乏统一的质量评估标准。建立行业公认的数据基准(Benchmark)和质量评级,将有助于提升数据交易效率。
最后,商业模式的外部化拓展是必由之路。单纯依赖机器人公司采购数据,市场空间有限。具有潜力的服务商正在将数据采集能力延伸至模型评测、通用物理引擎构建等领域,试图成为物理AI的基础设施提供商。
具身数据赛道或许不会诞生下一个万亿市值的互联网巨头,但它将是具身智能时代不可或缺的“卖铲人”。在这场马拉松中,能够平衡质量、成本与规模,并率先实现盈利闭环的公司,将最终赢得市场的尊重。对于投资者和从业者而言,保持耐心,关注那些在技术底层和商业模式上具备长期竞争力的玩家,或许比追逐短期的融资热点更为重要。