AMD联想BW2026首发锐龙AI Max:1.5kg轻薄本如何引爆端侧AI算力革命?
在数字娱乐与前沿科技交汇的浪潮中,硬件性能的边界正在被重新定义。2026年7月10日,随着Bilibili World 2026在上海国家会展中心盛大开幕,AMD以“为热爱全力以赴”为主题正式参展,并联合联想带来了行业瞩目的重磅发布:两款基于锐龙AI Max系列处理器的旗舰级新品——YOGA Pro 15锐龙AI创作本与联想拯救者R9000X游戏本。这一动作不仅标志着AMD在高端移动计算平台的战略深化,更揭示了AI算力从云端向终端下沉的明确趋势。
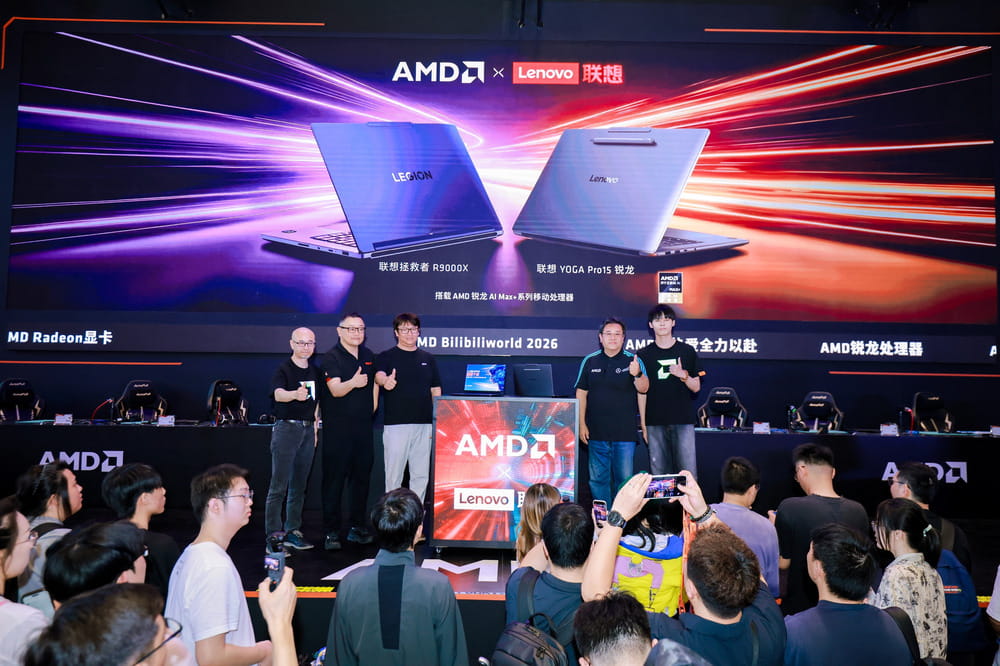
这两款新品分别搭载了锐龙AI Max+ 392与锐龙AI Max+ 388处理器,看似是同一系列的产品迭代,实则针对“专业创作”与“极致游戏”两大截然不同但日益融合的用户场景,做出了精准的性能拆解与架构优化。它们共同的核心竞争力,在于打破了传统笔记本在轻薄便携与高性能释放之间的零和博弈,通过端侧AI算力的爆发,重新定义了移动设备的智能化上限。

创作力的本地化重构:YOGA Pro 15锐龙AI创作本

对于专业内容创作者而言,时间即成本,数据安全即生命线。YOGA Pro 15锐龙AI创作本的出现,旨在解决传统云端AI服务存在的延迟高、隐私泄露风险以及按量付费成本不可控等痛点。

该机型的灵魂在于其搭载的锐龙AI Max+ 388处理器。尽管其CPU部分采用了8核16线程的设计,相较于旗舰型号略显精简,但其核心优势在于GPU与NPU的协同效应。它内置了基于XDNA 2架构的NPU,算力高达50 TOPS,并配备了64GB超大容量统一内存。值得注意的是,该架构支持四通道256bit高带宽,且允许最高将48GB内存分配为显存使用。这种统一内存架构(UMA)的灵活运用,使得本机能够在本地流畅运行参数量高达70B级别的大语言模型。
在实际应用场景中,这意味着创作者无需依赖不稳定的网络连接,即可在本地完成复杂的文案撰写、创意发散、海量素材整理以及长文档深度总结。这种“即用即走”的本地AI体验,配合联想自研的天禧AI 4.0系统,实现了AI助手与操作系统层面的深度耦合。天禧AI 4.0不仅是一个应用,更是一个底层操作系统级的智能中枢,它让AI能力像呼吸一样自然融入工作流。
硬件细节上,YOGA Pro 15锐龙在兼顾1.7kg轻薄机身的同时,引入了三项关键创新以契合专业需求:全域压感触控板支持4096级压感笔,通过Wacom官方认证,为数字绘画提供了接近真实纸笔的阻尼感;屏幕峰值亮度达1100尼特,确保在户外强光下画面依然清晰锐利;双PANTONE色彩认证及出厂逐屏校准,则从源头保证了视觉创作的色彩准确性。这是一款为“移动创意工作室”量身定制的工具,它让高性能创作不再受限于办公桌前。
轻薄与性能的极限平衡:拯救者R9000X游戏本
游戏玩家群体对性能的诉求往往更为直接且苛刻,尤其是面对日益庞大的3A大作和不断进化的AI辅助功能。拯救者R9000X的发布,展示了AMD在移动游戏领域的新标杆。
拯救者R9000X搭载了规格更为强悍的锐龙AI Max+ 392处理器。基于Zen 5架构,这款处理器拥有12核心24线程,最高加速频率可达5.0GHz,配合40个计算单元的Radeon 8060S集成显卡,整机性能释放高达120W。在传统的认知中,轻薄游戏本往往需要在散热和性能之间做出妥协,但R9000X通过优化散热模组与硅脂导热效率,在15.9mm的厚度与1.55kg的重量下,实现了近乎桌面级的性能输出。
这款产品的另一大亮点是其2.5K分辨率、165Hz刷新率的OLED屏幕。OLED面板的高对比度和极速响应时间,对于竞技网游中的瞬时反应至关重要,而在内容创作领域,其广色域表现同样出色。键盘方面,1.5mm键程配合清晰的段落感,有效缓解了长时间游戏或码字的疲劳感。
更重要的是,R9000X将AI能力引入了游戏领域。得益于50 TOPS的NPU算力,它不仅能流畅运行主流3A大作,还能利用本地AI算力进行游戏画面增强、NPC行为逻辑优化以及辅助渲染加速。天禧AI 4.0在这里的角色转变为“游戏副驾驶”,提供实时的战术分析、资源管理建议以及自动化任务执行。这种“娱乐+创作”的双重属性,使得R9000X不仅仅是一台游戏机,更是一个全能的内容生产终端。
硬件底座解析:锐龙AI Max+系列的技术突破
要理解这两款产品的强大,必须深入其核心硬件架构。锐龙AI Max+ 388与392并非简单的频率调整,而是架构级优化的产物。
首先,Zen 5架构带来了显著的IPC(每时钟指令数)提升,这意味着在相同频率下,CPU的处理效率更高,这对于多任务并行处理(如一边渲染视频一边运行AI模型)至关重要。其次,Radeon 8060S集成显卡虽然名为“集成”,但其规格已接近中端独立显卡水平,配合统一内存架构,极大地降低了数据在CPU、GPU和NPU之间的传输延迟。
NPU作为AI算力的引擎,其50 TOPS的算力在移动端属于第一梯队。传统PC的AI推理往往依赖GPU,导致功耗高、发热大;而NPU专为矩阵运算设计,能效比极高。这使得在本地部署大模型时,电池续航不再迅速崩盘,机身温度也能保持在舒适区间。
此外,64GB大容量内存的标配,解决了AI应用“内存墙”的问题。大语言模型的权重加载需要巨大的显存或内存空间,统一内存架构使得系统可以灵活调度这部分资源,无需像传统PC那样预留专门的显存,从而最大化利用每一比特存储资源。
天禧AI 4.0:从“工具”到“伙伴”的体验跃迁
无论是YOGA Pro 15还是拯救者R9000X,均预装了联想自研的天禧AI 4.0系统。这标志着AI从“安装一个APP”的时代,迈入了“系统级融合”的时代。
天禧AI 4.0的核心价值在于“本地化”与“个性化”。在本地部署的大模型可以记忆用户的使用习惯、工作偏好甚至创作风格,从而提供更具针对性的建议。例如,对于设计师,它可能根据历史作品推荐配色方案;对于游戏玩家,它可能根据操作习惯优化键位映射。
数据安全是另一大关键优势。所有数据处理均在本地完成,无需上传至云端服务器,这在涉及商业机密、个人隐私数据的场景中具有不可替代的价值。同时,摆脱了网络带宽的限制,AI响应速度实现了毫秒级延迟,真正做到了“所思即所得”。
行业展望:端侧AI重塑移动计算格局
AMD与联想在BW2026的联合首发,不仅是一次产品亮相,更是对移动计算未来形态的一次宣告。随着大模型技术的日益成熟,云端AI虽然强大,但受限于网络、成本和隐私,难以覆盖所有场景。端侧AI,即本地AI,将成为下一个十年的核心增长点。
锐龙AI Max系列的成功,证明了高性能与高能效可以在移动设备上共存。对于专业人士,这意味着工作流的重构:从“等待云端生成”变为“即时本地交互”;对于玩家,这意味着游戏体验的升级:从“单纯娱乐”变为“智能互动”。
未来,我们可能会看到更多基于统一内存架构和低功耗NPU设计的设备出现。AI不再是一个附加功能,而是像CPU和GPU一样,成为计算平台的基础设施。在这种趋势下,内存带宽、NPU算力以及系统级优化将成为衡量产品竞争力的核心指标。
此次BW2026现场,AMD展台3A24展位设置了千帧电竞区与全系产品体验区,让公众得以亲身感受这种变革。从YOGA Pro 15锐龙的专业严谨,到拯救者R9000X的热血激情,这两部新品不仅是硬件的堆叠,更是理念的创新。它们提醒我们,科技的魅力不在于参数的炫耀,而在于如何以无形的智能,助力每一个热爱与创造。

在2026年的今天,移动计算的边界已被彻底打破。无论是穿梭于都市咖啡馆的创意工作者,还是奔波于赛事现场的硬核玩家,锐龙AI Max系列所提供的端侧AI算力,正成为他们手中最得力的伙伴。这场由AMD与联想共同引领的端侧AI革命,才刚刚拉开序幕。