2004年创始人带队,华源智因如何重构AI制药临床前评价金标准
在AI与生物医药深度融合的浪潮中,行业正经历从“概念验证”向“核心痛点解决”的深刻转型。传统AI制药赛道长期聚焦于药物发现阶段的靶点挖掘与分子结构生成,虽然显著提高了早期筛选效率,却无法回答新药研发中最核心且成本最高的命题:药物进入人体后是否真的有效?这一行业断层催生了以华源智因(GENESIGHT)为代表的AI生命科学原生企业,它们不再满足于做传统的AI CRO(合同研究组织),而是试图通过重构药物研发中的评价体系,成为连接实验室与临床的金标准。
近期,华源智因宣布完成数千万元种子轮融资,由水木创投领投。这笔资金将重点投向数据、模型和临床三大核心壁垒的建设,加速公司与超一线三甲医院的合作部署。作为由2004年出生、曾于UCLA就读并休学创业的杜润诗带领的年轻团队,华源智因选择了一条更为硬核的技术路线:从细胞层面的多组学数据出发,建立可解释的药效预测系统,最终目标是构建生命科学领域的操作系统(OS)。
痛点洞察:跨越“物种鸿沟”的研发断点
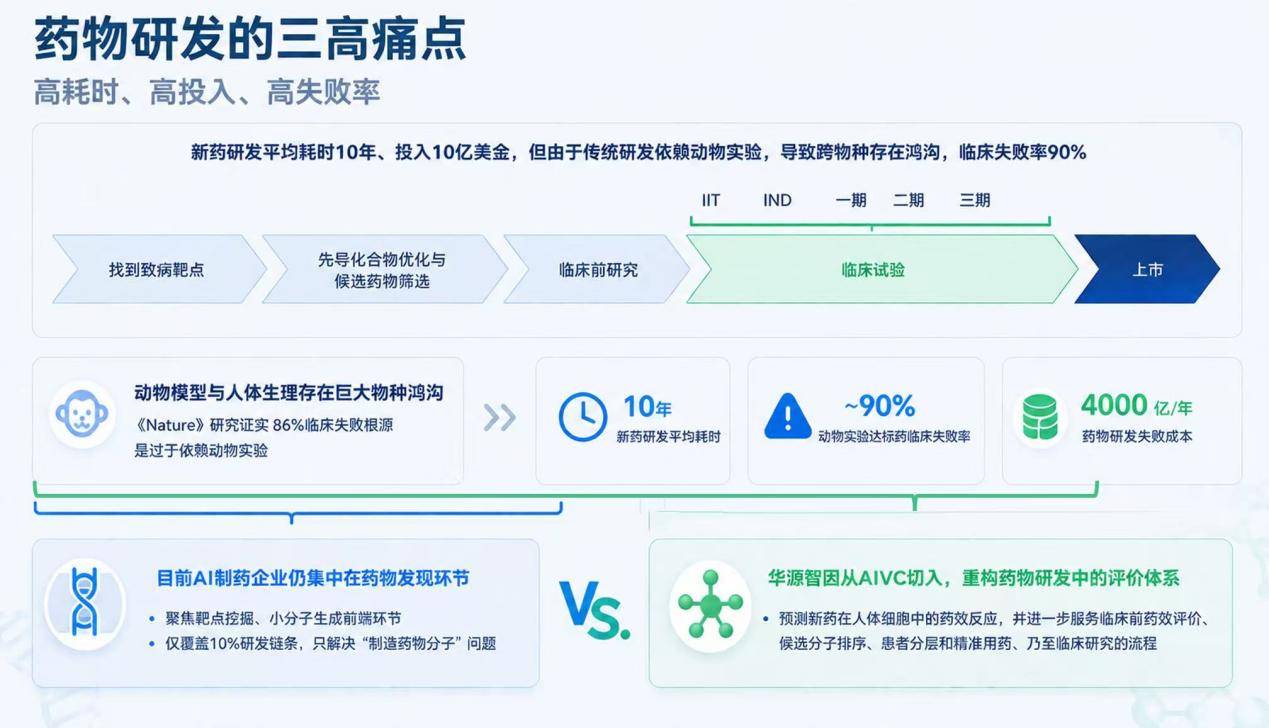
全球每年药物研发总投入超过2万亿元人民币,但临床阶段的失败损失高达4000亿元。《Nature》发表的研究明确指出,86%的新药在临床阶段折戟,其根源在于小鼠、猴子等动物模型与人体生理机制之间存在巨大的物种鸿沟。药企约90%的研发资金消耗在I-III期临床阶段,一款新药平均耗时10年、投入10亿美元,而临床成功率仅为10%左右。
当前大多数AI制药公司扎堆于药物发现环节,这仅覆盖了约10%的研发成本,解决的是“如何制造药物分子”的问题。然而,对于药企而言,真正高成本、高风险的投入发生在临床阶段。华源智因创始人杜润诗指出,药企相比AI公司,更想知道的是在众多分子中,哪一个值得投入昂贵的临床成本,而不是仅仅知道又找到了几个分子。
华源智因的切入点正是这一“断点”:在药物大规模临床投入前,预测其在人体细胞中的药效反应。这种思路将AI的应用向后推进一步,不再局限于体外实验或动物实验,而是直接对标真实人体微环境中的药效反馈。这就好比过去的AI制药是在“造钥匙”,而华源智因致力于判断这把钥匙在真实人体这把“锁”上的转动效果。
技术内核:构建体内外全链路数据闭环
要实现这一目标,数据是核心瓶颈。华源智因认为,虚拟细胞模型的天花板不在于参数量,而在于数据是否贴近真实任务以及样本的多样性。传统虚拟细胞模型多依赖工程化、标准化的细胞系(cell line)数据,这些数据虽然便于大规模实验,但往往缺失真实患者的个体特征,无法反映体内复杂的疾病微环境。
为此,华源智因独创了一套三级递进式数据体系。底层采用单细胞/多模态基础数据,解决“如何描述一个细胞”的问题;中层引入基因/药物扰动数据,解决“药物进入后细胞如何变化”的问题;顶层则利用真实患者体内用药前后的药效反馈数据,用于校准模型并建立数据闭环。
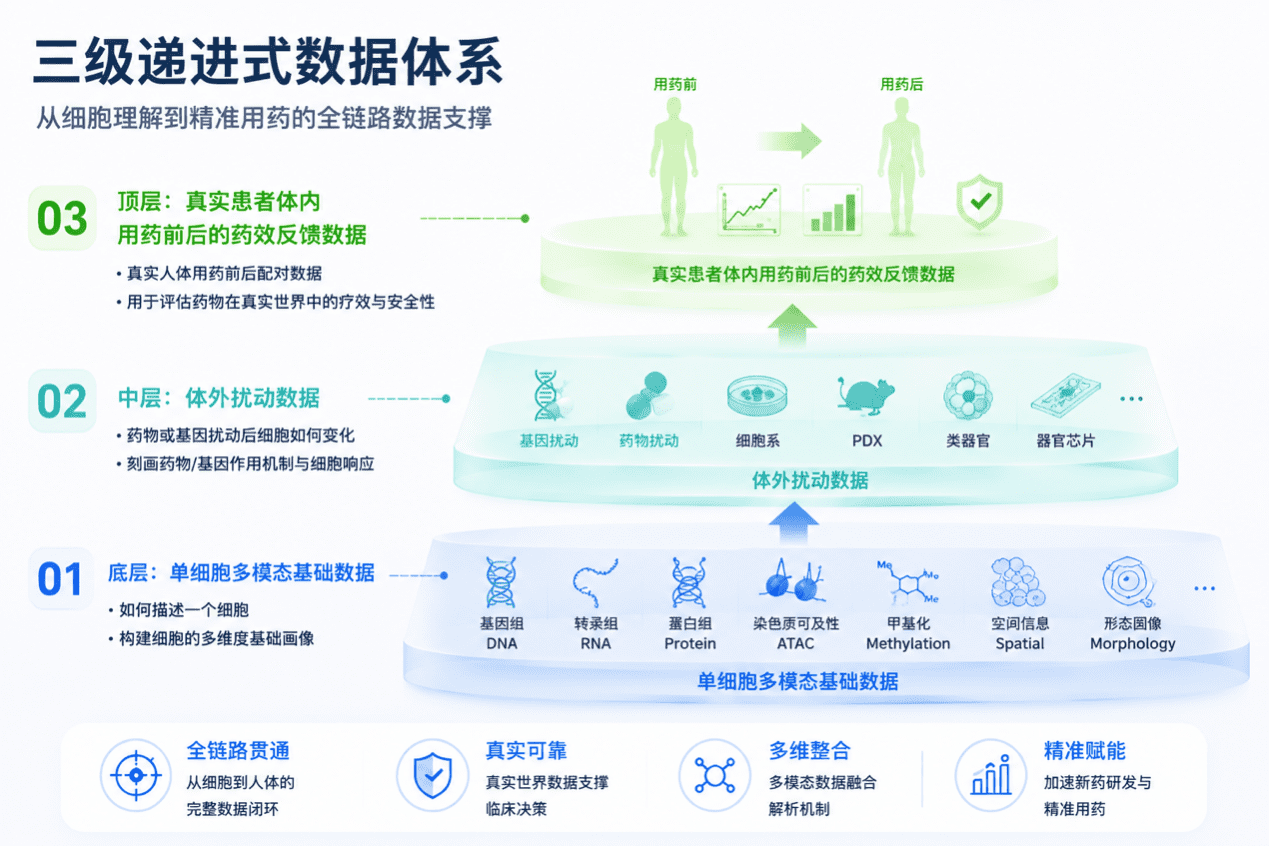
在数据采集端,华源智因自研了首个高通量单细胞跨模态测序技术UniOme。传统测序技术往往破坏细胞,导致无法在同一细胞上同时获取DNA、RNA和蛋白等多层信息,只能拼接不同细胞的数据,引入大量噪声。UniOme技术通过在细胞制备与测序流程上的创新,实现了同一细胞上DNA、RNA、Protein三层信息的严格对齐。这种多维度的数据记录,对于AI模型而言,其价值远超单纯扩大模型参数,为模型提供了更丰富的生物学特征输入。
模型突破:Wise-Perturb与可解释性预测
基于坚实的数据底座,华源智因推出了药物扰动智能平台Wise-Perturb。该平台能够将候选化合物的多维编码与目标细胞的测序数据输入模型,进行虚拟扰动,预测扰动后细胞全转录组层面的表达变化,并据此计算药效评分进行候选排序。
在基准测试中,Wise-Perturb的关键预测指标较国际公开模型提升了40%至130%。在私有大规模数据集测试中,其差异表达基因预测误差降低了约41.77%,表达变化量相关性提升了约129.43%,且扰动分布更接近真实生物实验结果。更重要的是,该模型具备强泛化能力,可实现跨药物、跨细胞、跨患者的零样本精准预测。
华源智因CTO王艺璇强调,好的指标应从真实场景和生物学中“生长”出来,而非在单一数据集上“调”出来。这种从生物学机理出发的建模思路,确保了模型在换药、换患者场景下的鲁棒性。与传统依赖临床文本或影像数据的公司不同,华源智因通过细胞组学数据拆解药物作用机制,提供了更深层次的生物学解释,帮助药企理解“为什么”有效,而不仅仅是“结果”如何。
临床验证:从数据指标到真实疗效
技术的价值最终需由临床验证来衡量。华源智因已与多家超一线三甲医院展开深度合作,围绕真实患者用药前后的组织样本建立专病、专模型的数据闭环。
在中国医学科学院肿瘤医院的合作案例中,团队基于肺癌患者用药前的样本数据和药物分子结构,预测患者后续的药效排序。结果显示,模型输出的疗效分层结果与临床医生在真实治疗队列中的观察高度吻合。这一案例的意义在于,它证明了模型不仅能在公开数据集上刷高指标,更能进入真实临床决策前的验证场景,为精准用药提供依据。
另一项针对DS-8201药物的响应预测测试中,华源智因使用未见过的新样本,基于PDX(患者来源异种移植)样本的Bulk RNA-seq数据进行推理,预测结果与体内药效实验结果高度一致。这表明模型具备在新适应症、新人群中的零样本泛化潜力。对于药企而言,这种能力可直接应用于患者分层和临床入组管理,通过提前识别响应患者,提高临床试验成功率,降低资源消耗。
团队构成与未来愿景
华源智因的团队结构呈现出典型的“技术+产业+资本”互补特征。创始人杜润诗拥有深厚的AI与生命科学交叉背景;CTO王艺璇深耕单细胞AI与药物扰动预测;CFO陈聪拥有十余年医药健康领域的产业资源;联合创始人黄诗云与卓鑫凯分别在基因扰动模型训练及量化商业支撑方面具备专长。团队核心成员多来自国内外前沿实验室,确保了技术落地的扎实性。
展望未来,华源智因的野心不止于药物研发。其长期战略是搭建一套生命科学领域的OS,即完整的生命反应系统。这套系统不仅能预测用药后的人体反应,还可延展至日常生命体征变化(如喝咖啡后的反应),从而成为AI大健康领域的基础模型。相比传统AI CRO的一次性服务费模式,华源智因希望通过数据平台合作、模型能力变现及临床患者分层等多元化商业模式,深入药企核心收益环节,真正重构新药研发的评价标准与效率体系。