具身原生重构机器人:蚂蚁灵波如何打破大模型迁移的泛化困境?
从“四肢发达”到“大脑觉醒”:具身智能的范式切换
具身智能行业在经历两年的快速狂奔后,正站在一道关键的十字路口。过去两年,我们的注意力几乎全部集中在机器人的“身体”上:灵巧手的精密咬合、电机扭矩的提升、整机设计的轻量化,以及人在春晚舞台上行云流水的舞蹈与武术表演。这些成果无疑令人振奋,它们证明了机器人本体在物理极限上的突破。然而,当这些拥有敏捷四肢的机器人真正步入工厂流水线、物流分拣中心乃至家庭客厅时,一个尴尬的现实浮出水面:它们依然显得笨拙且脆弱。
在高度标准化的预设环境中,依靠大量真机示教和模仿学习,机器人可以完美复现既定流程。但现实世界是动态且充满噪声的。传送带速度的微小波动、货架上物品的随意摆放,甚至是从未见过的新物体,都足以让依赖“死记硬背”的机器人瞬间宕机。面对动态环境、未知任务和连续交互,机器人缺乏一种能够“走一步看一步”、自主决策的底层能力。这正是当前具身智能面临的最大瓶颈——空有敏捷的四肢,却缺乏能理解物理因果、适应未知变化的智慧大脑。
资本风向标:从“造车”到“造脑”
行业的风向正在发生质变。数据是最诚实的风向标。截至2026年中旬,国内具身智能赛道融资总额约438亿元,其中超过一半的资金流向了聚焦基础模型、世界模型等智能层的企业。相反,传统机器人本体公司的融资占比已不足15%。这一资本流动的结构性变化清晰地表明:行业共识已经达成,决定机器人能力上限的不再是机械结构,而是其“大脑”是否具备处理复杂物理世界的能力。
全球科技巨头也在加速布局。英伟达推出Cosmos世界基础模型和Isaac GR00T体系,Google DeepMind发布Gemini Robotics,旨在探索从理解物理世界到执行动作的一体化能力。然而,尽管共识已成,答案却未统一。面对这一核心命题,行业迅速分化为两派:一派坚持既有大模型范式的惯性,试图通过迁移学习和微调,将互联网时代的大模型能力“嫁接”到机器人身上;另一派则坚信,物理世界与互联网文本数据的逻辑截然不同,必须从底层架构、数据分布到预训练目标进行推倒重来的重构。
蚂蚁灵波的“具身原生”:拒绝生搬硬套
在行业走向深水区的节点,蚂蚁灵波给出的答案颇具代表性。7月上旬,蚂蚁灵波连续发布六款大模型,不仅覆盖了视觉、空间、操作,更核心的是提出了“具身原生(Embodied Native)”这一全新理念,并发布了压轴之作LingBot-VA 2.0。
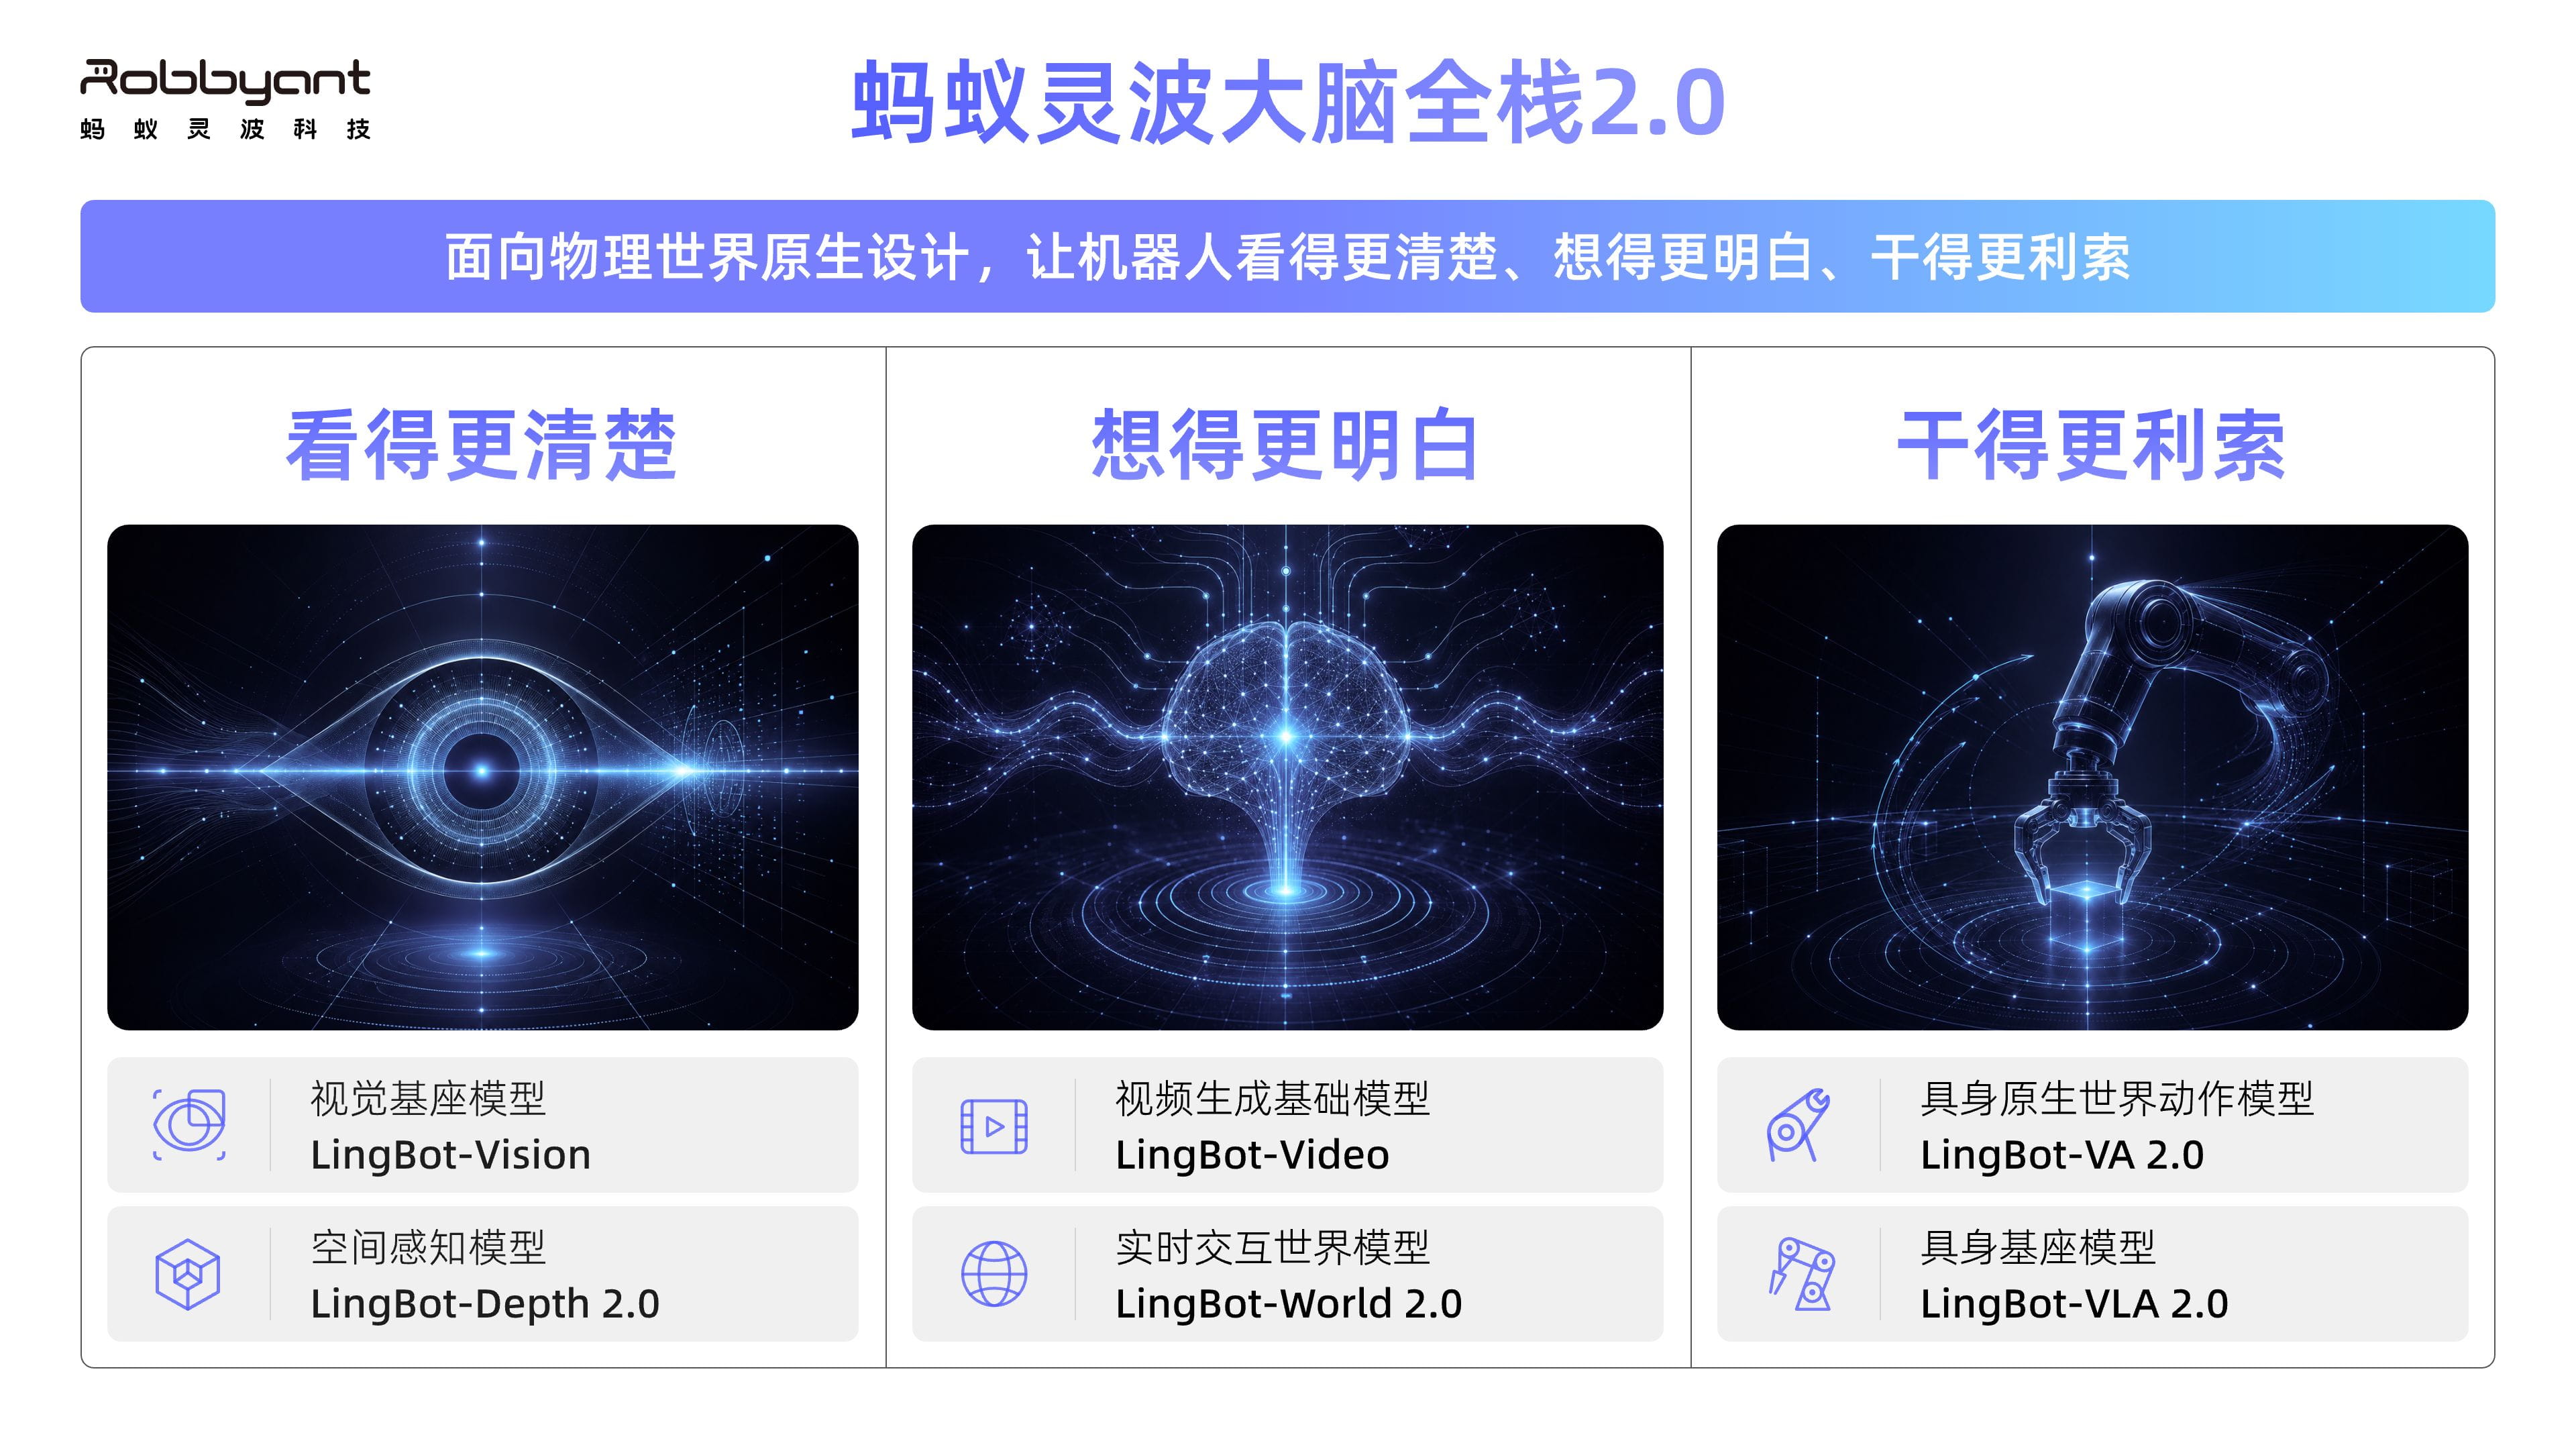
所谓“具身原生”,并非在现有通用大模型基础上修修补补,而是承认机器人是一个全新的智能体。既然学习对象从互联网的海量文本图片变成了真实的物理世界,模型的起点就必须改变。传统的大模型迁移路线,往往是将机器人视为大模型的一个应用分支,这种做法忽略了物理世界的特殊规律。具身原生理念的核心在于,从机器人需要完成的真实任务出发,重构一套基础模型。
这一重构体现在三个关键维度。首先是数据层面,模型学习的重点从文本扩展到视觉、动作和环境交互,让模型直接接触机器人工作的对象。其次是训练目标,从生成内容转向理解动作如何影响环境变化,学习物理世界中的因果关系,而非仅仅预测视觉相关性。最后是模型架构,围绕实时感知、推理和控制的严苛要求重新组织计算方式,而非简单沿用内容生成模型的发展范式。
LingBot-VA 2.0:重新定义机器人学习范式
在这一全栈技术体系中,LingBot-VA 2.0作为集大成者,展示了“具身原生”如何落地。它首先改变了机器人的学习方式。传统做法多建立在已有LLM基础上进行迁移,而LingBot-VA 2.0选择了从头预训练(Full Pre-training),以自回归视频生成模型为基础,让模型直接学习机器人与物理世界交互过程中产生的数据和规律。这种“从零开始”的方式,迫使模型直接面对真实世界的环境、动作与反馈。
更关键的创新在于学习目标的转变。传统视频模型倾向于预测下一帧画面,这与机器人的行动目标并不一致。LingBot-VA 2.0引入了因果预训练(Causal Pretrain),锁定物理合理性,让模型理解动作如何改变世界,而不仅仅是观察世界如何变化。同时,Foresight Reasoning(前瞻推理)机制的引入,让机器人在执行动作过程中持续预测未来状态,并根据环境变化不断调整决策。这意味着机器人不再等待所有计算完成后再行动,而是能够像人类一样,在动态中边看、边想、边做。
为了支撑这种实时性,LingBot-VA 2.0采用了混合专家(MoE)架构,在保证模型容量的同时提升推理效率,并将推理成本压制在实时控制线以下。此外,异步推理机制将环境观察、模型推理和动作输出解耦并行,解决了传统串行处理导致的延迟问题。最后,新一代VAE强化了语义与Action之间的对齐能力,打通了从“理解语言指令”到“执行精准动作”的最后一道鸿沟。
突破数据瓶颈与泛化难题
提出概念易,实践概念难。具身原生理念背后的深层驱动力,是机器人行业长期存在的“数据饥渴”。与大语言模型可以依靠互联网数据无限扩展不同,机器人获取真实交互数据的成本高昂且规模受限。如果无法突破这一瓶颈,机器人能力的增长将受制于数据规模。
具身原生通过重构训练范式,试图在有限数据下实现更强的泛化能力。LingBot-VA 2.0在新场景下仅需少量数据即可完成后训练适配,并在动态抓取、桌面对抗、连续操作等复杂任务中展现出优势。这种能力并非来自对特定场景的死记硬背,而是源于对物理因果和动作反馈的深刻理解。当机器人理解了“推动箱子会滑行”、“抓取纸杯需用特定力度”等隐性物理规律,它便能在面对陌生环境时,自主推断出可行的行动方案。
结语:一场关于智能本质的再思考
蚂蚁灵波提出“具身原生”并推出LingBot-VA 2.0,其意义不仅在于发布了一款新模型,更在于它尝试回答一个更底层的哲学问题:当智能的主体从虚拟世界的文本阅读器变为物理世界的行动者时,智能本身的构建范式是否应当随之改变?
这一路径是否会成为行业主流,尚需时间检验。但每一次技术范式的切换,都始于对基础问题的重新审视。当行业开始从关注“能做什么动作”转向关注“如何理解物理世界”,具身智能才真正从表演走向实用,从玩具走向工具。蚂蚁灵波的探索,为这条从感知、预测到行动的完整闭环提供了一份极具参考价值的实践样本,也预示着具身智能的下半场竞争,将从本体硬件的内卷,彻底转向底层智能架构的创新。