大模型巨头集体自研芯片:英伟达的护城河正在被谁瓦解?
算力主权的觉醒:从依赖到反叛的必然逻辑
过去三年,人工智能行业的竞争焦点几乎完全集中在模型参数的规模与算法的迭代上。然而,随着大模型从实验室走向规模化商用,竞争的底层逻辑正在发生根本性偏移。当每一句对话、每一次代码生成、每一个智能代理的调用都转化为巨大的算力消耗时,算力不再仅仅是支撑模型运行的工具,而是直接决定企业生死存亡的核心生产资料。
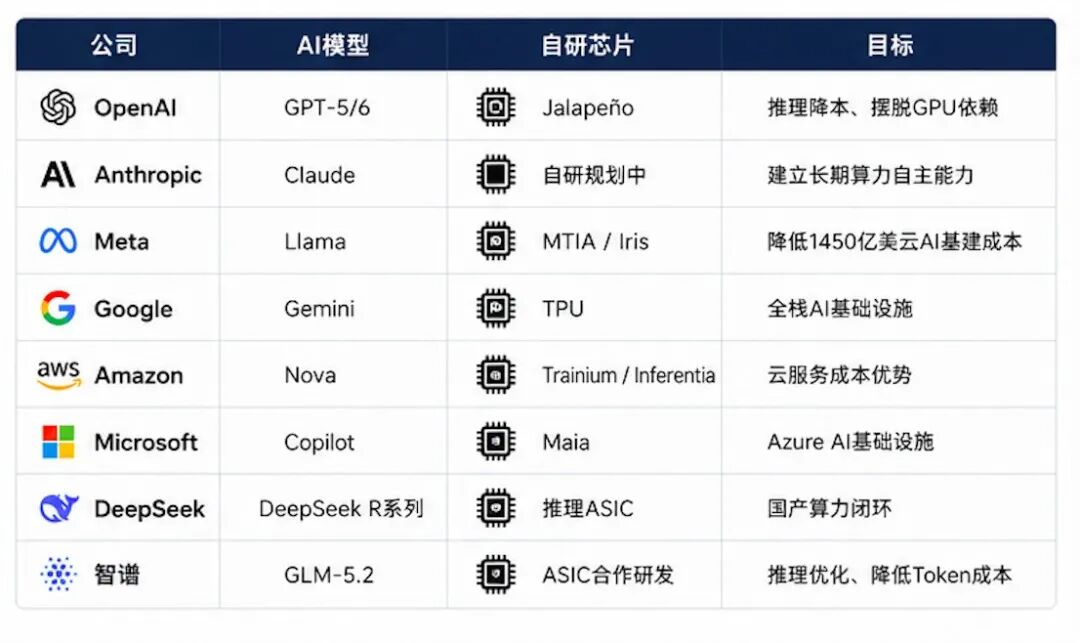
近期的一系列行业动向清晰地描绘了这一转变:Meta宣布量产自研AI芯片Iris,OpenAI发布推理专用芯片Jalapeño,DeepSeek秘密研发自研芯片并招募人才,智谱AI亦与国内厂商合作开发专用处理器。这些曾经最忠实的英伟达客户,正悄然成为其最强劲的竞争对手。这一现象并非偶然,而是AI产业成熟后的必然结果——当算力成为像电力或土地一样的基础资源时,没有任何一家头部科技巨头愿意将命脉完全交由单一供应商掌控。
这种集体“背叛”并非出于对英伟达技术的不满,恰恰相反,是因为英伟达太过成功。CUDA生态的垄断、H100与Blackwell芯片的性能标杆地位,使得整个AI产业建立在其基础之上。然而,正如Forrester分析师所指出的,依赖他人的芯片意味着永远无法成为真正的AI平台型巨头。为了掌握定价权、优化供应链安全并极致压缩成本,头部企业必须走向“模型+芯片+云”的全栈战略,重构属于自己的算力底座。
推理时代的数学题:成本即正义
要理解为何所有大厂都急于造芯,首先需要厘清AI产业中训练与推理的巨大差异。在AI早期,竞争的核心是“谁能训练出更聪明的模型”,这需要海量的算力投入进行数周甚至数月的集中训练。训练对芯片的要求极高,需要强大的浮点运算能力、超大容量的HBM(高带宽内存)以及极高的互联带宽。在这一领域,英伟达凭借其GPU集群和NVLink技术,依然拥有难以撼动的优势。
然而,AI正在全面进入推理时代。训练只发生几次,而推理每天发生数万亿次。无论是用户提问、AI Agent调用工具还是实时内容生成,每一次交互都在消耗GPU资源。此时的竞争焦点从“智能上限”转向了“成本下限”。
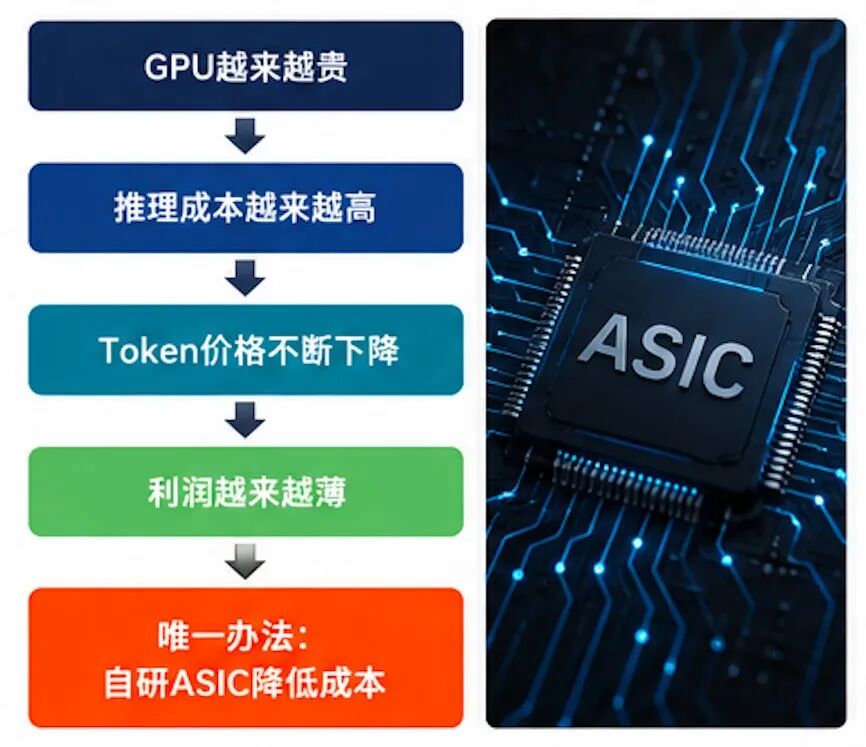
这是一个简单的数学题:假设单个Token的处理成本为0.01美元,若日调用量为100亿次,年算力成本高达365亿美元。若能将Token成本降低50%,利润空间将直接翻倍。对于年投入数百亿美元用于AI基础设施的Meta、微软和Google而言,哪怕0.001美元的成本优化,也意味着数十亿美元的利润差异。GPU采购已成为AI公司最大的固定成本,且随着HBM、光模块等上游元器件涨价,行业正经历前所未有的“芯片通胀”。自研芯片,尤其是针对推理优化的ASIC(专用集成电路),成为降低单位算力成本的最有效手段。
全栈战争:重构AI基础设施生态
当前,AI行业的竞争维度已从单一的技术指标扩展为生态系统的对抗。真正的领先者不再仅仅出售模型,而是提供一整套AI基础设施解决方案。Google拥有Gemini模型、TPU芯片、Google云平台及全球光纤网络;Meta拥有Llama系列、MTIA芯片、超大规模数据中心及社交网络入口;OpenAI则在GPT之外,布局Jalapeño芯片、Stargate数据中心以及与Oracle、SoftBank构建的算力联盟。
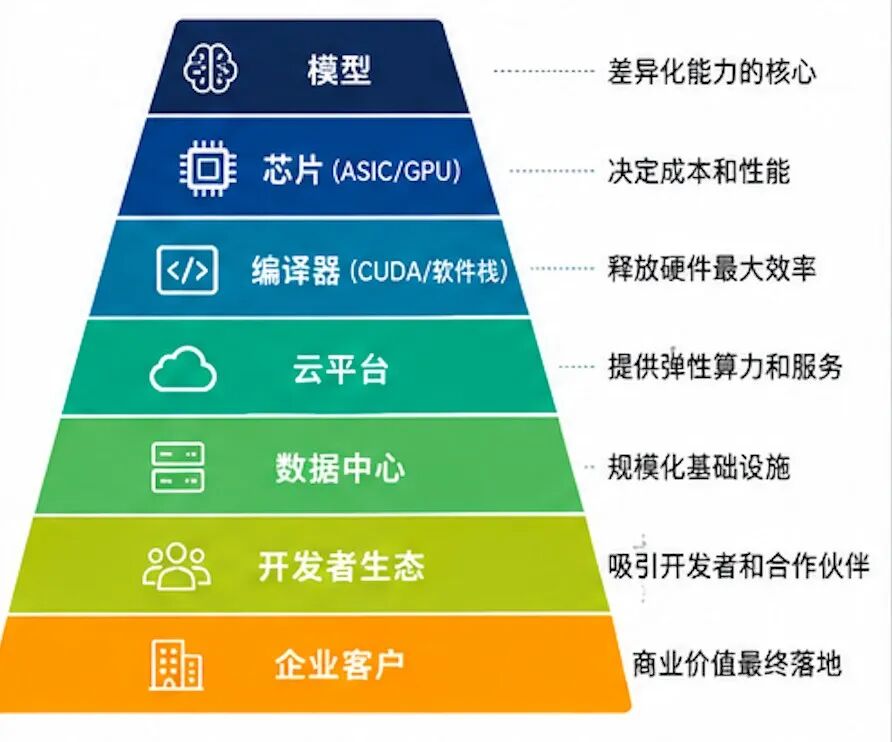
这种“全栈战略”的逻辑在于,模型只是应用层的入口,真正决定用户体验、响应速度和运营利润的是底层架构。未来的AI巨头必须掌握从芯片设计、编译器优化、软件栈开发到云平台部署、数据中心建设乃至能源供应的完整闭环。正如苹果通过A系列芯片、iOS系统和App Store构建的封闭生态所证明的,垂直整合能够带来极致的效率与体验。AI行业正在复制这一成功路径,从单项冠军的竞争转向系统级能力的较量。
在这一背景下,英伟达面临的威胁主要来自两个方面:一是超大规模客户(Hyperscalers)的自研芯片分流;二是第三方定制化芯片厂商的崛起。博通、AMD等厂商通过为巨头提供定制XPU方案,迅速抢占市场。博通第二财季半导体营收同比增长143%,成为超大规模供应链中英伟达的主要替代选择。这种“去英伟达化”趋势并非一蹴而就,而是像云计算替代本地服务器一样,缓慢但不可逆转地蚕食着英伟达最赚钱的推理业务部分。
地缘政治与国产替代:中国AI的算力突围
对于中国AI企业而言,自研芯片不仅是商业成本的考量,更是生存与发展的战略刚需。美国出口管制导致先进GPU获取受限,CUDA生态的断供风险迫使中国科技企业加速构建自主可控的算力体系。如果继续依赖海外硬件,中国AI的发展速度将始终受制于人。
DeepSeek和智谱AI等头部模型公司布局自研芯片,旨在通过软硬件协同优化,在受限硬件条件下实现性能最大化。DeepSeek通过不断优化对国产芯片的适配,实现了API价格的显著优势与性能的保持。与此同时,华为昇腾、寒武纪、沐曦、摩尔线程等国产芯片厂商正在快速迭代,逐步形成新的国产AI生态。
市场数据印证了这一趋势的猛烈程度。伯恩斯坦预测,英伟达在中国AI半导体市场的份额将从2025年的约40%骤降至2026年的8%。集邦咨询预计,以华为和寒武纪为首的国产供应商在2026年将占据中国AI服务器芯片市场近80%的份额。虽然在全球范围内,英伟达凭借Blackwell架构仍保持领先地位,但中国市场的结构性逆转已成定局。中国AI的竞争逻辑正演变为“模型+国产芯片+国产云+国产数据中心”的整体体系对抗,完整性与自主可控成为比绝对性能更关键的指标。
范式转移:训练与推理的分工重构
展望未来,AI芯片市场可能形成新的分工格局:训练领域继续由英伟达GPU主导,因其对精度、互联带宽和通用性的要求极高,且训练频次低,对单位成本敏感度相对较低;而推理领域则将逐渐被ASIC及定制化芯片占据。推理场景更关注能效比、延迟控制及部署效率,这正是ASIC的强项。
Google TPU、Amazon Inferentia以及各大厂自研芯片的成功案例已证明,专用芯片在推理任务中能以更低的功耗和成本提供相当甚至更优的性能。随着大模型规模的扩大和并发量的指数级增长,推理算力的需求将远远超过训练算力。一旦推理市场完成迁移,英伟达虽然仍能保留训练芯片的高毛利市场,但其整体增长引擎将失去一半以上的动力。
这种范式转移对英伟达提出了严峻挑战:如何在保持GPU通用性优势的同时,应对ASIC在特定场景下的效率碾压?如何在与客户既合作又竞争的关系中,维持定价权与利润率?当超级客户的清单变成竞争对手名单时,英伟达必须重新定义其商业模式的边界。它或许无法阻止行业去中心化的趋势,但可以通过开放生态、强化软件护城河以及与芯片厂商的深度绑定,在多元化的竞争格局中继续占据核心位置。
结语
AI行业的每一次技术跃迁,都伴随着底层权力结构的重塑。从云计算时代的标准化服务器,到AI时代的异构算力集群,再到如今的垂直整合全栈生态,算力主权正成为决定企业命运的关键变量。英伟达的“四面楚歌”并非危言耸听,而是产业成熟期必然出现的反垄断与去中心化浪潮。
对于整个行业而言,这种竞争并非零和博弈。头部企业的自研投入将推动芯片架构的创新,降低AI使用门槛,加速人工智能的普及。而对于观察者来说,理解“模型+芯片+云”的全栈逻辑,把握推理与训练的市场分化,洞察地缘政治对供应链的重构,是看清未来十年科技产业版图的关键。算力战争才刚刚进入深水区,新的秩序正在废墟与基石之上悄然建立。